الوكلاء · التقييم
Jev داخل حلقة الوكيل: طبقة القرار
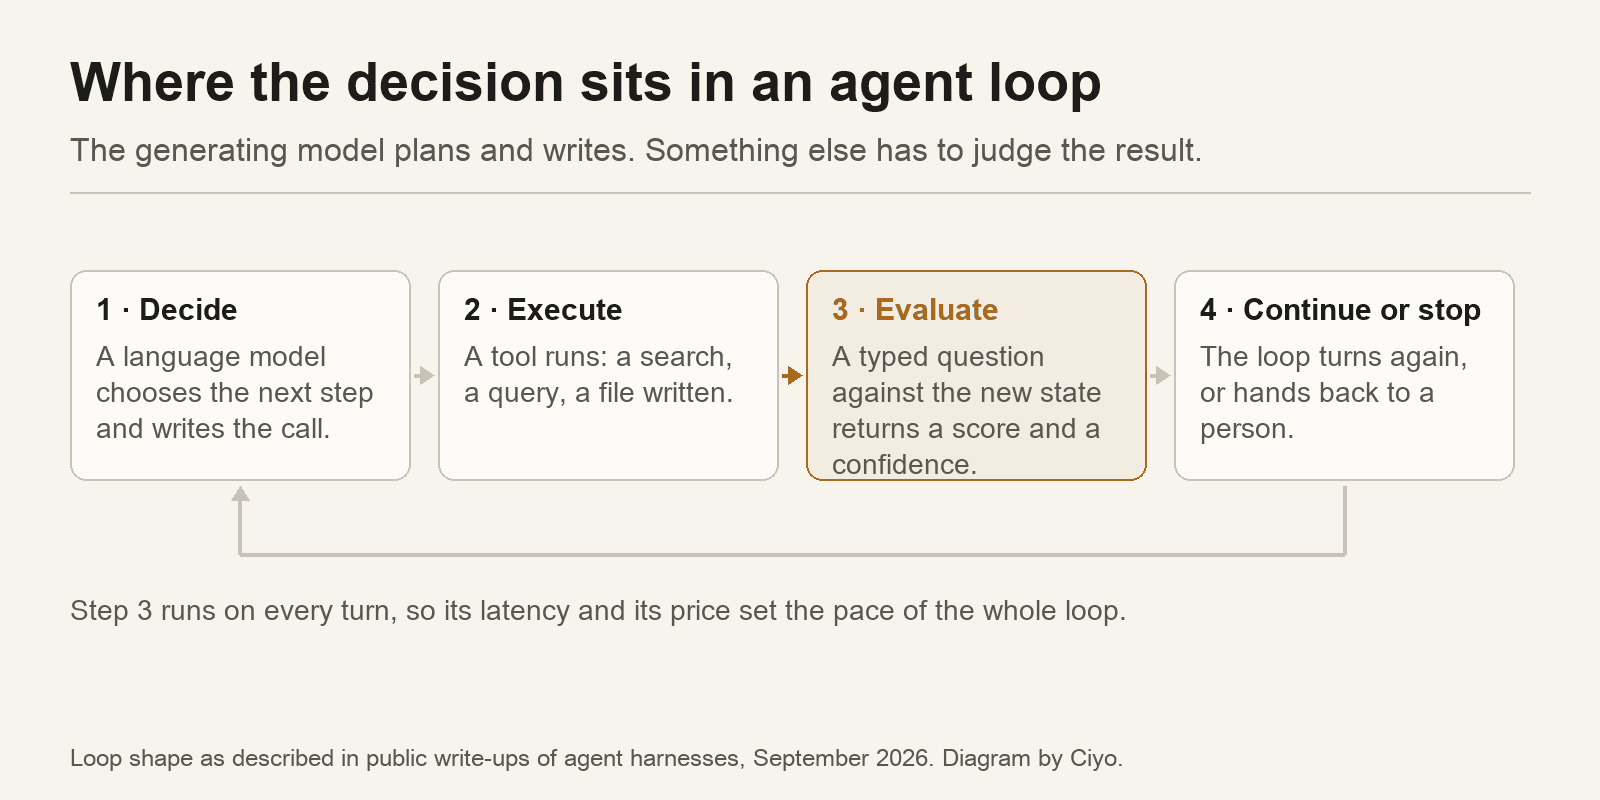
تعمل الوكلاء في حلقة. نموذج يقرر ما يجب فعله، وأداة تنفّذ، وشيء يقيّم النتيجة، ثم تدور الحلقة من جديد. تنال الخطوتان الأوليان الاهتمام. أما الثالثة فهي حيث تؤلم الهندسة عادةً.
بُني Jev، الذي أطلقته TypeSafe AI في 15 سبتمبر 2026، من أجل تلك الخطوة الثالثة ولا شيء سواها. وهذه نظرة في موضعه، وما الذي يحل محله، وما الذي قاسه فعلًا أول اختبار منشور خارج الشركة.
طريقتان تحكم بهما الفرق على خطوة اليوم
جاء التقييم البرمجي أولًا وما زال أرخص ما هو متاح. دالة تفحص هل استدعى الوكيل الأداة، وهل جرى تحليل JSON، وهل الرقم ضمن المدى. إنه سريع وحتمي وضيق: يحتاج مدخلات ثابتة، وسلوك الوكلاء ليس ثابتًا. فأن تقرر هل استخدم الوكيل نتيجة الأداة ليجيب عن سؤال المستخدم جيدًا ليس شيئًا تستطيع تعداده في عبارة شرطية.
لذلك تلجأ الفرق إلى حكَم من نموذج لغوي، يقبل الأثر غير المهيكل ويقيّمه بمطالبة. وهذا يشتري العمومية ويدفع ثمنها ثلاث مرات: في زمن الاستجابة، لأن الحكم يُكتب رمزًا رمزًا؛ وفي المال، عند كل استدعاء؛ وفي التباين، لأن الأثر نفسه قد يحصل على تقدير مختلف في تشغيلتين.
والخيار الثالث نموذج يعامل التقييم على حقيقته، أي مهمة قرار. أعطه حالة وسؤالًا ذا نوع محدد، يُعِد لك الإجابة ذات النوع مع احتمالاتها.
أين يقع نموذج System One
الخانة هي الخطوة الثالثة. إنه لا يخطط، ولا يستدعي أدوات، ولا يكتب التعليمة التالية. إنه ينظر في الحالة التي أنتجتها الحلقة للتو ويجيب عن أسئلة أعلنت إجاباتها مسبقًا.
وذلك الموضع هو أيضًا سبب أهمية زمن استجابته وسعره أكثر مما يبدوان. فالخطوة الثالثة تعمل في كل دورة، وفي الإعداد الآني قد تعمل على حصة كبيرة من آثار الإنتاج بدل عيّنة منها، وهذا بالضبط هو القرار الذي تفرضه التكلفة على الفرق عادةً.
اطرح عدة أسئلة صغيرة، لا سؤالًا كبيرًا واحدًا
الشكل الاصطلاحي ليس مطالبة واحدة تطلب حكمًا. بل حفنة من الأسئلة الذرّية، لكل منها إجاباتها المعلَنة، تُقيَّم مقابل الحالة نفسها وتُجمع في شيفرتك أنت.
يقول توثيق TypeSafe إن كل سؤال يُقيَّم بالتوازي وبمعزل عن غيره مقابل الحالة نفسها دفعة واحدة، وإن إضافة الأسئلة تكاد لا تغيّر زمن الاستجابة. فالتصميم الطبيعي إذًا مروحة من الأسئلة الضيقة: هل استُدعيت الأداة، وهل الإجابة مؤسَّسة على الأدلة المسترجعة، وكم هي مفيدة على معيار من واحد إلى خمسة، وأي من نتائج البحث الثلاث هذه يصف التشغيلة.
وكل واحد منها يعود ومعه احتمالات، ويعيش منطق الجمع حيث تستطيع قراءته واختباره وتغييره من دون أن تمس مطالبة.
ما الذي وجده اختبار منشور واحد
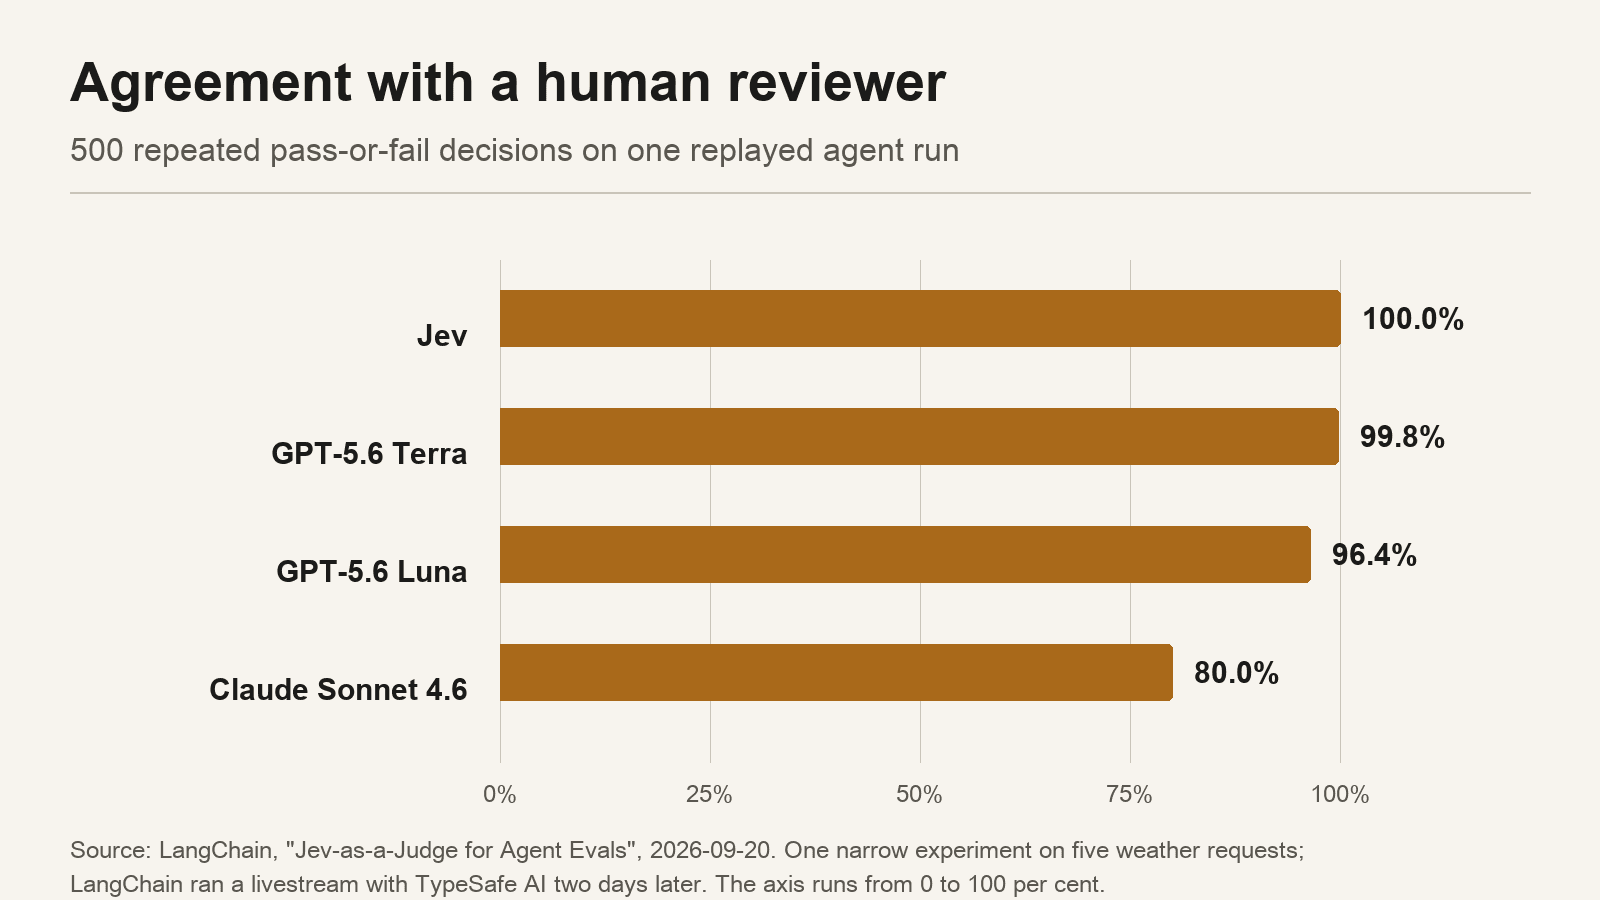
في 20 سبتمبر 2026 نشرت LangChain تجربة تستخدم Jev حكمًا وتقارنه بثلاثة نماذج لغوية على تشغيلة وكيل مُعادة التشغيل نفسها. وفي قرار النجاح أو الإخفاق الثنائي، اتفق Jev مع مراجع بشري في القرارات المتكررة كلها وعددها 500؛ واتفق GPT-5.6 Terra بنسبة 99.8 بالمئة، وGPT-5.6 Luna بنسبة 96.4، وClaude Sonnet 4.6 بنسبة 80.0.
وكانت قابلية التكرار هي النتيجة الأحدّ. ففي درجة الجودة المستمرة، بلغ متوسط تباين Jev لكل حالة 0.0000149، وهو ما تفيد LangChain بأنه أقل بمقدار 92 إلى 913 مرة من النماذج اللغوية الثلاثة. الدقة تخبرك هل يتفق الحكَم مع إنسان؛ والتباين يخبرك هل سيقول الشيء نفسه غدًا. وجهاز الاختبار يحتاج الاثنين.
وتتوخى LangChain الحذر بشأن ما لا يثبته هذا. فهي تسميها تجربة ضيقة مبنية على خمسة طلبات طقس، وتصف نتيجة التباين بأنها رصدية لا سببية، ونشرت المستودع وإصدارات المكتبات المثبّتة حتى يستطيع غيرها إعادة التشغيل. كما استضافت بثًا مباشرًا مع TypeSafe بعد يومين، وهو ما يستحق المعرفة حين تزن الكتابة.
نُشر في 2026-09-18. كتابة مطوّر عن نمط الحلقة نفسه: نموذج لغوي يقرر، وأداة تنفّذ، ونموذج يقيّم.
نمط الإخفاق الذي يستحق التصميم ضده
الحكم الرخيص يغيّر السلوك. فحين يكلّف الحكم كسرًا من السنت، تتوقف عن أخذ العيّنات وتبدأ بتقييم كل شيء، وهذا هو المقصود. لكنه يعني أيضًا أن الحكَم المخطئ في اتجاه ثابت صار مخطئًا في كل مكان، بهدوء وعلى نطاق واسع.
وتقول LangChain ذلك صراحةً: التكلفة المنخفضة قد تضخّم الأخطاء، والمقيّم المخطئ باستمرار ينتج تغذية راجعة سيئة أسرع. والتباين المنخفض يزيد الأمر سوءًا قبل أن يحسّنه، لأن الحكَم القابل للتكرار خطأٌ قابل للتكرار حتى يفحصه أحد.
والعلاج هو الممل. احتفظ بمجموعة مرجعية موسومة بشريًا، وأعد قياس الاتفاق كلما غيّرت سؤالًا، واقرأ عيّنة من الآثار التي رفضها الحكَم لا تلك التي قبلها فقط.
| الأسلوب | نقطة القوة | نقطة الضعف |
|---|---|---|
| برمجي | حتمي، شبه مجاني، قابل للتدقيق | يحتاج مدخلات ثابتة؛ ولا يستطيع الحكم على سلوك مفتوح |
| نموذج لغوي حكَمًا | يقبل الآثار غير المهيكلة؛ وعام | أبطأ وأغلى وغير حتمي عبر التشغيلات |
| نموذج System One | إجابات ذات أنواع مع احتمالات؛ قابل للتكرار؛ رخيص بما يكفي لتشغيله على كل شيء | بلا استدلال مفتوح؛ والمعيار الخاطئ صار خاطئًا باستمرار |
ما الذي تدوّنه قبل أن توصّل واحدًا
ثلاثة أمور، وليس أي منها مطالبة. الحالة: ما الذي يراه النموذج بالضبط في كل استدعاء، وبأي شكل. والأسئلة: كل سؤال ذرّي، بخياراته أو معياره مكتوبة صراحةً، لأن تلك هي الأنواع. والعتبات: ما الذي تفعله شيفرتك عند ثقة 0.9، وما الذي تفعله عند 0.55.
وتلك الأخيرة هي حيث ينقل هذا الصنف من النماذج العمل بدل أن يزيله. النموذج اللغوي يخفي العتبة داخل نثره؛ أما القرار ذو النوع المحدد فيسلّمك الرقم ويجبرك على أن تقرر. والفرق التي تحتفظ أصلًا بمجموعة تقييم موسومة ستجد هذا سهلًا. أما التي لا تحتفظ بها فستكتشف أنها كانت بحاجة إليها على أي حال.
أسئلة عن تقييم الوكلاء
هل يحل نموذج القرار محل حكَم النموذج اللغوي تمامًا؟
فقط في الأسئلة التي تستطيع إعلان إجاباتها مسبقًا. وأي شيء يحتاج شرحًا أو إعادة صياغة أو نقدًا مفتوحًا ما زال يحتاج نموذجًا مولِّدًا.
هل طرح أسئلة أكثر يكلّف وقتًا أكثر؟
يقول توثيق TypeSafe إن الأسئلة تُقيَّم بالتوازي وبمعزل عن بعضها مقابل الحالة نفسها، وإن إضافة الأسئلة تكاد لا تغيّر زمن الاستجابة.
هل الاتفاق بنسبة 100 بالمئة نتيجة معيارية؟
لا. إنها تجربة ضيقة واحدة على خمسة طلبات طقس معادة التشغيل، نشرتها شركة أجرت بثًا مباشرًا مع المزوّد بعد يومين. عاملها كنقطة بيانات أولى.
تابع القراءة
تكتب Ciyo عن النماذج التي تقف خلف أدوات الإبداع والوكلاء، وتختبر ما تستطيع تشغيله منها.