نماذج الذكاء الاصطناعي · شرح
نماذج System One: ما الذي يفعله Jev فعلًا
أطلقت TypeSafe AI نموذج Jev في 15 سبتمبر 2026 ووصفته بأنه الأول من فئة جديدة: نموذج System One، أي "فئة جديدة من النماذج المتقدمة، مبنية لاتخاذ قرارات سريعة ومهيكلة تستطيع البرمجيات استخدامها مباشرةً".
وأسهل طريقة لسوء فهم تلك الجملة أن تسمعها "نموذج لغوي أصغر". Jev ليس نموذجًا لغويًا. إنه لا يولّد نصًا، ولا يستطيع كتابة سطرك التعريفي، ولن يجيب أبدًا عن سؤال مفتوح. إنه يتخلى عن توليد النصوص عن قصد، وكل ما هو مثير للاهتمام فيه ينبع من تلك المقايضة.
فئة جديدة، وما الذي تتخلى عنه
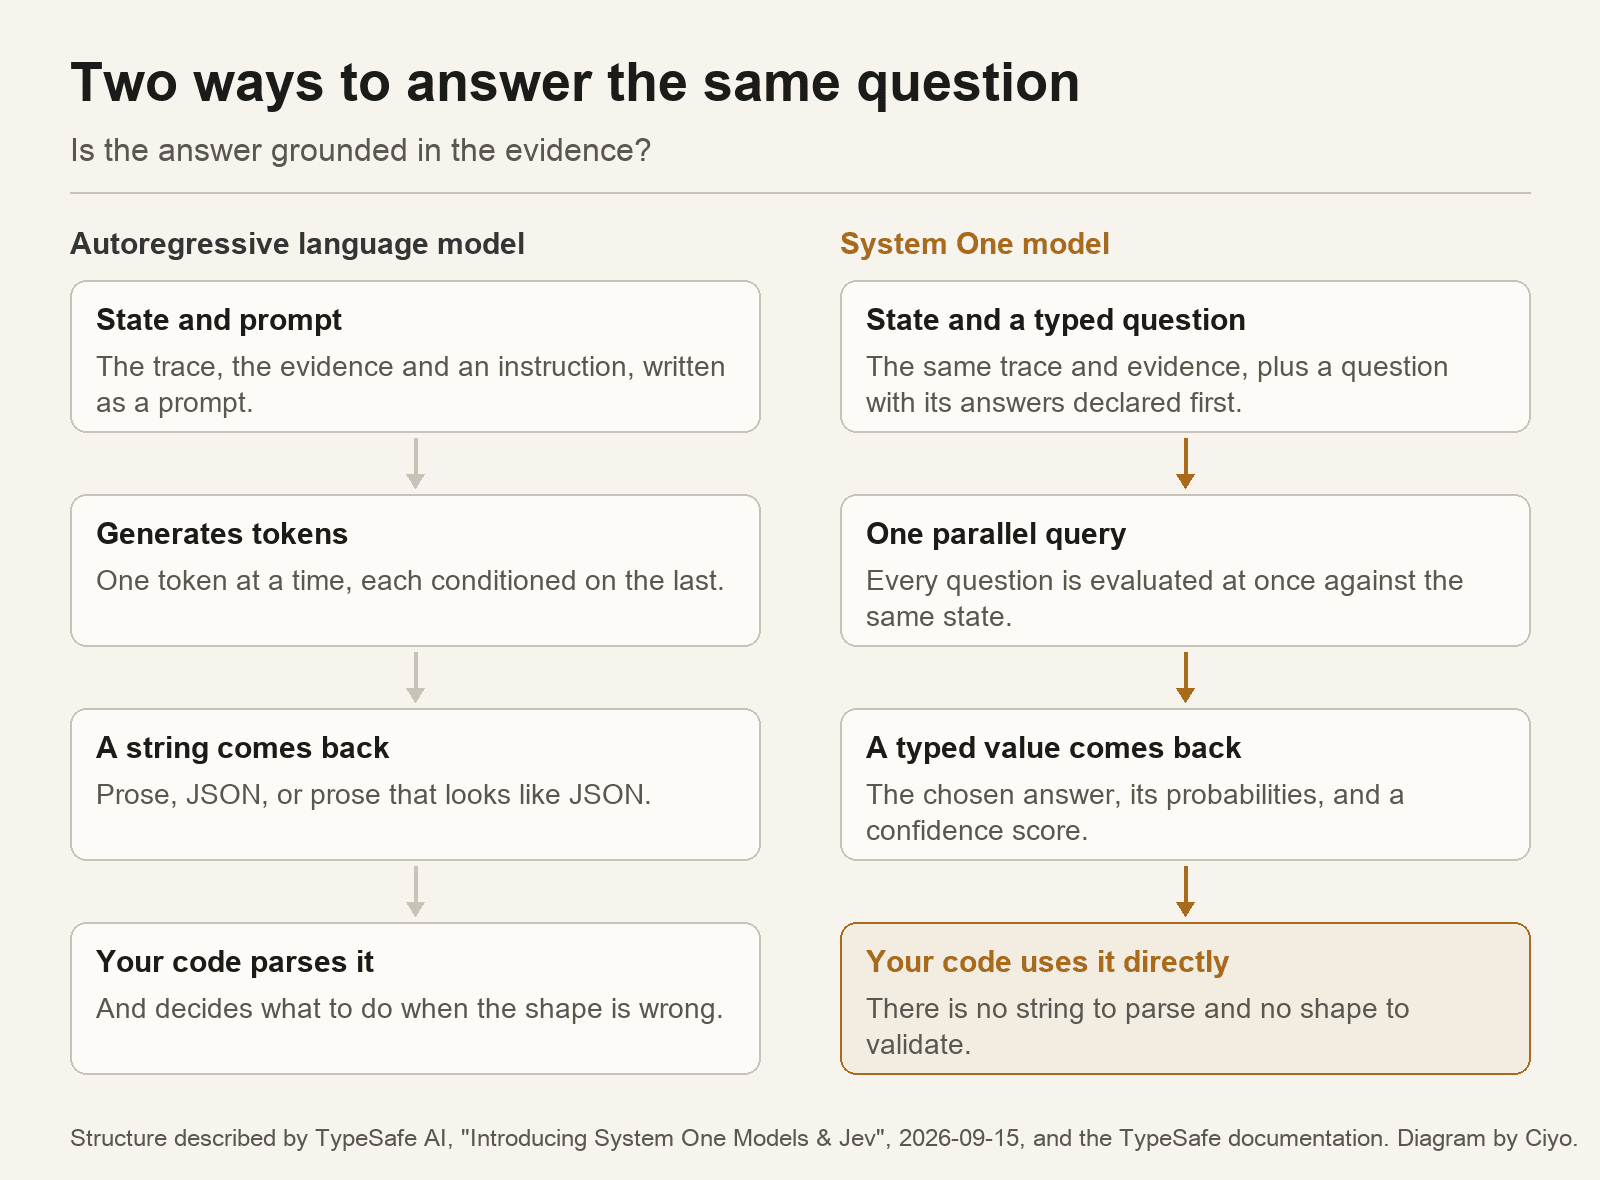
يأخذ النموذج اللغوي الانحداري الذاتي رمزًا واحدًا في كل مرة، كل رمز مشروط بسابقه، ويسلّمك سلسلة نصية. وأي بنية في تلك السلسلة إنما هي عُرف تعلّم النموذج تقليده، ولهذا ينتهي كل نظام إنتاجي يحتاج قيمة من نموذج إلى محلّل نحوي ومدقّق مخطط وإعادة محاولة.
يزيل نموذج System One تلك الطبقة بعكس الترتيب. تعلن المخرجات الممكنة أولًا، ثم تعطي النموذج حالة مهيكلة وسؤالًا ذا نوع محدد. وما يعود هو قيمة من النوع الذي أعلنته، ومعها الاحتمالات موزَّعة على الإجابات الممكنة ودرجة ثقة.
والثمن كامل: بلا نثر، بلا شيفرة، بلا رد مفتوح. وتصف TypeSafe هذا بأنه مقايضة معمارية مقصودة لا قيدًا، والاسم يقول ذلك. System One هو الحكم السريع التلقائي؛ وSystem Two هو التأمل. وJev ليس إلا الأول.
| الجانب | نموذج لغوي انحداري ذاتي | نموذج System One |
|---|---|---|
| أخذ العينات | رمز واحد في كل مرة، كل رمز مشروط بسابقه | كل المخرجات في استعلام متوازٍ واحد |
| المخرج | سلسلة نصية، ببنية تعلّم تقليدها فقط | قيمة مهيكلة آمنة النوع، معلَنة مسبقًا |
| عدم اليقين | مضمَّن في الصياغة، إن وُجد أصلًا | احتمالات موزَّعة على الإجابات، مع درجة ثقة |
| التدريب | أسلوب RLHF، مُحسَّن من أجل رد مفضَّل | أسلوب RLCD، موصوف بأنه مُحسَّن من أجل قرارات معايَرة |
| ما يتخلى عنه | لا شيء، من حيث المبدأ | توليد النصوص بالكامل |
طريقان للإجابة عن السؤال نفسه
خذ سؤالًا واحدًا محددًا يطرحه أي وكيل باستمرار: هل هذه الإجابة مؤسَّسة على الأدلة التي استرجعها؟ كلا نوعَي النماذج يستطيع الإجابة عنه. لكنهما يصلان بطريقين مختلفين، والطريق هو القصة كلها.
الطريق الأيسر مألوف. أما الطريق الأيمن فلا ينتج سلسلة نصية أصلًا، فلا شيء يُحلَّل نحويًا، ولا شيء يُتحقق منه، ولا وجود لصنف الإخفاق الذي يكتب فيه النموذج جملة معقولة تمامًا مكان الحقل الذي تتوقعه شيفرتك.
أسئلة ذرّية تُركَّب في الشيفرة
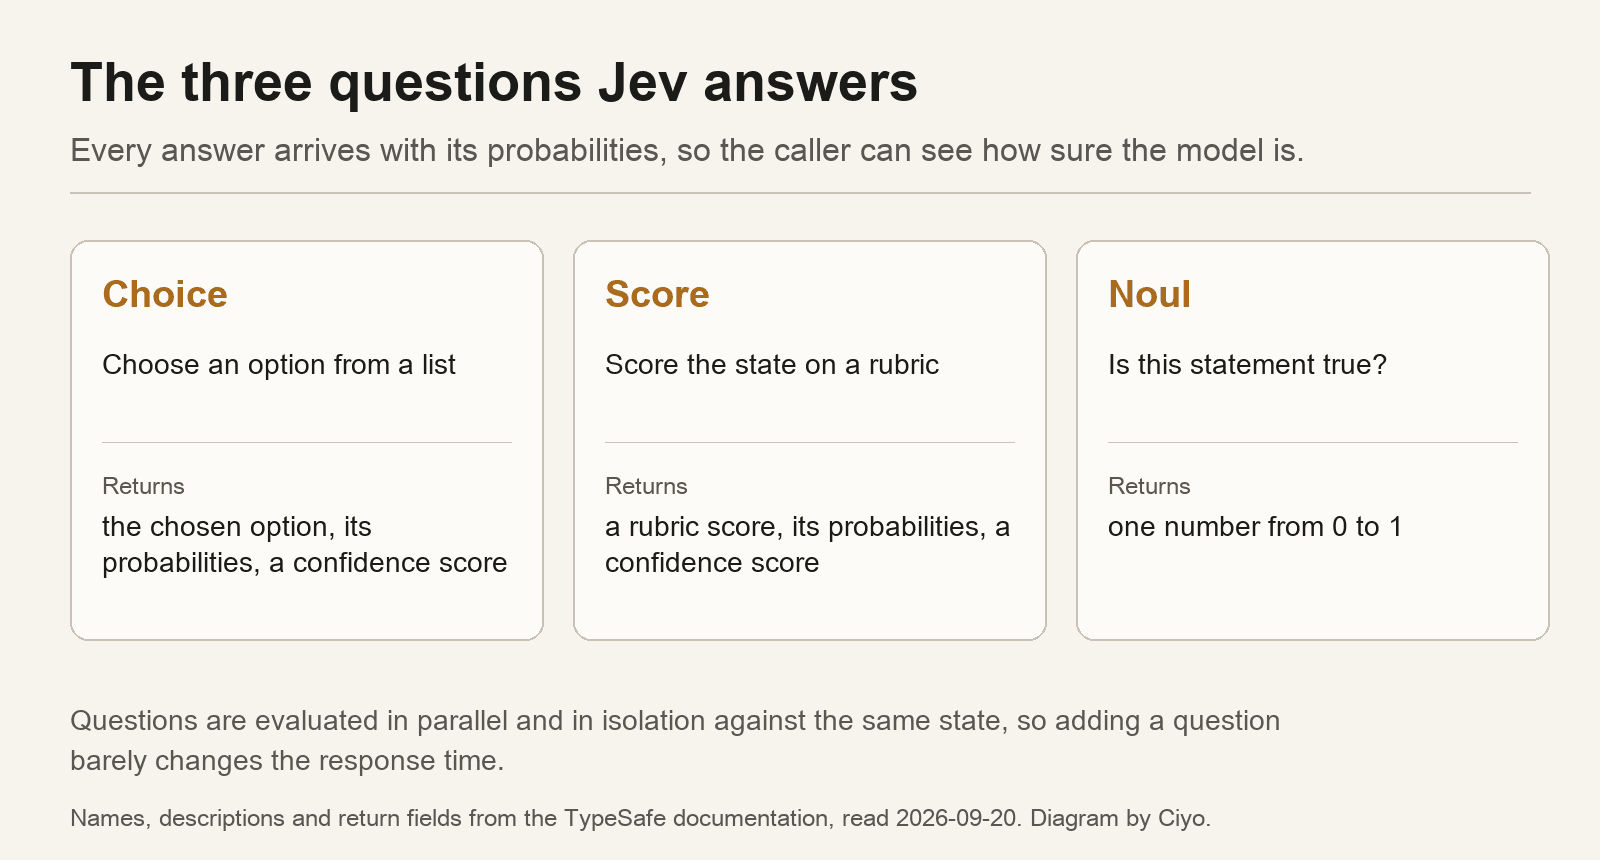
يكشف التوثيق ثلاث بدائيات لا غير. تختار Choice خيارًا من قائمة وتعيد الخيار المختار، والاحتمالات موزَّعة عليها كلها، ودرجة ثقة. وتقيّم Score الحالة مقابل معيار وتعيد الحقول الثلاثة نفسها، مع درجة مكان الخيار. وتجيب Noul عمّا إذا كانت عبارة صحيحة وتعيد رقمًا واحدًا بين 0 و1.
وقاعدة التركيب هي الجزء الذي يميل المهندسون إلى الاستهانة به. كل سؤال يُقيَّم بالتوازي وبمعزل عن غيره مقابل الحالة نفسها، دفعة واحدة، فطرح اثني عشر سؤالًا عن أثر واحد ليس اثنتي عشرة رحلة ذهاب وإياب. ويقول التوثيق ذلك بوضوح: إضافة الأسئلة تكاد لا تغيّر زمن الاستجابة.
وهذا يحوّل التقييم إلى شيء تكتبه بشيفرة عادية. فبدل مطالبة طويلة واحدة تطلب من نموذج أن يزن عدة أمور معًا ويبلّغ بصيغة JSON، تطرح عدة أسئلة صغيرة بإجابات معلَنة وتجمع النتائج بنفسك، حيث تستطيع رؤيتها.
لماذا ادعاء منع الهلوسة أضيق مما يبدو
تقول TypeSafe إن نموذج System One "لا يستطيع أن يهلوس". اقرأ ذلك بوصفه ادعاءً عن الأنواع لا عن الحقيقة. فلأن المخرجات الممكنة وبنيتها معرَّفة مسبقًا، لا يستطيع النموذج أن يعيد فئة لم تعلنها، ولا كائنًا مشوّهًا، ولا جملة واثقة عن مستند غير موجود. ذلك الصنف من العلل زال بحكم البناء.
وما يبقى هو الخطأ العادي. فقد تختار Choice الخيار الخاطئ من قائمتك. وقد تمنح Score إجابةً سيئة تقديرًا عاليًا. سيخبرك النموذج بمدى يقينه، وتصف TypeSafe تلك الاحتمالات بأنها معايَرة و"أمينة معرفيًا"، لكن قيمة 0.7 معايَرة تظل خاطئة ثلاث مرات من عشر.
ولهذا تكون قيمة الثقة جزءًا من الواجهة لا زينة. وصف مطورون نقلت عنهم TechCrunch في تغطيتها يوم 18 سبتمبر هذا التحول بالضبط: الرقم لك أنت لتفسّره، وقرار ما تفعله عند 0.55 صار مشكلة تصميم لديك لا لدى النموذج.
كيف دُرِّب، بقدر ما قيل
تسمّي TypeSafe طريقتها "التعلّم المعزَّز من أجل قرارات معايَرة"، أو RLCD، في مقابل RLHF الذي شكّل نماذج المحادثة. فحيث يُحسِّن RLHF من أجل رد يفضّله إنسان، يوصَف RLCD بأنه يُحسِّن من أجل احتمالات تعني ما تقوله.
وخارج الاسم وعقد المخرجات، المعمارية ليست علنية. وأشارت TechCrunch إلى أن المؤسس ظل متحفظًا بشأنها، وليس للنموذج أوزان مفتوحة. فمن يخبرك كيف يعمل Jev من الداخل إنما يستنتج من شكل واجهته البرمجية، لا من ورقة بحثية.
أين يعمل اليوم
الوصول عبر قائمة انتظار للوصول المبكر، مع وحدة تحكم وتوثيق على typesafe.ai. وتسرد صفحة مزوّد TypeSafe على OpenRouter الإصدارين jev-latest وjev-1.13 بسياق 32,000 رمز، لكن هذين المدخلين لا يظهران في قائمة نماذج OpenRouter العلنية، فالمسار مقيَّد لا مفتوح.
والخبر الأدل في التوزيع هو البنية التحتية. ففي 17 سبتمبر 2026 أعلنت Cloudflare أن Jev صار متاحًا على بوابة AI Gateway لديها، موصوفًا بالمفردات نفسها التي يستخدمها النموذج: أرسل حالة وأسئلة ذات أنواع، واحصل على إجابات مهيكلة تستطيع شيفرتك استخدامها مباشرةً. وهكذا يصل نموذج من هذا النوع إلى معظم الناس — لا كتطبيق، بل كاستدعاء داخل شيء تشغّله أصلًا.
نُشر في 2026-09-17. مزوّد يعلن تكامله الخاص: دليل على التوافر، لا على الأداء.
أسئلة عن نماذج System One
هل Jev نموذج لغوي صغير؟
لا. إنه ليس انحداريًا ذاتيًا ولا يولّد أي نص. إنه يقيّم سؤالًا ذا نوع محدد مقابل حالة مهيكلة ويعيد قيمة من النوع المعلَن مع احتمالات ودرجة ثقة.
ما الذي يغطيه ادعاء "لا يستطيع أن يهلوس" فعلًا؟
شكل المخرج. لا يستطيع النموذج أن يعيد فئة لم تعلنها ولا كائنًا مشوّهًا. لكنه ما زال قادرًا على اختيار الخيار الخاطئ، ولهذا ترافق قيمة الثقة كل إجابة.
هل أستطيع تجربته اليوم؟
فقط عبر قائمة انتظار الوصول المبكر، أو وحدة تحكم TypeSafe، أو تكامل مثل بوابة AI Gateway من Cloudflare. لا توجد أوزان مفتوحة، وإدراج OpenRouter ليس في واجهة نماذجه العلنية.
تابع القراءة
تكتب Ciyo عن النماذج التي تقف خلف أدوات الإبداع والوكلاء، وتختبر ما تستطيع تشغيله منها.