نماذج · System One
الخيارات التي تُعلنها هي النموذج بأكمله
مع نموذج لغوي، تنتج تعليمة سيئة جملة سيئة ويمكنك رؤيتها. مع نموذج قرار مُنمّط، ينتج سؤال سيء إجابة مُنسّقة تماماً من النوع الصحيح تماماً، ولا يمكنك رؤية أي خطأ على الإطلاق.
تلك هي المشكلة التي تستحق الفهم قبل ربط نموذج بمثل هذا في أي شيء. قطعتان من الأدلة من أسبوع 17 سبتمبر 2026 — إحداهما تقييم مسجّل مسبقاً، والأخرى تشغيل لممارس — تشيران إلى نفس النتيجة من اتجاهات مختلفة: الدقة التي تحصل عليها هي في معظمها خاصية لكيفية كتابتك للأسئلة. Ciyo لا يُشغّل Jev؛ فهو لا ينتج صورة ولا فيديو، وليس في أي من سجلّي نماذجنا.
سؤال واحد، أم خمسة
جاء أكثر الأدلة المباشرة المنشورة هذا الأسبوع من ممارس يُشغّل فرز التصيّد. عند طرحه كسؤال واحد، حققت المهمة 62.6 في المائة. عند تقسيمها إلى خمسة أسئلة منفصلة، ومُقيّمة مقابل نفس state ودمجت في الكود، حققت 95 في المائة.
ذلك تشغيل شخص واحد على بطاقاته الخاصة دون مجموعة بيانات منشورة، لذا فهو سبب لتجربة التقسيم لا رقم لتقتبسه. لكنه يتطابق مع ما توصي به وثائق الجهة المورّدة نفسها — تفكيكها إلى أسئلة ذرّية مخصّصة الغرض بدلاً من طلب حكم متعدد العوامل في سؤال واحد — ويتطابق مع شكل API، حيث تُقيَّم كل أسئلة في استدعاء بالتوازي مقابل نفس state.
تجعل الاقتصاديات اتباع النصيحة سهلاً. التكلفة التي تهيمن على الاستدعاء هي إرسال state، لا الإجابة على الأسئلة. فالسؤال عن خمسة قريب من المجاني بمجرد وجود state على الخط.
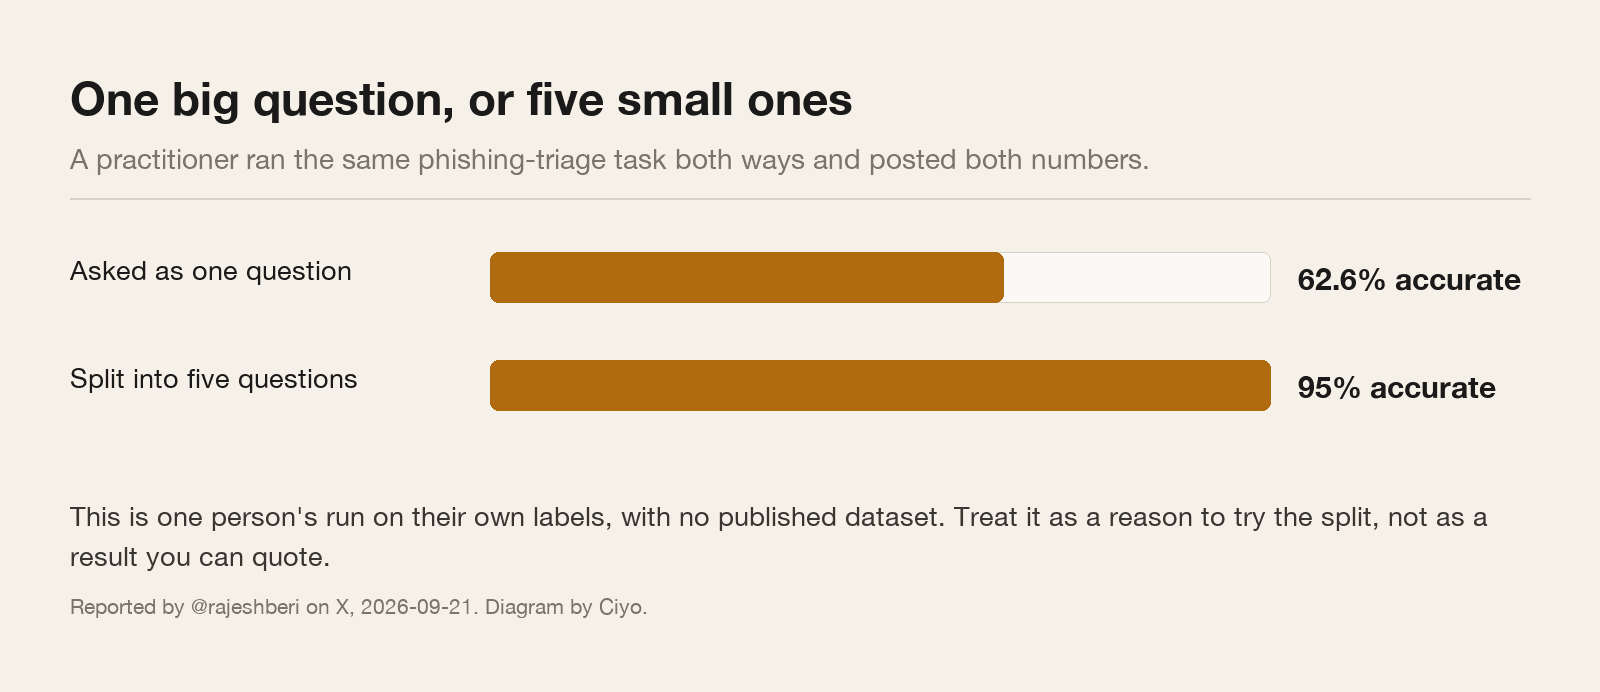
نُشر 2026-09-21. يُبلّغ الناشر كلا الرقمين من تشغيل فرز التصيّد الخاص به، ويضيف أن الاحتمالات كانت خاطئة بثقة حيث كان الجواب غير معروف حقاً، وينتهي بالنصيحة الصحيحة: اختبره في الظل على بطاقاتك الخاصة أولاً. لم تُنشر مجموعة بيانات، لذا فالأرقام هي للناشر نفسه.
كيف تقسّم سؤالاً يصعب تقسيمه
«هل هذا البريد محاولة تصيّد» استنتاج، لا سؤال. التقسيم هو أن تسأل عن الدليل الذي يجعله صحيحاً، قطعة واحدة في كل مرة، وتترك كودك الخاص يقوم بالاستنتاج.
هل يتطابق نطاق المُرسِل مع المؤسسة التي يدّعي أنها منها؟ هل يطلب الرسالة بياناً أو دفعة؟ هل هناك ضغط زمني في الصياغة؟ هل تتطابق نصوص الروابط الظاهرة مع وجهاتها؟ هل التحية عامة حيث يستخدم هذا المُرسِل عادةً اسماً؟
خمسة أسئلة ضيّقة، خمسة أجوبة بقيم ثقة خاصة بها، وقاعدة في كودك يمكنك قراءتها واختبارها وتغييرها دون لمس تعليمة. تلك الأخيرة هي الجائزة الحقيقية: تصبح منطقية الدمج برمجيات عادية.
questions: {
  "sender_mismatch": { "type": "noul", "instructions": "لا يتطابق نطاق المُرسِل مع المؤسسة التي تدّعي الرسالة أنها منها." },
  "asks_for_secret": { "type": "noul", "instructions": "تطلب الرسالة من القارئ كلمة مرور، أو رمزاً، أو دفعة." },
  "time_pressure":   { "type": "noul", "instructions": "تضغط الرسالة على القارئ ليتصرف بسرعة." },
  "link_mismatch":   { "type": "noul", "instructions": "يختلف نص رابط ظاهر عمّا يشير إليه الرابط فعلياً." },
  "risk":            { "type": "score", "instructions": "ما مدى خطورة توصيل هذه الرسالة إلى صندوق الوارد؟",
                        "criteria": ["غير ضار", "مشبوه", "مرجّح أنه تصيّد", "خبيث بوضوح"] }
}
اسم الخيار تسمية؛ والمعايير هي التعريف
يأخذ Choice خريطة `criteria` من أسماء الخيارات إلى الأوصاف، ويأخذ Score مصفوفة مرتّبة من أوصاف المستويات. تلك السلاسل ليست توثيقاً لزملائك. إنها التعريف الوحيد الذي يملكه النموذج.
«الفوترة» لا تخبره بشيء تقريباً. «يستفسر المُرسِل عن فاتورة، أو مبلغ لا يتعرف عليه، أو استرداد، أو تغيير طريقة الدفع» تخبره بما يبحث عنه. النسخة الثانية هي أيضاً التي يمكنك المجادلة بشأنها مع زميل قبل أتمتة أي شيء، وهو الموضع الذي تكون فيه الخلافات رخيصة.
اكتب المعايير بالطريقة التي تكتب بها تعليمات لشخص جديد في مناوبته الأولى: ما الذي ينتمي هنا، وما الذي يبدو مشابهاً لكنه ينتمي إلى مكان آخر، وما الذي تفعله عندما لا يكون أيّاً منهما.
الإجابة التي لا يستطيع أن يعطيها لك
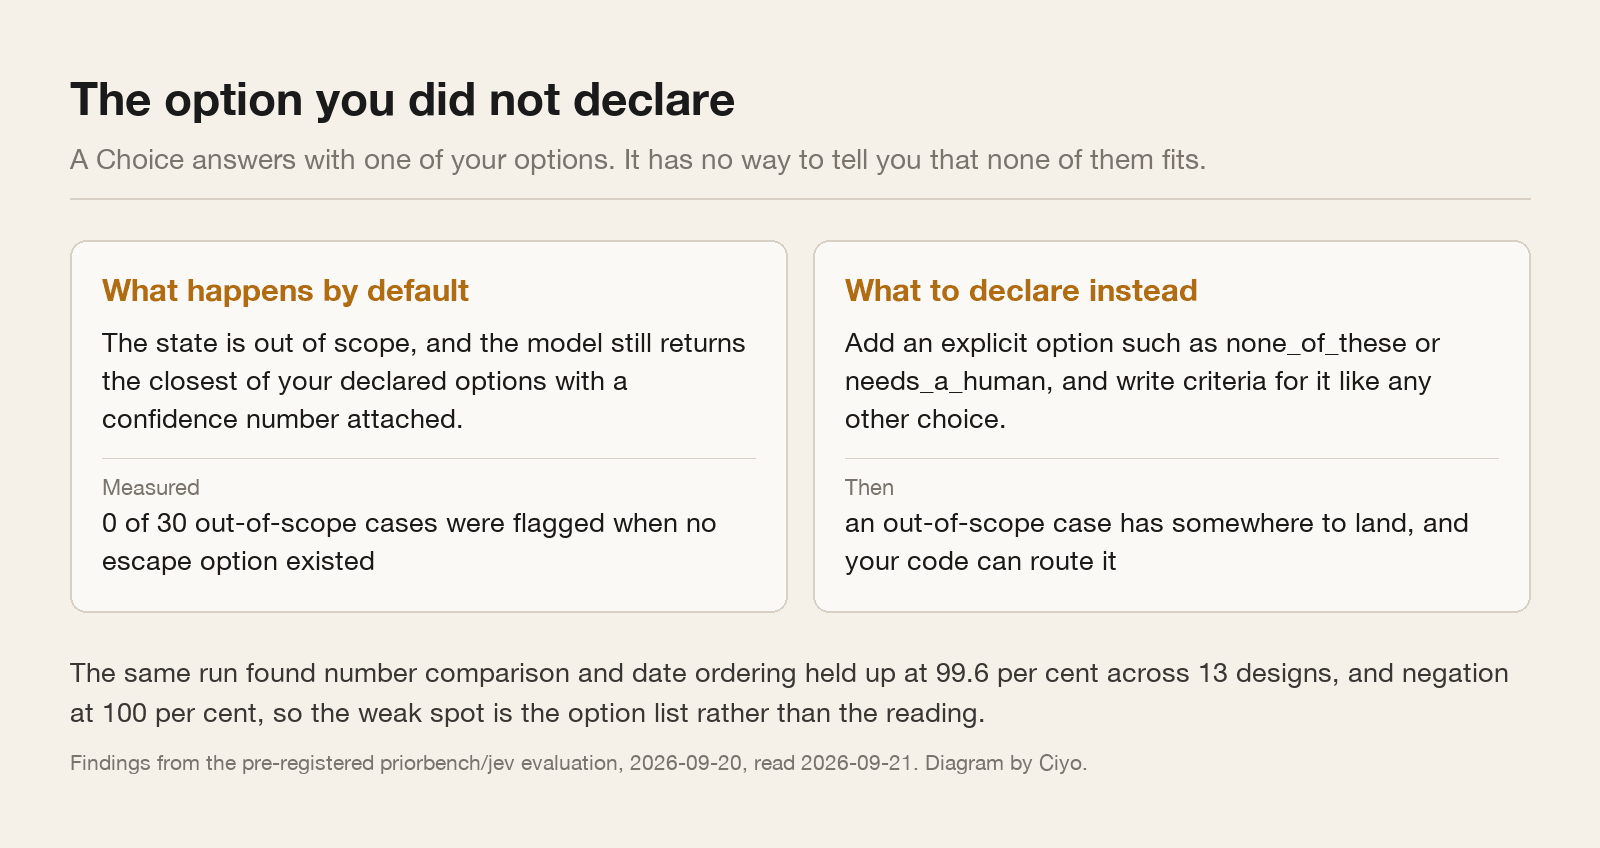
الآن الاكتشاف الأحدّ، والذي يغيّر التصميم. في التقييم المسجّل مسبقاً المنشور في 20 سبتمبر 2026، اختبر المؤلفون ما إذا كان النموذج سيلمّح بأن state سقط خارج الخيارات المُعلنة. في 30 حالة خارج النطاق حيث لم يوجد خيار مخرج، لم يُعلِم عن أي منها.
ذلك ليس عيباً. إنه نظام الأنواع يعمل تماماً كما هو معلن: لقد أعلنت الإجابات الممكنة، وعادت قيمة من النوع المُعلن. لكنه يعني أن مدخلاً خارج النطاق لا يفشل بصخب. إنه ينجح بهدوء، مع الخيار الأقرب ورقم ثقة مُلحق به.
الإصلاح سطر واحد من تصميم الأسئلة. أعلن خيار المخرج بنفسك — `none_of_these`, `needs_a_human`, `not_applicable` — واكتب معاييراً له بعناية كالخيارات الحقيقية. ثم وجّهه في الكود.
ما وجده نفس التقييم أنه جيد فيه
يستحق الأمر الإبلاغ عن النصف الآخر، لأن الفولكلور حول هذه النماذج كثيراً ما يكون خاطئاً في الاتجاه المطمئن وخاطئاً في الاتجاه المتشائم أيضاً.
وجد نفس التشغيل مقارنة الأرقام وترتيب التواريخ ثابتة عند 99.6 في المائة عبر 13 تصميماً مختلفاً للأسئلة، وتعامل النفي بشكل صحيح في 100 في المائة من الحالات المُختبرة. حذّر دليل ممارس نُشر قبل ثلاثة أيام من أن النفي قد يخطئ وأن النموذج ضعيف في الحساب والتواريخ. التشغيل الأكبر المسجّل مسبقاً لم يُعِد إنتاج ذلك.
وهو تذكير مفيد حول هذا الموضوع بأكمله في سبتمبر 2026: قدر كبير من النصيحة الواثقة يتداول حول نموذج ظلّ عاماً لفترة تقل عن أسبوع. فضّل الدليل ذا المنهج والمستودع المُرفق.
| ادعاء | المصدر | ما وجده التشغيل المسجّل مسبقاً |
|---|---|---|
| ضعيف في حساب الأرقام والتواريخ | دليل ممارس، 2026-09-17 | ثبتت مقارنة الأرقام وترتيب التواريخ عند 99.6 في المائة عبر 13 تصميماً |
| قد يخطئ النفي | نفس الدليل | تُعامل النفي بشكل صحيح في 100 في المائة من الحالات المُختبرة |
| تعفّن السياق: تقل الدقة مع state غير ذي صلة | نفس الدليل | لم يُعارَض هنا؛ يستحق الاختبار على state الخاص بك |
| يقرأ التعليمات حرفياً | نفس الدليل | متسق مع نتيجة خارج النطاق: يجيب عن السؤال الذي كتبته |
قائمة تحقق قبل ذهاب سؤال إلى الإنتاج
هل هو ذرّي؟ إذا احتوت الجملة على «و» أو «إلا»، فهي على الأرجح سؤالان.
هل الخيارات شاملة، بما في ذلك مخرج؟ إذا لم يكن لمدخل محتمل مكان يهبط فيه، فسيهبط في مكان خاطئ.
هل لكل خيار معايير؟ اسم الخيار تسمية؛ والمعايير هي التعريف، والنموذج يملك فقط ما كتبته.
هل الروبريك مرتّب؟ يتوقع Score مستويين إلى عشرة مستويات ذات معنى في تتابع، ويمكن للدرجة المُعادة أن تهبط بينها.
هل قِسته مقابل بطاقاتك الخاصة؟ كل رقم في هذه المقالة جاء من مهمة شخص آخر.
أسئلة حول تصميم الأسئلة
لماذا يُعد تقسيم السؤال أفضل؟
تُقيَّم كل أسئلة في عزلة مقابل نفس state، لذا فالسؤال الضيّق مهمة ضيّقة. ثم تعيش منطقية الدمج في كودك، حيث يمكن اختبارها. انتقل تشغيل ممارس واحد من 62.6 إلى 95 في المائة على بطاقاته الخاصة بعد التقسيم.
هل تكلّف الأسئلة الأكثر مالاً أكثر؟
القليل جداً. التكلفة المهيمنة هي state الذي ترسله؛ تُقيَّم الأسئلة بالتوازي مقابله.
ماذا يحدث لمدخل لا يناسب أي من خياراتي؟
يحصل على الخيار الأقرب على أي حال. وجد تقييم مسجّل مسبقاً أنّ 0 من 30 حالة خارج النطاق مُعلَّمة عندما لم يُعلَن خيار مخرج. أعلن واحداً.
هل هو ضعيف في التواريخ والنفي؟
قال دليل ممارس ذلك في 17 سبتمبر 2026. قاس التشغيل المسجّل مسبقاً الأكبر بعد ثلاثة أيام 99.6 في المائة في ترتيب الأرقام والتواريخ و100 في المائة في النفي. اختبره على بياناتك الخاصة بدلاً من الوثوق بأي منهما.
واصل القراءة
يكتب Ciyo عن النماذج وراء الأدوات الإبداعية وأدوات الوكلاء، ويختبر التي يمكنه تشغيلها.