モデル · デザイナー向け
人の手から下ろしてよい 4 つの確認
先月の価格のまま世に出てしまう投稿は、才能の失敗ではありません。最後の 5 分の失敗です。もう一度読むはずだったのに、読まなかった。ほかに 11 本の投稿が待っていたからです。
文案の確認は、マーケティングの仕事のなかでもっとも自動化しやすいのに、もっとも自動化されていない仕事です。つい最近まで選べたのが、細かいことを何も拾わない正規表現か、火曜になると答えの変わる言語モデルしかなかったからです。2026 年 9 月 15 日 に公開されたモデルは、あらかじめ宣言した質問に、型のついた値と信頼度で答えます。Ciyo は Jev を実行できません。画像も動画も作らず、どちらのモデルレジストリにも載っていないからです。それでも以下の 4 つの確認は、最終的に何が走らせるにせよ、組んでおく価値があります。
なぜ文案が自動化にいちばん向いているのか
この種のモデルはテキストしか読みません。TypeSafe のドキュメントには、送る内容は文字列、JSON オブジェクト、またはテキスト値の配列でなければならず、画像はまだ対応していないと書かれています。
たいていのクリエイティブの仕事にとって、それは重い制限です。ところが文案の確認にとっては、まったく制限になりません。文案はもともとテキストだからです。スタジオの仕事のなかで、モデルの境界と仕事の形がぴたりと重なるのは、ここだけです。
ですから意思決定モデルは、そのポスターが良いかどうかは言えません。けれども毎回、すべての投稿について、1 秒とかからずに、キャプションに価格が書かれているか、法務が削った語を使っていないか、取り決めた広告表示が付いているかを言えます。
4 つの確認
これらはそれぞれ独立した質問で、固有の宣言済みの答えを持ちます。ここが大事なところです。4 つを1つにまとめた質問は、4 つの絞った質問を別々に投げるより成績が悪く、しかも 4 つはどのみち同じテキストに対してまとめて評価されます。
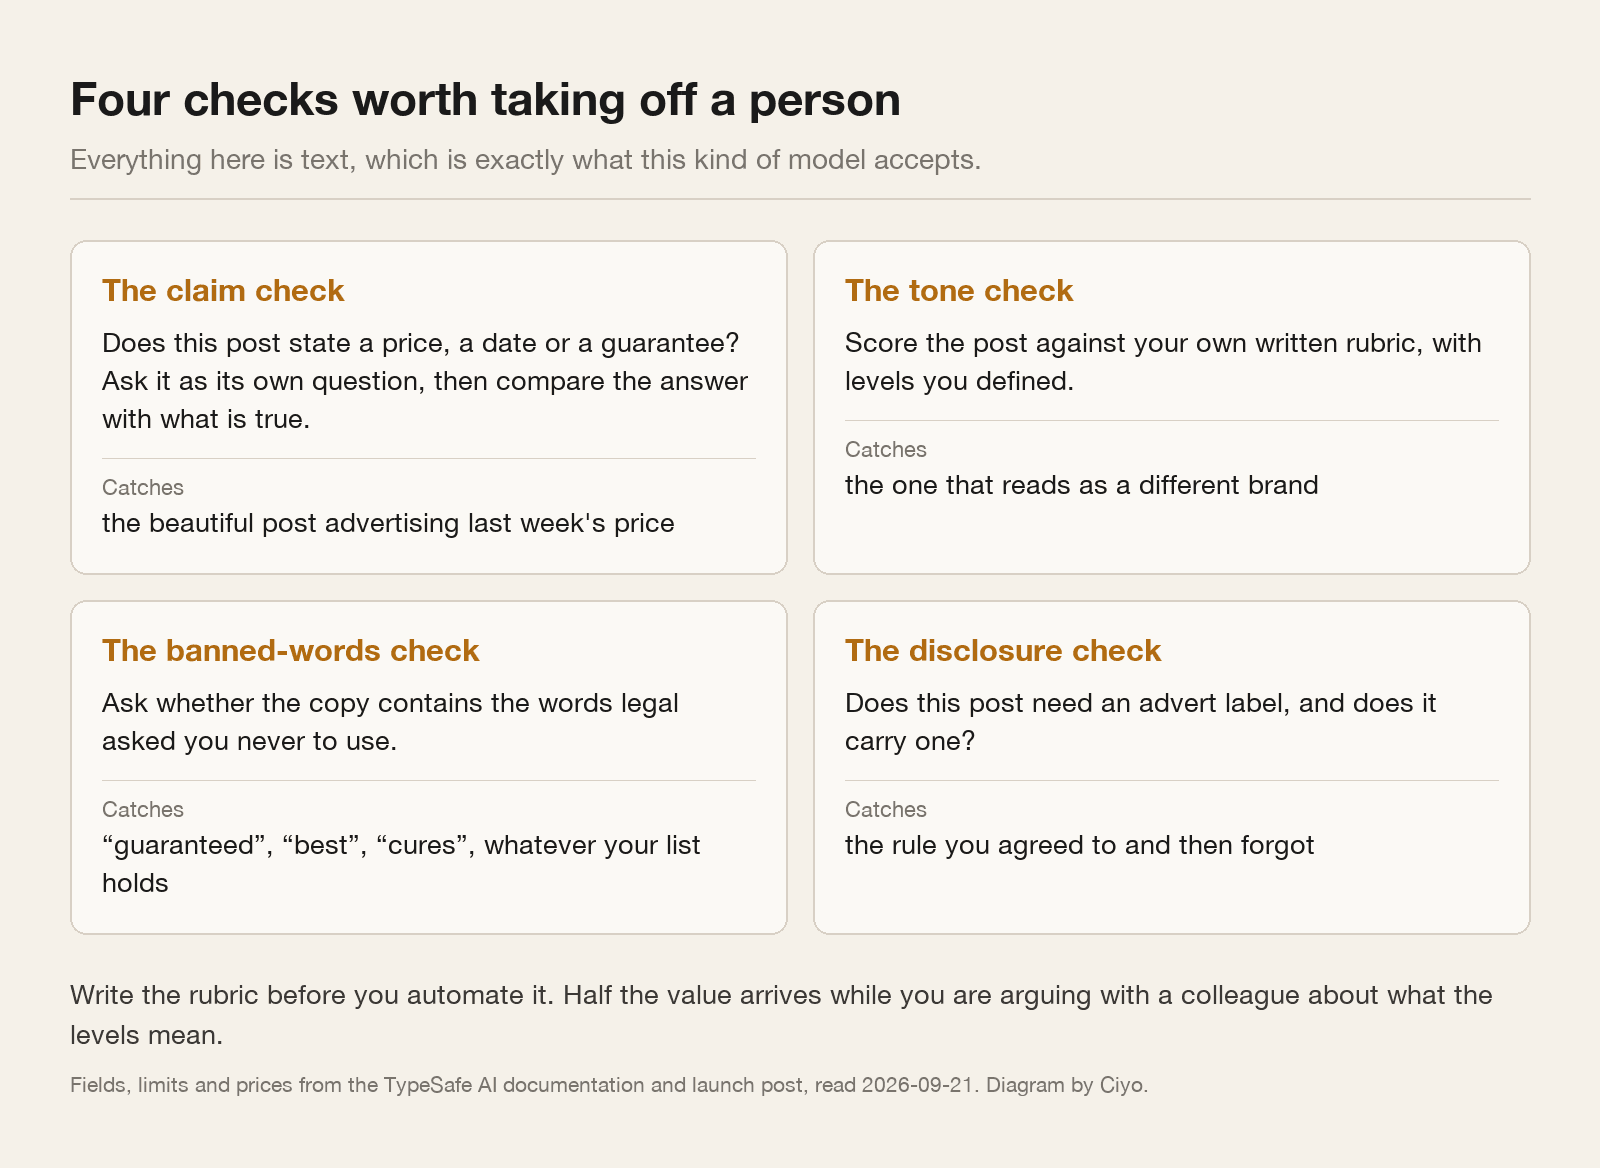
元が取れるのは、主張の確認だけです
ほかの項目は、恥をかかないように守ってくれます。これは返金の列から守ってくれます。
主張が本当かどうかを尋ねてはいけません。モデルには確かめる手段がないからです。尋ねるべきは、その文案がそもそも検証できる主張をしているか、そしてそれがどの種類かです。そのうえで、その答えを手元の事実と突き合わせてください。
具体的にはこうなります。この投稿は価格を書いているか。日付や期間を書いているか。結果を約束しているか。割引の名前を挙げているか。4 つの「はい/いいえ」を 1 回の呼び出しで答えさせ、「はい」が付いた投稿はすべて、該当する事実を隣に並べて人間に回します。モデルは何も検証しません。確認が要る文を見つけ出すだけです。そして、人が飛ばしてしまうのが、まさにその工程です。
questions: {
  "states_a_price":    { "type": "noul", "instructions": "コピーが特定の価格または金額を述べている。" },
  "states_a_date":     { "type": "noul", "instructions": "コピーが日付、曜日、または期間を述べている。" },
  "promises_a_result": { "type": "noul", "instructions": "コピーが読者に何らかの結果を約束している。" },
  "banned_wording":    { "type": "noul", "instructions": "コピーが state で与えた禁止語リストのいずれかを使っている。" },
  "needs_ad_label":    { "type": "noul", "instructions": "これは有料またはスポンサー付きの内容で、表示ラベルが必要である。" },
  "tone":              { "type": "score", "instructions": "自社のブランドの語り口にどれだけ近いか。",
                         "criteria": ["ブランドから外れている", "ほどほど", "ブランドに合っている", "申し分ない"] }
}
最後に人が見るもの
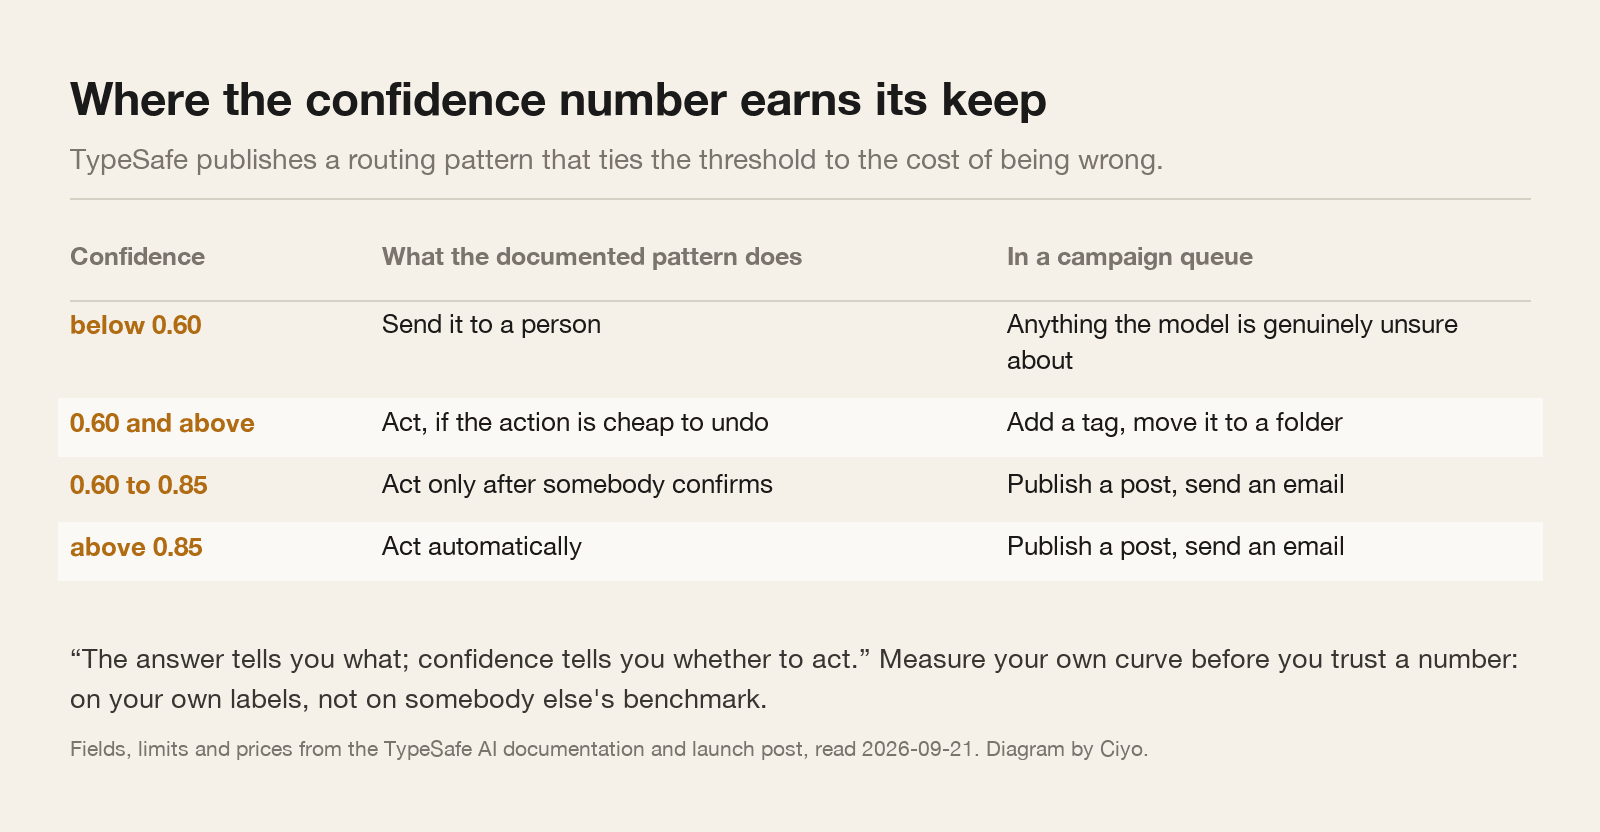
確認の仕組みを業務の流れに変えるのは、信頼度の値です。TypeSafe は、しきい値をモデルではなく間違いのコストに結びつけるルーティングのパターンを公開しています。0.6 未満は人間へ、0.6 以上は安くて取り消せる操作へ、高くつくものには 0.85 か確認の一手を、という形です。
公開待ちの列には、これがきれいに当てはまります。タグを付けるのは取り消せるので、低い基準で構いません。4 万人にメールを送るのは取り消せないので、高い基準と、それに署名する人の名前が要ります。
どの数字を選ぶにせよ、自分の投稿で測ってください。上のしきい値は文書化された出発点であって、あなたのブランドについて分かったことではありません。
本当の仕事は、評価軸のほうです
4 つのうち 3 つは機械的で、半日あれば終わります。語り口の確認だけは違っていて、そしてきちんとやる価値があります。
スコアには段階が、段階には定義が要ります。「ブランドに合っている」は定義ではありません。「短縮形を使い、読者をあなたと呼び、最上級を使わず、疑問文で始めない」なら、これは定義です。
その定義は、ブランドの語り口を預かっている人と一緒に書いてください。そして会話が気まずくなることを覚悟しておいてください。多くのチームはこの時点で、二人が一年のあいだ別々のルールを当てていたことに気づきます。その発見は自動化よりも価値があり、たとえ一度も確認を走らせなくても、あなたの手に残ります。
| 確認 | 拾うもの | 用意の手間 |
|---|---|---|
| 主張 | 間違った価格、先月の日付、守れない約束 | 1 時間 |
| 禁止語 | 法務が削り、みんなが忘れた語 | 20 分、それに語のリスト |
| 表示 | 有料の投稿に広告表示が付いていない | 1 時間、それに各チャネルの規則を知ること |
| 語り口 | 別のブランドのように読める文案 | 1 日。その大半は評価軸の議論 |
本番に出す前に
すでに公開した投稿を 50 本取り、自分でラベルを付けてください。その 50 本に確認を走らせ、突き合わせます。その一致率だけが、何かを語ってくれる数字です。提供元のベンチマークが語るのは、他人の仕事についてです。
そのうえで、いまのやり方の脇で 2 週間、静かに走らせ、何にフラグを立て、何に立てなかったかを読んでください。決まった方向に間違える仕組みは、抜き取りではなくすべての投稿で間違えるようになります。費用が安いことは、良くなる前にいったん事態を悪くします。
そして、書いたすべての選択肢に逃げ道を宣言してください。2026 年 9 月 20 日 に公開された事前登録の独立評価では、「どれも当てはまらない」を用意しなかった場合、範囲外の 30 件の入力のうちフラグが立ったものは1件もありませんでした。モデルはただ、最も近い宣言済みの答えを選んでいました。
文案の確認についての質問
主張が本当かどうかを教えてくれますか
いいえ。文案が主張をしていること、そしてその種類を教えてくれます。それを事実と突き合わせるのは引き続きあなたの仕事ですが、確認が要る文を見つけ出すことこそ、人が飛ばしてしまう工程です。
単語リストより良いのですか
禁止語については、ほとんど変わりません。語り口、主張、表示についてはまったく別物です。これらは一致ではなく判断を要するからです。
どのしきい値で公開すべきですか
公開されているパターンは、安くて取り消せる操作に 0.6 を、高くつく操作に 0.85 を当てています。どちらの数字を信じる前に、自分の投稿で自分の曲線を測ってください。
Ciyo はこれらの確認を走らせますか
いいえ。Ciyo は Jev を実行しません。Ciyo のエージェントは GPT-6 Astra を使い、書かれた基準に照らして投稿をレビューできます。それは別の種類の確認です。型がついて繰り返せる値ではなく、文章による推論です。
続きを読む
Ciyo は、クリエイティブツールやエージェントツールの背後にあるモデルについて書き、実行できるものは実際に試しています。