新模型 · 實測
GPT-6 Sol 或 Luna 能生成圖片嗎?
OpenAI 在 2026 年 9 月 22 日發布了 GPT-6 Sol 與 GPT-6 Luna。多數人輸入的第一個問題,是它們能不能做圖。老實的答案分成兩半:模型本身只寫文字,但包在模型外面的應用程式仍可能交給你一張圖。
我們在 9 月 23 日用一份虛構的工作——為一家社區麵包店做新品上市貼文——測了這兩半,並拿同一個問題去問同一天發布的 Claude Opus 5.5。結果決定了每個模型在做圖流程裡該放在哪個位置。
簡短的答案
OpenAI 的模型頁面為這兩個新模型列出的內容一樣:輸入文字與影像,輸出文字。兩個模型都不畫像素。當開發者在 Responses API 裡開啟影像生成工具時,兩者都能呼叫它,但動手畫圖的是另一個模型。
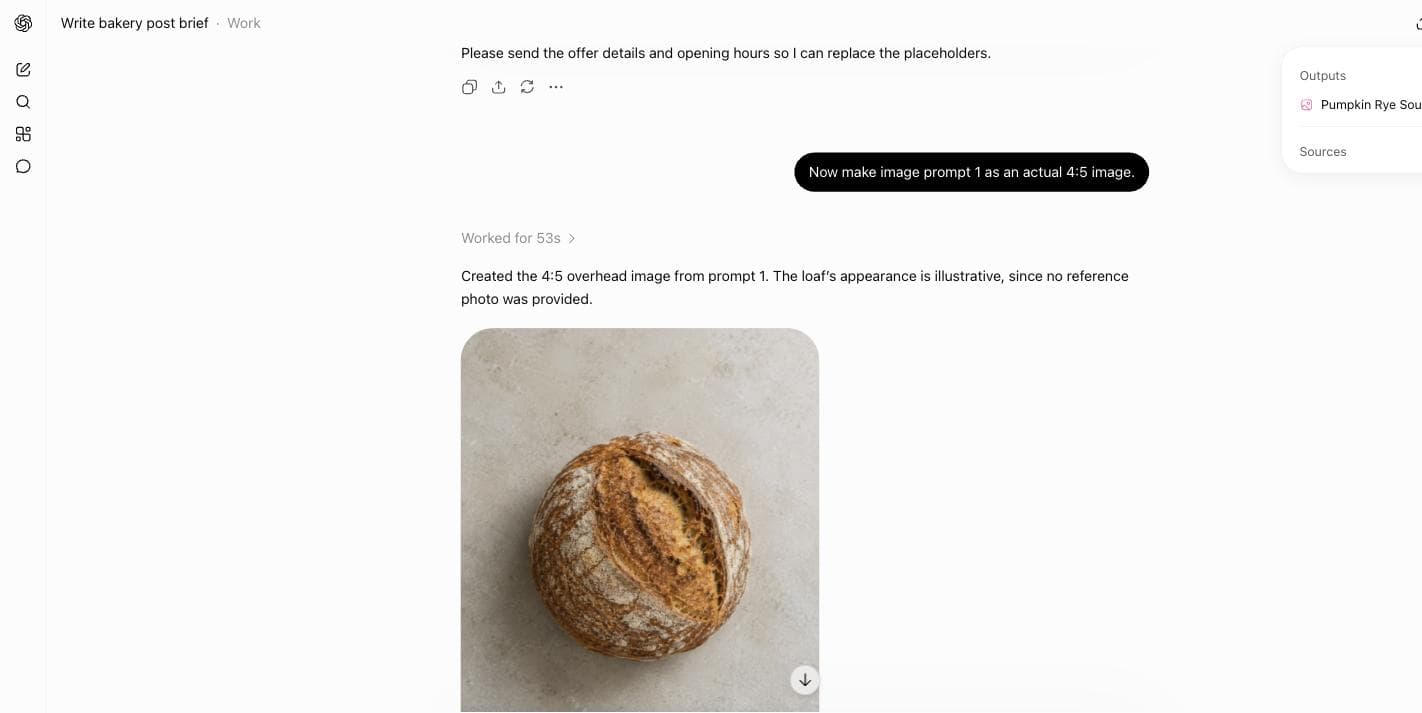
在 ChatGPT 裡,這個工具已經預設開啟。我們向 GPT-6 Sol 要一張圖時,ChatGPT 說它正在使用影像技能,並在 53 秒後交回一張 4:5 的照片。所以在應用程式裡,向 Sol 要圖行得通;在 API 裡,只有你自己接上那個工具才行得通。
Ciyo 不執行 GPT-6 Sol 或 Luna。Ciyo 的 Agent 提供 Ciyo Agent 與 GPT-6 Astra,圖片則由 GPT Image 2.5 等影像模型生成。你可以在 Sol 裡做規劃,再到 Ciyo 裡做圖,本文其餘部分示範的就是這件事。
| 模型 | 我們在哪裡問 | 交回了什麼 |
|---|---|---|
| GPT-6 Sol | ChatGPT Work,Medium | 一張 4:5 照片,由 ChatGPT 的影像工具製作 |
| GPT-6 Luna | 只查了 API 文件 | 文字;影像只能透過影像工具 |
| Claude Opus 5.5 | claude.ai,Medium | 沒有照片;改交一個插畫風格的 SVG 檔案 |
測試用的需求
每個模型拿到的需求都一樣:一家虛構的麵包店 Kettle & Crumb,在 10 月 3 日星期六推出南瓜裸麥酸種麵包,每條 $9,共 60 條,預購在那週的星期四截止。需求要模型寫一份簡短的創意簡報、三段影像提示詞和一則貼文文案,並要它把自己不得不猜的東西都列出來。
接著我們只追加了一句:把影像提示詞 1 實際做成一張 4:5 的圖。
你正在為一家小型社區麵包店規劃一則 Instagram 貼文。只能使用下面的事實。如果你需要事實裡沒有的東西,請把它寫進一份名為「假設」的清單,而不要把它當成事實陳述。

事實:
- 麵包店:Kettle & Crumb,14 Alder Street
- 新產品:南瓜裸麥酸種麵包,10 月 3 日星期六上市
- 價格:每條 $9
- 上市當天只有 60 條
- 預購於 10 月 1 日星期四截止,透過我們個人簡介裡的連結
- 不打折,不外送
- 受眾:已經在 Instagram 上追蹤我們、住在附近的人

請給我三樣東西:
1. 一份不超過 80 字的創意簡報。
2. 三段不同的影像提示詞,用於一張 4:5 的照片。影像中不得出現任何文字、字母或標誌。
3. 一則不超過 60 字的貼文文案。
GPT-6 Sol 做了什麼
Sol 的第一個回答很謹慎。它寫了三段樸素的提示詞——俯拍、特寫、四分之三視角——並把自己的視覺選擇列為假設,因為需求裡從來沒有描述過這條麵包。
被要求出圖時,它宣布正在使用影像技能,交回一張俯拍照片:淺色檯面上一條未切開的圓形麵包。它附註說,因為沒有提供參考照片,麵包的外觀只是示意。這個但書是對的:這張圖是對你產品的猜測,不是你的產品。
Claude Opus 5.5 做了什麼
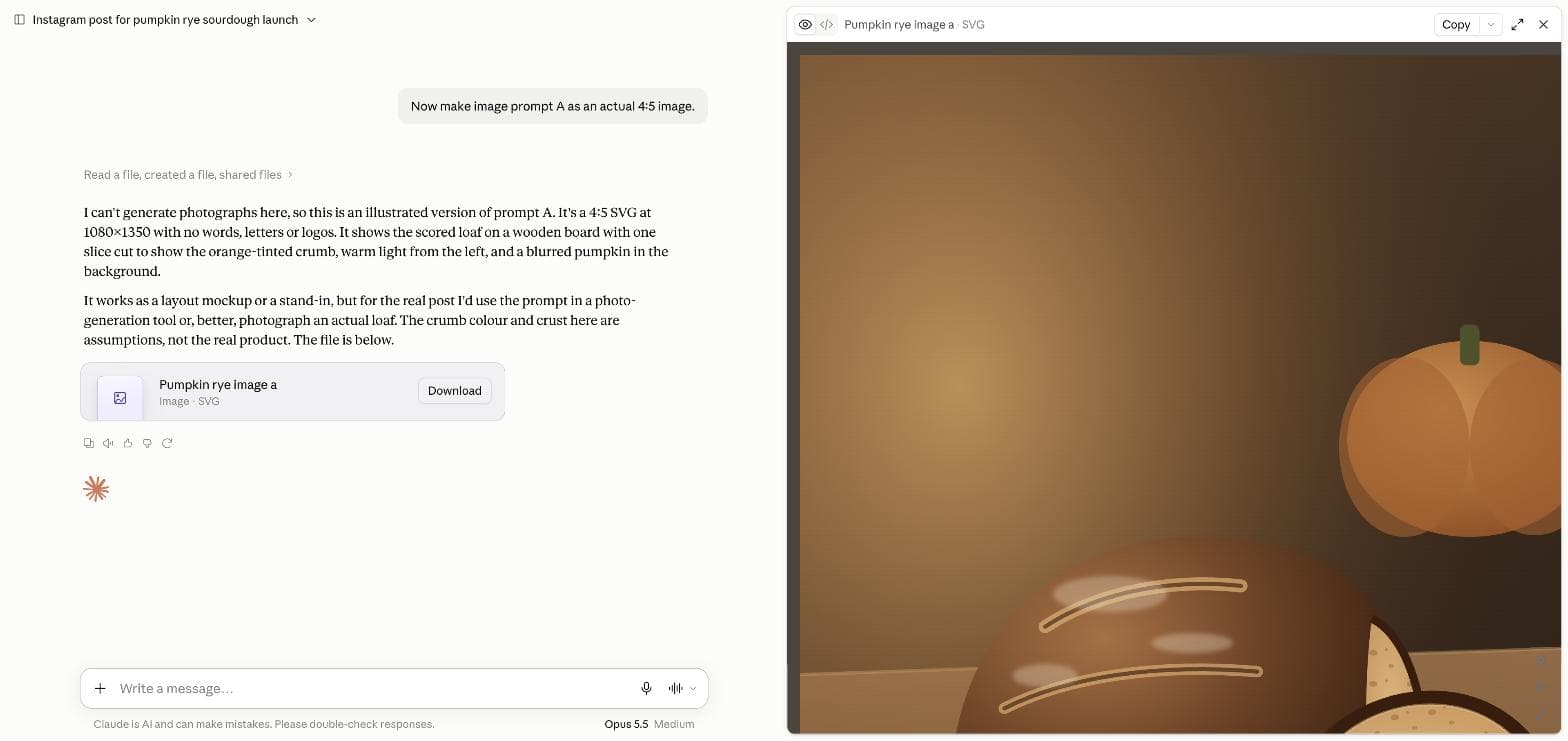
Opus 5.5 直接說明它在那個對話裡無法生成照片。它改寫了一張 1080 × 1350 像素的 SVG 插畫——正確的 4:5 比例——畫了一條有割紋的麵包、一片切片和一顆模糊的南瓜,並建議改用照片工具,或者更好的做法:拍一張真實麵包的照片。
插畫風格的 SVG 適合當版面草稿。它不是產品照片,Opus 自己也這麼說。Anthropic 的發布公告並沒有把影像生成列為 Opus 5.5 的輸出之一。
在 Ciyo 裡做出這張圖
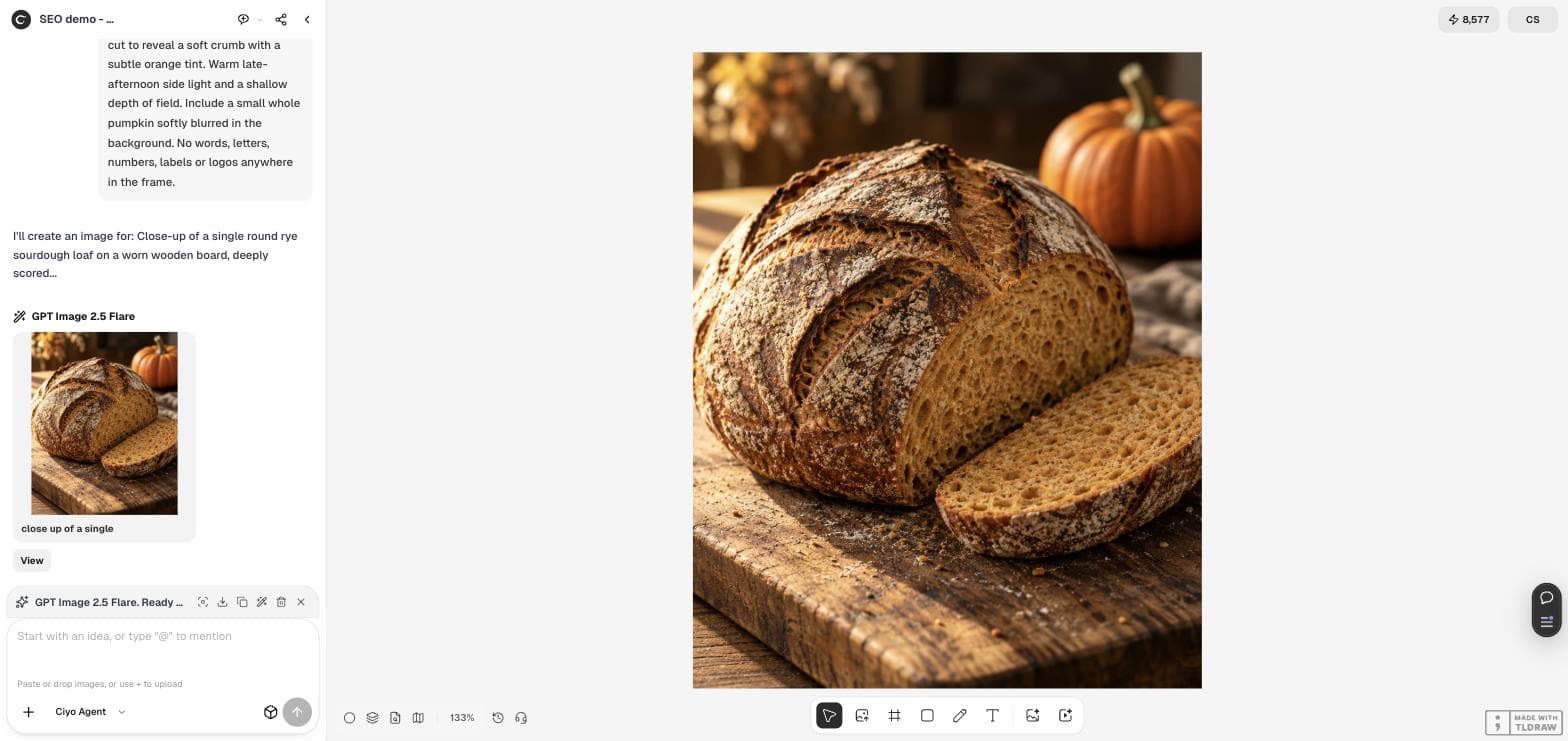
我們把 Opus 的第一段提示詞——切開一片、後方有一顆南瓜的特寫——貼進 Ciyo 的影像生成器,選用 GPT Image 2.5 Flare,比例 4:5、解析度 1K。花了 2 點,不到一分鐘就交回一張 896 × 1120 的照片。
這張圖緊貼提示詞:有割紋的外殼、帶橘色調的內部組織、一片切片、磨舊的砧板、右上角的南瓜,而且沒有任何文字。規劃模型決定細節;影像模型把它們畫出來。
你的貼文該用哪一個
用 Sol 或 Luna 做規劃:創意簡報、鏡頭清單、貼文文案,以及需要核對的猜測清單。如果你本來就在 ChatGPT 裡,直接向 Sol 要圖很方便,但你無法在那裡選擇影像模型或它的設定。
最終的圖,用一個你能操控的影像模型來做——比例、解析度、品質,以及一張真實產品的參考照片。在 Ciyo 裡,那就是影像生成器,或是搭配 GPT-6 Astra 的 Agent,它能在同一輪裡寫好提示詞並把圖放上畫布。
OpenAI 在發布時怎麼說
發布文章把 Sol 與 Luna 描述為建立在 Astra 進展之上、更快也更便宜的模型。文章沒有宣稱能輸出影像,這和模型頁面一致。
OpenAI 官方帳號於 2026-09-22 發布。它把 Sol 與 Luna 定位為建立在 GPT-6 Astra 之上、更快也更實惠的模型。貼文完全沒提到生成圖片;本文中的圖片都來自另外的影像工具。
Sol、Luna 與圖片
GPT-6 Sol 自己能生成圖片嗎?
不能。OpenAI 只把文字列為它的輸出。在 ChatGPT 裡它可以呼叫影像工具,透過 API,開發者也可以開啟同一個工具。
GPT-6 Luna 有什麼不同嗎?
在影像方面沒有。Luna 和 Sol 一樣,輸入文字與影像、只輸出文字,價格更低。
Claude Opus 5.5 能做照片嗎?
在我們的測試裡,它說它不能,並改畫了一張插畫 SVG。那可以當版面草稿,不能當產品照片。
Ciyo 執行 GPT-6 Sol 或 Luna 嗎?
不執行。Ciyo 的 Agent 提供 Ciyo Agent 與 GPT-6 Astra。你可以在別處做規劃,再把提示詞貼進 Ciyo 的影像生成器。
用任何模型規劃,在 Ciyo 裡做圖
把提示詞貼進 Ciyo 的影像生成器,選好比例與品質,執行之前就能看到要花多少點數。