模型 · 面向設計師
該從人手上卸下的四項檢查
帶著上個月價格發出去的貼文,從來不是才華的失敗。它是最後五分鐘的失敗——那時本該有人再讀一遍,卻沒讀,因為旁邊還排著另外十一篇貼文。
文案檢查是市場團隊裡最該自動化、也最沒被自動化的活兒,因為直到最近,選擇只有兩個:一個抓不住任何微妙之處的正規表示式,或者一個週二答案就變樣的語言模型。而 2026 年 9 月 15 日發布的一個模型,會用一個帶型別的值和一個信度數字來回答預先聲明的問題。Ciyo 無法執行 Jev——它不生成影像、也不生成影片,而且不在我們的任何一個模型註冊表裡——但下面這四項檢查,不管最後由什麼來跑,都值得搭起來。
為什麼文案是最該自動化的事
這類模型只讀文字,別的什麼都不讀:TypeSafe 的文件中寫明,你傳送的內容必須是一個字串、一個 JSON 物件,或一組文字值,而且影像目前還不受支援。
對大多數創意工作來說,這是個嚴肅的限制。對文案檢查卻根本不算限制,因為文案本來就是文字。這是工作室裡唯一一個模型的邊界和任務的形狀嚴絲合縫對齊的活兒。
所以,決策模型雖然無法告訴你海報好不好,但它能告訴你——每次、每篇、不到一秒——文案裡是否寫明了價格、是否用了法務劃掉的詞、是否帶上了你同意添加的廣告標籤。
四項檢查
每一項都是一道獨立的問題,各自帶著預先聲明的答案。這很重要:把四個合起來問一個問題,實測比分開問四個窄問題要差;而四個本來就會針對同一段文字一起被評估。
主張檢查,是唯一回本的那一項
清單上其他項保護你免於尷尬。這一項保護你免於退款佇列。
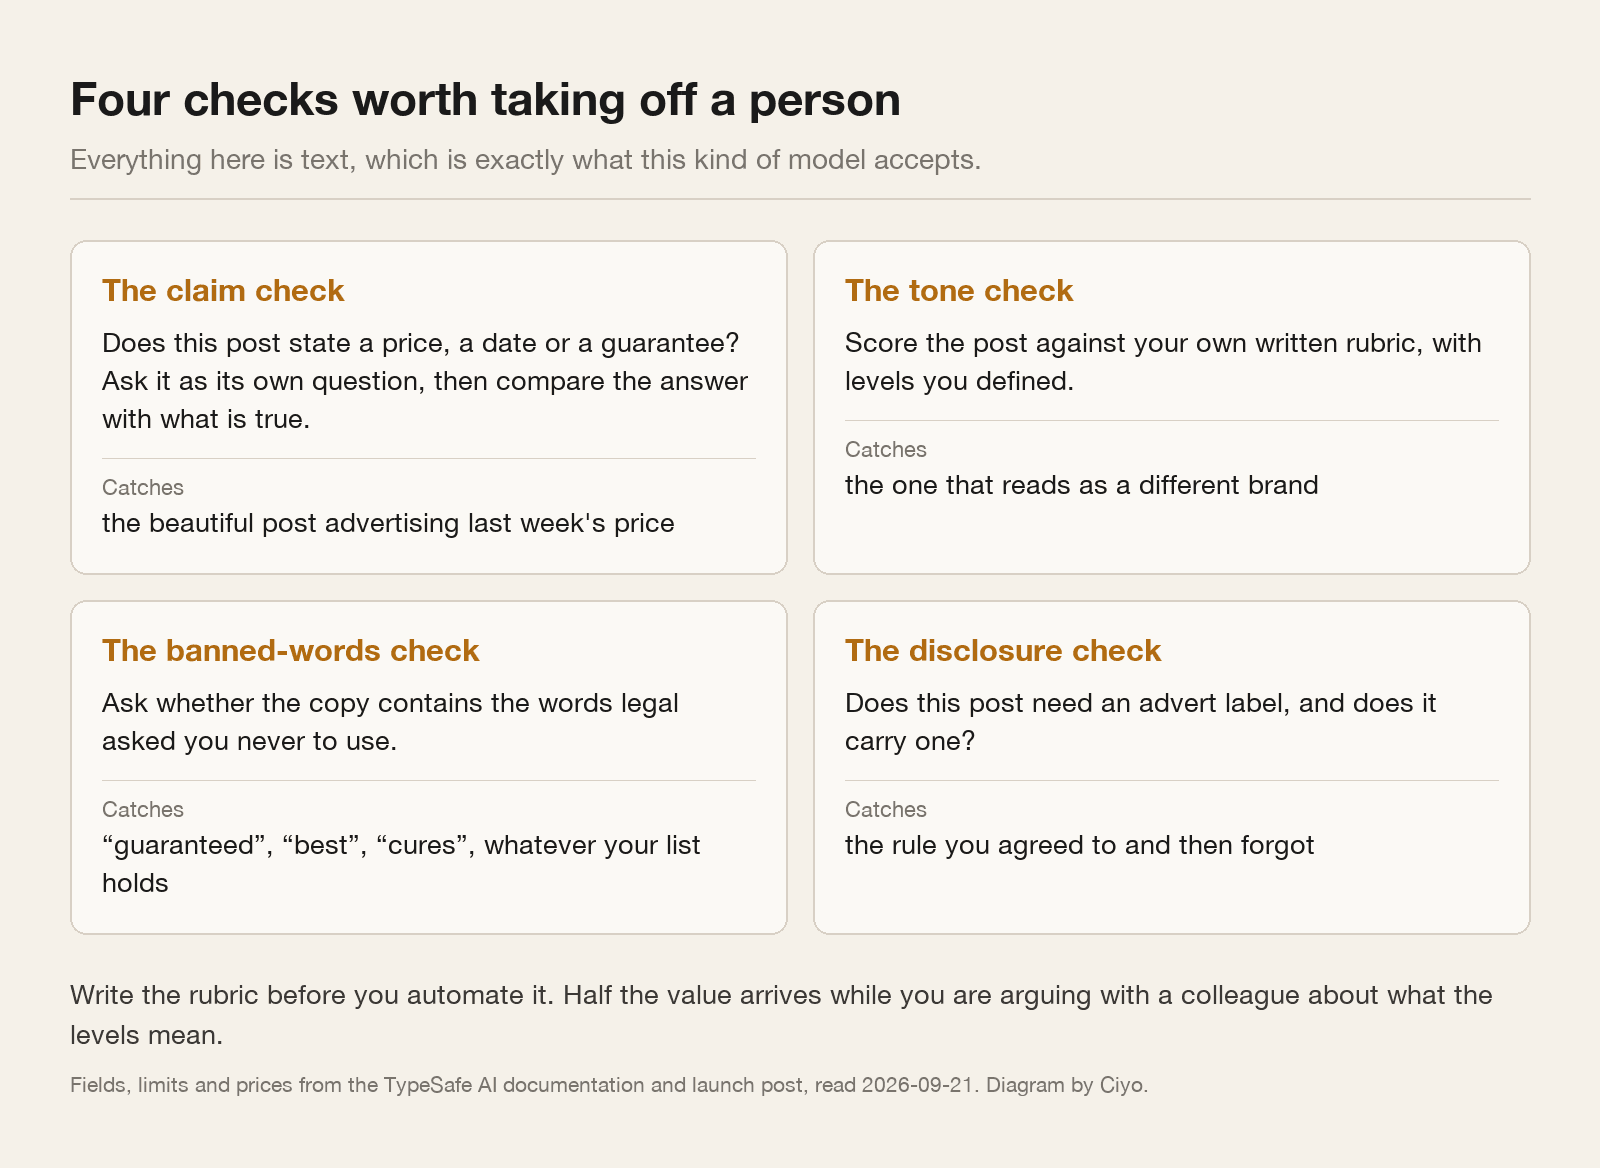
不要問一個主張是否為真,因為模型根本沒有辦法知道。要問文案到底有沒有做出一個可核實的主張,以及是哪一種。然後把那個答案和你掌握的事實對照。
所以:這篇貼文寫明了價格嗎?寫明了日期或時間視窗嗎?承諾了某種結果嗎?點名了某個折扣嗎?四個是非題,一次呼叫答完,任何答「是」的貼文都會連著旁邊列印的相關事實一起交給人工。模型不核實任何東西。它找出那些需要核實的句子——而這正是人們會跳過的一步。
questions: {
  "states_a_price":    { "type": "noul", "instructions": "文案中寫明了某個具體價格或金額。" },
  "states_a_date":     { "type": "noul", "instructions": "文案中寫明了某個日期、某天,或某個時間視窗。" },
  "promises_a_result": { "type": "noul", "instructions": "文案向讀者承諾了某種結果。" },
  "banned_wording":    { "type": "noul", "instructions": "文案中使用了 state 裡提供的禁用詞表中的任何詞彙。" },
  "needs_ad_label":    { "type": "noul", "instructions": "這是付費或贊助內容,需要添加廣告標籤。" },
  "tone":              { "type": "score", "instructions": "這與我們的品牌固有語調有多接近?",
                         "criteria": ["偏離品牌", "勉強合格", "符合品牌", "完全契合"] }
}
哪些仍由人工看
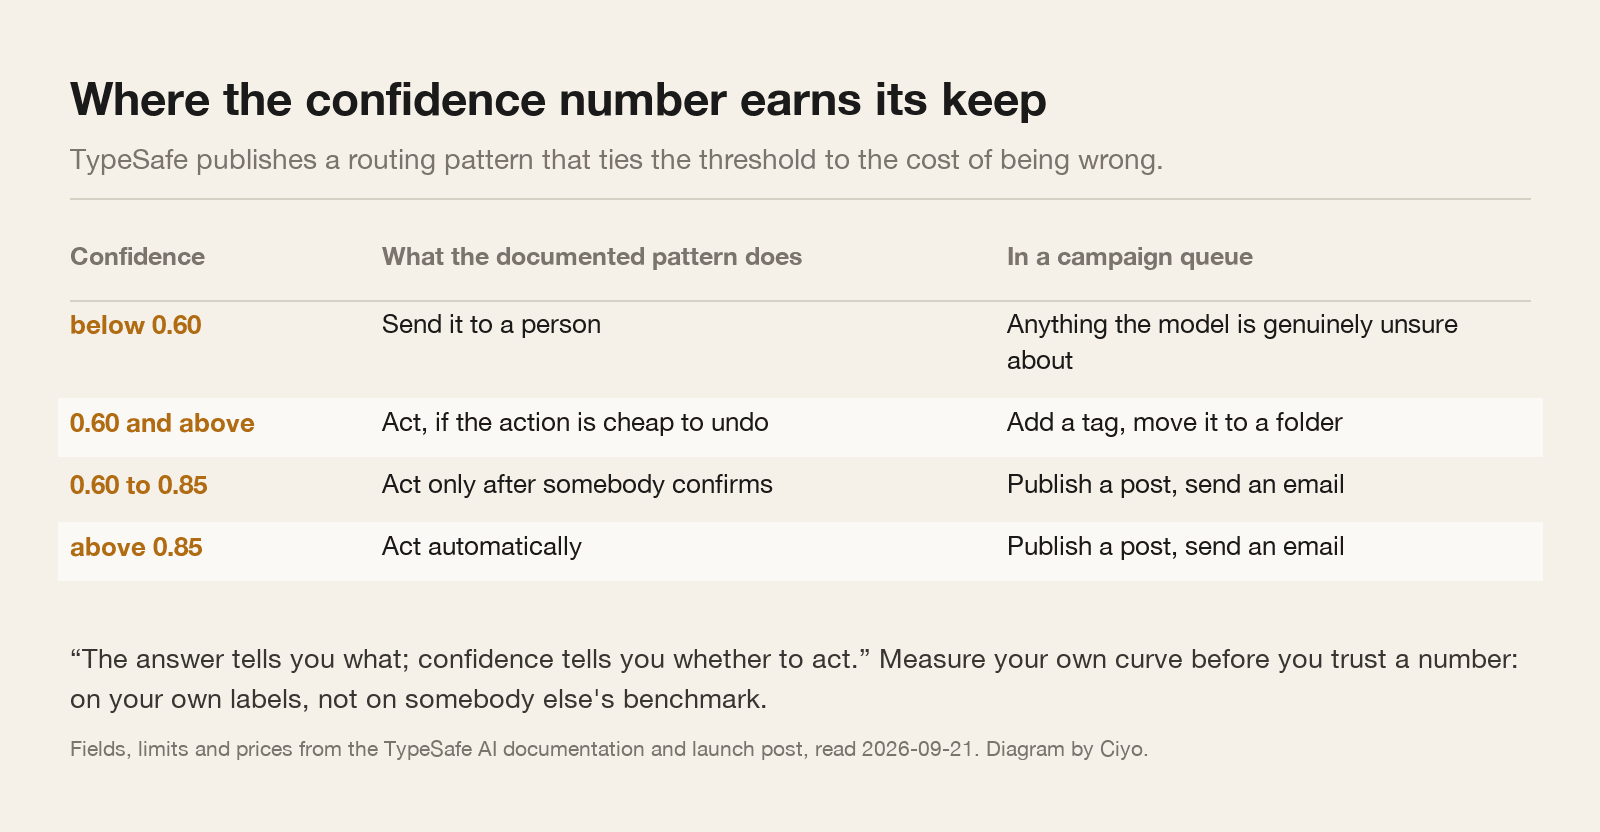
信度的值,是把一個檢查器變成工作流的東西。TypeSafe 發布了一個路由模式,把門檻和出錯代價綁定在一起,而不是和模型綁定:低於 0.6 交給人工,高於 0.6 用於便宜且可撤銷的操作,更貴的則想要 0.85 或一步確認。
在發布佇列裡這對應得很乾淨。加個標籤是可撤銷的,所以低門檻沒問題。給四萬人發一封郵件可不是,所以它想要高門檻,並且要有一個人的名字釘在上面。
不管你選了什麼數字,都要在你自己的貼文上衡量。上面的門檻只是一個有文件記錄的起點,不是關於你品牌的發現。
評分表才是真正的活兒
四項裡有三項是機械的,一下午就能搞定。語氣檢查不是,而且它是值得認真做好的那一項。
打分需要層級,層級需要定義。「符合品牌」不是定義。「用縮寫、以「你」稱呼讀者、絕不用最高級、絕不以問句開頭」才是一個。
和品牌語調的擁有者一起去寫那些定義,並且做好對話會不舒服的準備。多數團隊到這一步才發現,兩個人一年來一直在用兩套不同的規則。這個發現比自動化更值錢,而且就算你一次檢查都沒跑過,它也是你的。
| 檢查 | 抓取 | 搭建成本 |
|---|---|---|
| 主張 | 錯誤的價格、上個月的日期、兌現不了的承諾 | 一小時 |
| 禁用詞 | 法務劃掉、結果大家都忘了的那個詞 | 二十分鐘,再加上那份詞表 |
| 揭露 | 付費貼文漏了它的廣告標籤 | 一小時,再加上弄清每個頻道的規則 |
| 語氣 | 讀起來像另一個品牌的文案 | 一整天,大部分花在爭論評分表上 |
在它碰到任何真實東西之前
取五十篇你已經發過的貼文,自己動手標註。把檢查跑在這五十篇上,然後對照。那個一致率,是唯一能說明任何問題的數字;廠商的基準測試說的只是別人的任務。
然後讓它靜靜地在你現有流程旁邊跑兩週,讀它標記了什麼、沒標記什麼。一個總是朝同一個方向犯錯的檢查器,現在是在每篇貼文上犯錯,而不是在樣本上;而低成本會讓這件事在變好之前先變糟。
並且在你寫下的每一個選項上都聲明一個逃生出口。一項預先註冊的獨立評測於 2026 年 9 月 20 日發布,發現當沒有「以上都不是」可用時,三十個超出範圍的輸入裡沒有一個被標記出來——模型只是挑了最接近的已聲明答案。
文案檢查問題
它能告訴我一個主張是否為真嗎?
不能。它能告訴你文案做出了一個主張,以及是哪一種。把那點和事實對照,仍然歸你;但找出那些需要核實的句子,正是人們會跳過的一步。
這比一份詞表更好嗎?
對禁用詞來說,幾乎談不上。對語氣、主張和揭露,它完全是另一回事,因為這些需要判斷,而不是匹配。
我該以哪個門檻發布?
有文件記錄的模式用 0.6 對應便宜且可撤銷的操作,用 0.85 對應昂貴的操作。在信任這兩個數字之前,先在你自己的貼文上量出你自己的曲線。
Ciyo 會跑這些檢查嗎?
不會。Ciyo 不執行 Jev。Ciyo 的代理可以借助 GPT-6 Astra,按寫好的標準審查一篇貼文——那是一種不同的檢查:是散文式的推理,而不是一個帶型別、可重複的值。
繼續閱讀
Ciyo 寫作的主題,是創意與智慧代理工具背後的那些模型,並會對它能執行的那些進行測試。