配音 · 实测
用 Eleven v4 给产品视频配音:15 秒里能说多少
配音能把一组产品照片的幻灯片变成一支小广告。难的不是声音,而是时间:一条有三个镜头的 15 秒视频,每句话大约只有五秒,而一句在纸上看着很短的话,说出来可能要七秒。
ElevenLabs 在 2026年9月28日发布了 Eleven v4,Ciyo 的智能体现在用它来做旁白。2026年9月29日,我们为虚构陶艺工作室 Tidewell 的一款马克杯 Low Tide 做了一条 15 秒的上新视频,并测量了每个词落在哪里。声音很清晰。时间安排改了两轮才对。
Eleven v4 是什么
Eleven v4 是 ElevenLabs 最新的文本转语音模型,同时发布的还有一个更快、面向实时智能体的 Eleven v4 Turbo。ElevenLabs 称两者都支持 90 多种语言,并且可以用行内标签来指导语气和表达。在 Ciyo 里,智能体的旁白工具使用 Eleven v4,提供固定的十种声音;默认声音是温暖、平静的女声 Sarah。
在 Ciyo 里,旁白不是画板上的一个单独文件。智能体按章节写脚本,每个章节生成一段音频,再把它们混成一条成片视频,保存在画板上。
2026-09-28 发布。ElevenLabs 的发布帖介绍了 Eleven v4 和 Eleven v4 Turbo,称它们是其“fastest and most emotive voice models yet”(迄今最快、情感最丰富的语音模型),并说它们在 Artificial Analysis 的排名中位列第一。我们没有核实这个排名;下面的测试讲的是如何为一条产品短视频安排配音的时间。
先准备风格一致的照片
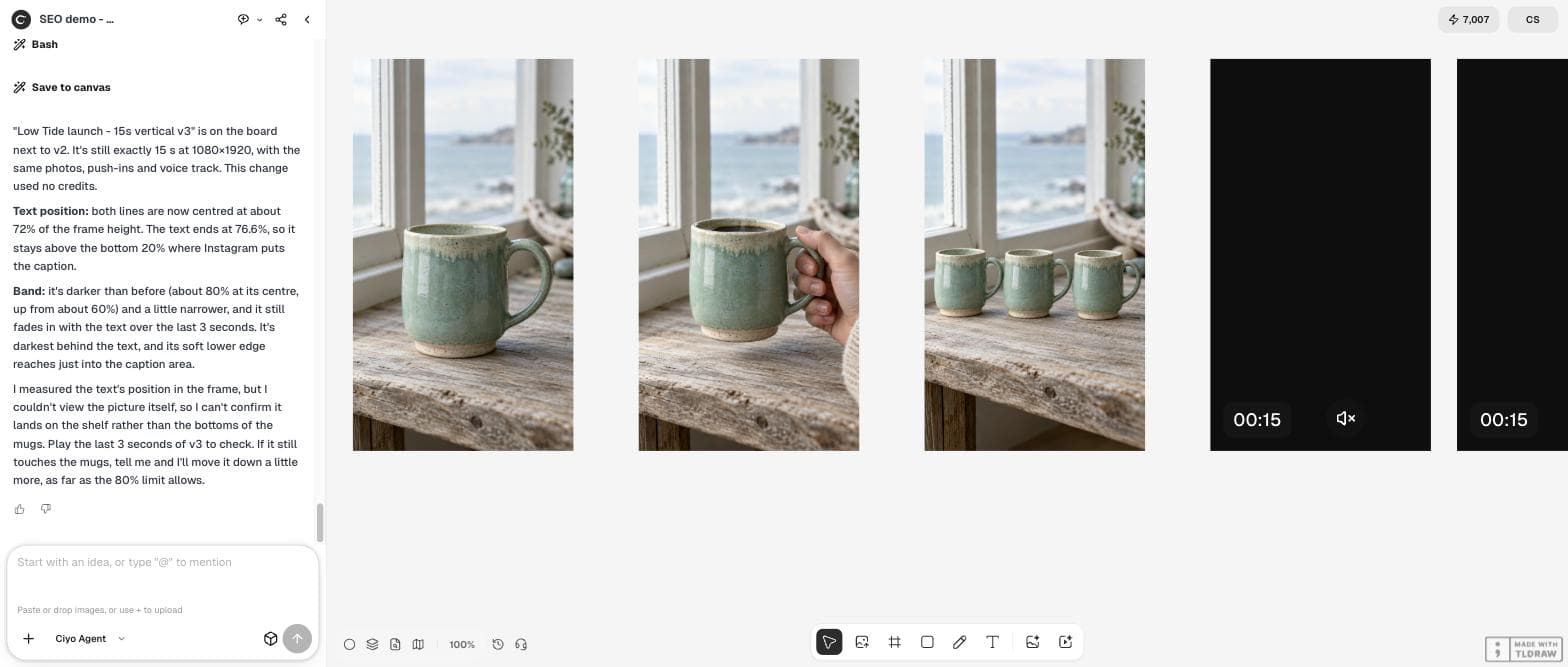
我们要了同一只马克杯的三张 9:16 照片:单独放在架子上、盛着咖啡被拿起来、三只排成一排。智能体先做了第一张,再把它作为另外两张的参考图,让釉色和杯形保持一致。三张共花了 8 个额度。
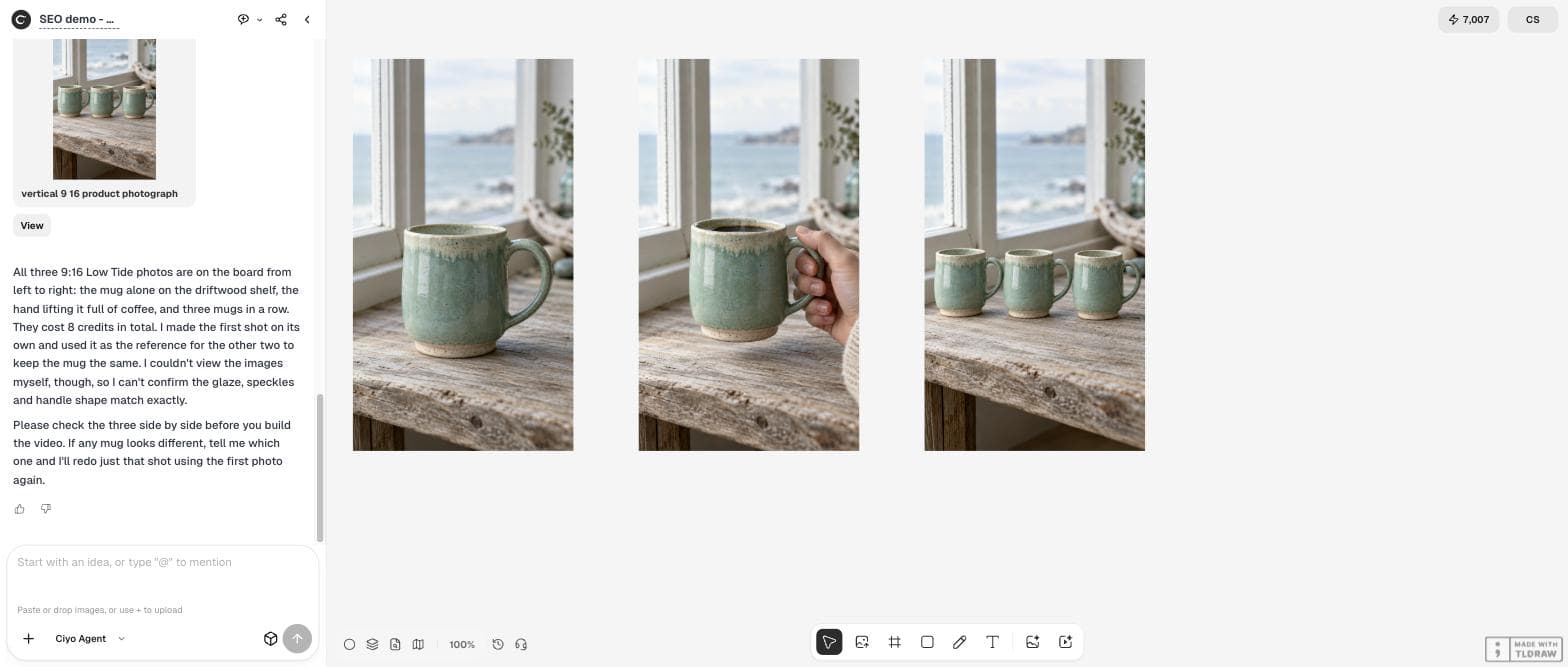
我经营一家小陶艺工作室 Tidewell。我们周六要上新一款叫 Low Tide 的马克杯。请为一条竖版短视频做三张 9:16 的产品照片:1) 马克杯单独放在窗边的浮木架上,带斑点的奶油色陶土上施海玻璃绿釉,柔和的晨光;2) 一只手拿起同一只盛满咖啡的马克杯;3) 三只同样的马克杯在架子上排成一排。三张图里的马克杯要完全一样。自然的颜色,不要文字,不要标志。按章节写脚本
我们把章节、声音和逐字的台词交给智能体。它为每个章节生成一段旁白,在组装视频之前逐段测量。然后它告诉我们一个问题:“Chapter 1's narration came out at 6.53 s, longer than its 5 s slot.”(第 1 章的旁白长 6.53 s,超过了它 5 s 的时段。)
它没有在不问我们的情况下加快语速或删词。它让第一句延续 1.5 秒进入第二张照片,把后面的句子顺延,并报告了时间安排。三段音频每段花了 1 个额度。
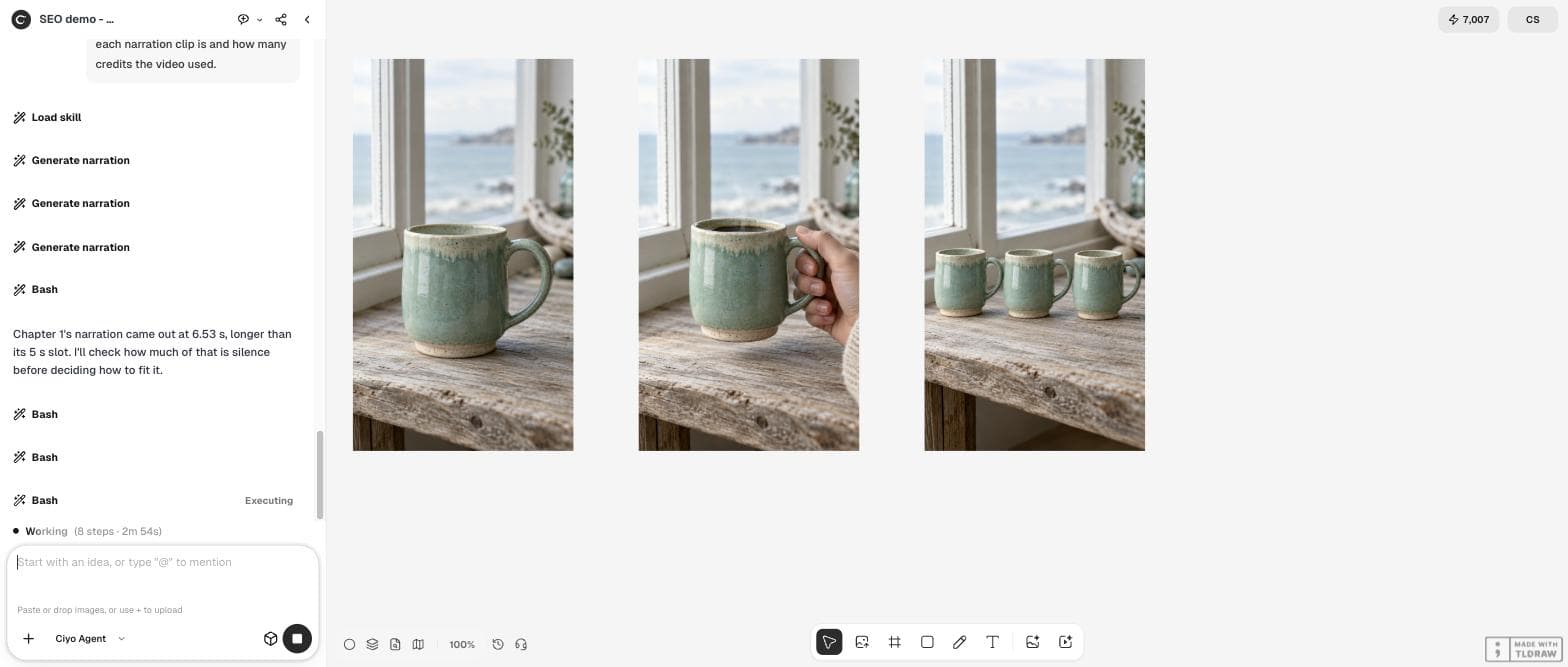
三张照片风格一致。现在用它们做一条 15 秒的竖版视频(1080x1920),配英文旁白,声音用 Sarah。章节:0 到 5 s 照片 1,5 到 10 s 照片 2,10 到 15 s 照片 3,每张都缓慢推近。旁白逐字如下:"Meet Low Tide. Sea-glass glaze over speckled clay, thrown by hand at Tidewell. It holds your morning coffee and feels like the shore. Low Tide mugs arrive Saturday at tidewell.shop." 不要音乐。在最后 3 秒显示文字 "Low Tide - Saturday - tidewell.shop"。告诉我每段旁白有多长,以及视频用了多少额度。声音实际落在了哪里
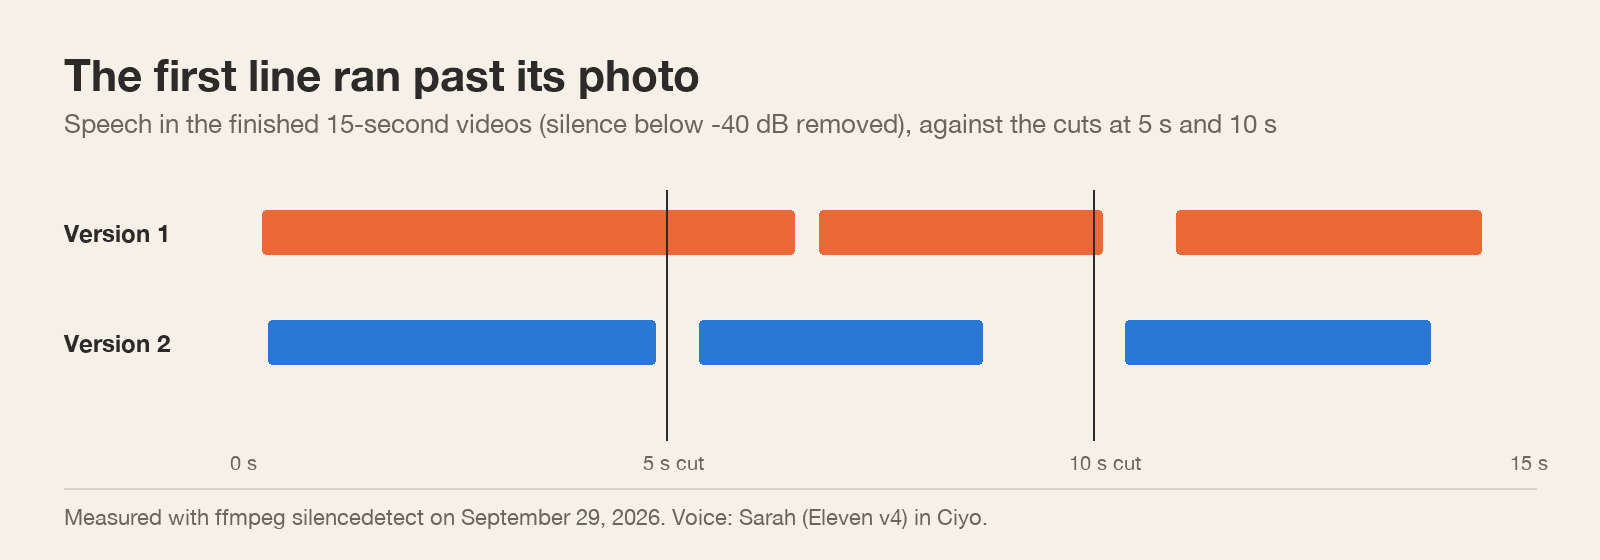
我们用 ffmpeg 测量了成片。人声分别位于 0.26 到 6.49 秒、6.78 到 10.10 秒和 10.97 到 14.54 秒。所以第一句话压过了 5 秒处的剪辑点,第二句话正好在 10 秒的剪辑点上结束。
这些数字给出了一条简单的规则。第一句有 13 个词,加上停顿用了 6.5 秒,约每秒 2 个词。第二句 10 个词用了 3.3 秒,因为中间没有句号;光是“Meet Low Tide.”(来认识 Low Tide。)后面的句号就加了 0.44 秒的停顿。一个 5 秒的镜头按 8 到 10 个英文单词来规划,每个句号或冒号大约算半秒。
只修一个章节,而不是整份脚本
我们缩短了第一句,请智能体只重做那一段。即使缩短后,这句话还是稍长了一点,所以智能体剪掉了“Meet Low Tide:”(来认识 Low Tide:)后面的停顿,并把这段加速 3%,变成 4.62 秒。这花了 1 个额度,另外两段音频沿用原来的。
在第二个版本里,每句话都落在自己的照片之内:0.33 到 4.86 秒、5.38 到 8.70 秒和 10.37 到 13.94 秒。响度为 −16.5 LUFS,峰值 −1.3 dB,接近智能体的视频方案所瞄准的 −16 LUFS。
请做两处修改。1) 让每句话都落在自己的照片之内。只替换第 1 段,改用这句更短的台词并只重做这一段:"Meet Low Tide: sea-glass glaze, thrown by hand at Tidewell." 第 2 段和第 3 段原样沿用,每段都在对应照片出现约 0.3 s 后开始。2) 结尾文字太小,而且在顶部,会被 Instagram 的顶栏挡住。把它放大并居中,放在画面高度约 60% 的位置,分两行:"Low Tide mugs" 和 "Saturday - tidewell.shop",后面加一条柔和的深色底带。视频保持正好 15 s,并告诉我新那段的时长和用掉的额度。在手机尺寸的画面上检查结尾字卡
第一版的结尾文字是靠近顶部的一条灰色小字带,大约在 1,920 像素中的 220 到 325 像素之间,应用的顶栏可能会挡住它。我们的修改让它变大并居中在 60% 高度处,结果它压在了三只马克杯上。第三次请求把它移到了架子上,位于 72% 高度处,在 Instagram 放置说明文字的底部 20% 之上。这次修改没有花额度,音频也完全没变。
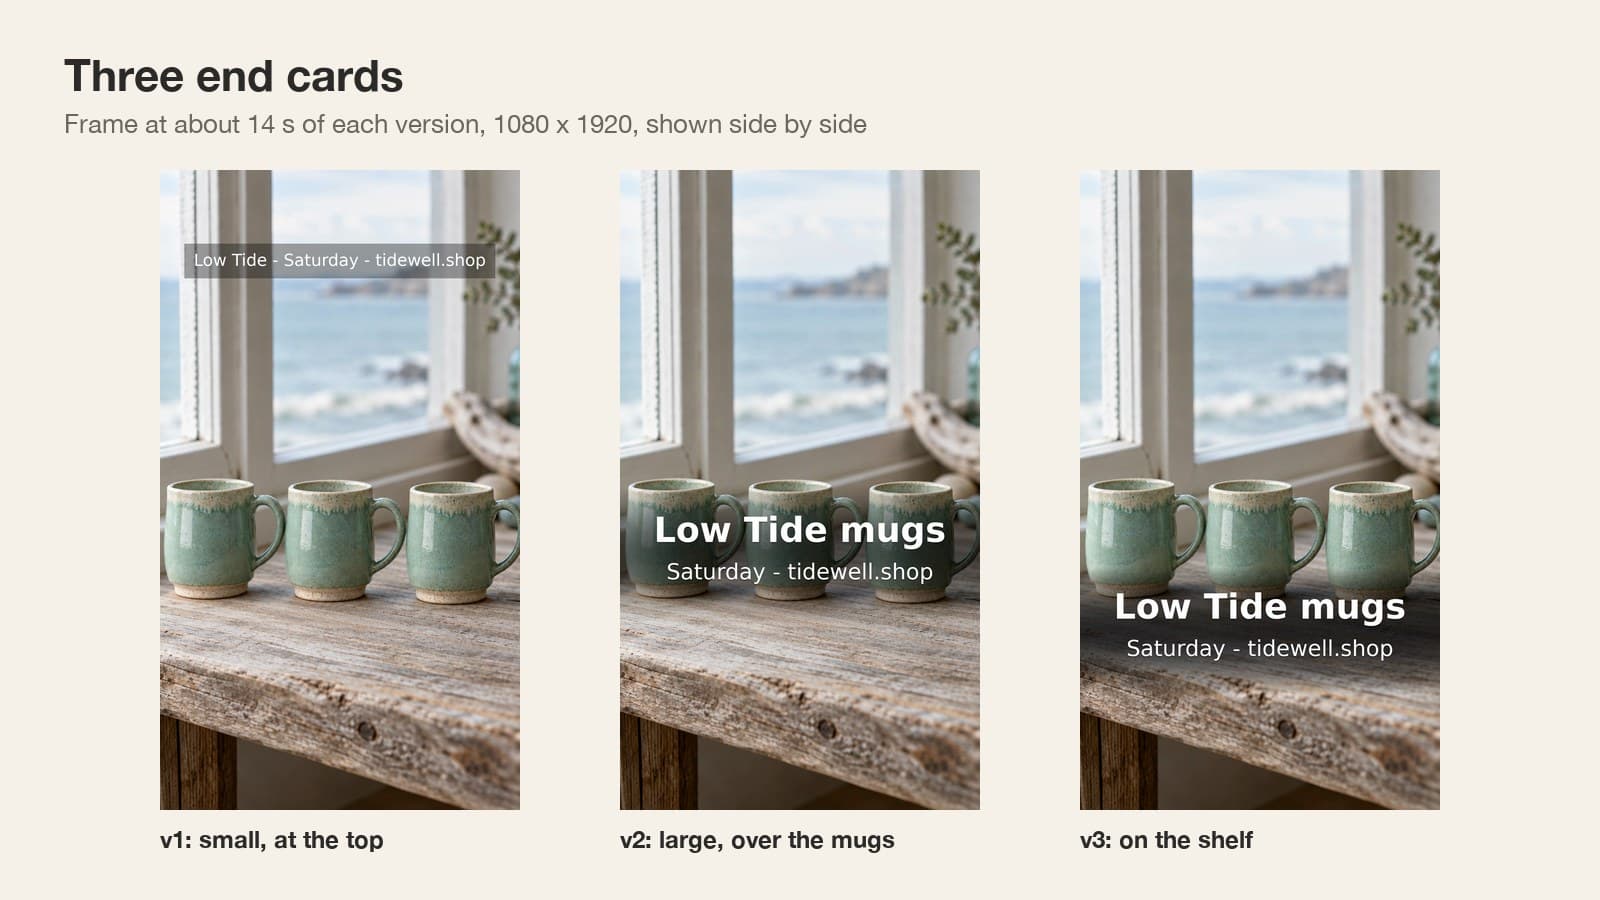
旁白的时间现在对了。最后一处修改:在 60% 的位置,结尾文字压在三只马克杯上,挡住了产品。把两行文字都往下移到马克杯下方的木架上,大约在画面高度 72% 的位置,避开 Instagram 放说明文字的底部 20%,并把文字后面的深色底带加深一点。其他一切保持不变,另存为 v3。整条视频花了多少
总共 12 个额度:照片 8 个,第一版旁白 3 个,重做的章节 1 个。用照片组装视频,以及之后对文字和时间的每一次修改,都没有花额度,因为没有生成新的视频。
| 检查项 | 版本 1 | 版本 3(最终版) |
|---|---|---|
| 时长 | 15.000 s | 15.000 s |
| 每句话都在自己的照片之内 | 否(第一句延续到 6.49 s) | 是 |
| 响度 | −16.6 LUFS | −16.5 LUFS |
| 结尾文字 | 小字,在顶部 | 大字,在架子上,位于说明文字区域之上 |
| 额度 | 11(照片 8 + 旁白 3) | 共 12 |
Eleven v4 配音
Eleven v4 是什么?
ElevenLabs 在 2026年9月28日发布的文本转语音模型,另有一个更快的 Turbo 版本。ElevenLabs 称它支持 90 多种语言和行内语气标签。
一个 5 秒的镜头能放多少个词?
在我们的测试中,Sarah 这个声音在有停顿的句子里约每秒说 2 个英文单词,在没有停顿的句子里约每秒 3 个。5 秒按 8 到 10 个词来规划,每个句号或冒号大约算半秒。
在 Ciyo 里能选声音吗?
能。在请求里点名 Ciyo 的一种声音即可:Sarah、Alice、Matilda、Jessica、Lily、George、Daniel、Brian、Eric 或 Will。难读的名字还可以用 IPA 写出发音。
我能拿到单独的音频文件吗?
不能。在 Ciyo 里,旁白会混进成片视频,由智能体保存在你的画板上。
在 Ciyo 里做一条带旁白的产品视频
把照片、章节和逐字台词交给 Ciyo Agent,发布之前先检查时间安排。