模型 · 面向设计师
该从人手上卸下的四项检查
带着上个月价格发出去的帖子,从来不是才华的失败。它是最后五分钟的失败——那时本该有人再读一遍,却没读,因为旁边还排着另外十一篇帖子。
文案检查是市场团队里最该自动化、也最没被自动化的活儿,因为直到最近,选择只有两个:一个抓不住任何微妙之处的正则表达式,或者一个周二答案就变样的语言模型。而 2026 年 9 月 15 日发布的一个模型,会用一个带类型的值和一个置信度数字来回答预先声明的问题。Ciyo 无法运行 Jev——它不生成图像、也不生成视频,而且不在我们的任何一个模型注册表里——但下面这四项检查,不管最后由什么来跑,都值得搭起来。
为什么文案是最该自动化的事
这类模型只读文本,别的什么都不读:TypeSafe 的文档写明,你发送的内容必须是一个字符串、一个 JSON 对象,或一组文本值,并且图像目前还不受支持。
对大多数创意工作来说,这是个严肃的限制。对文案检查却根本不算限制,因为文案本来就是文本。这是工作室里唯一一个模型的边界和任务的形状严丝合缝对齐的活儿。
所以,决策模型虽然无法告诉你海报好不好,但它能告诉你——每次、每篇、不到一秒——文案里是否写明了价格、是否用了法务划掉的词、是否带上了你同意添加的广告标签。
四项检查
每一项都是一道独立的问题,各自带着预先声明的答案。这很重要:把四个合起来问一个问题,实测比分开问四个窄问题要差;而四个本来就会针对同一段文本一起被评估。
主张检查,是唯一回本的那一项
清单上其他项保护你免于尴尬。这一项保护你免于退款队列。
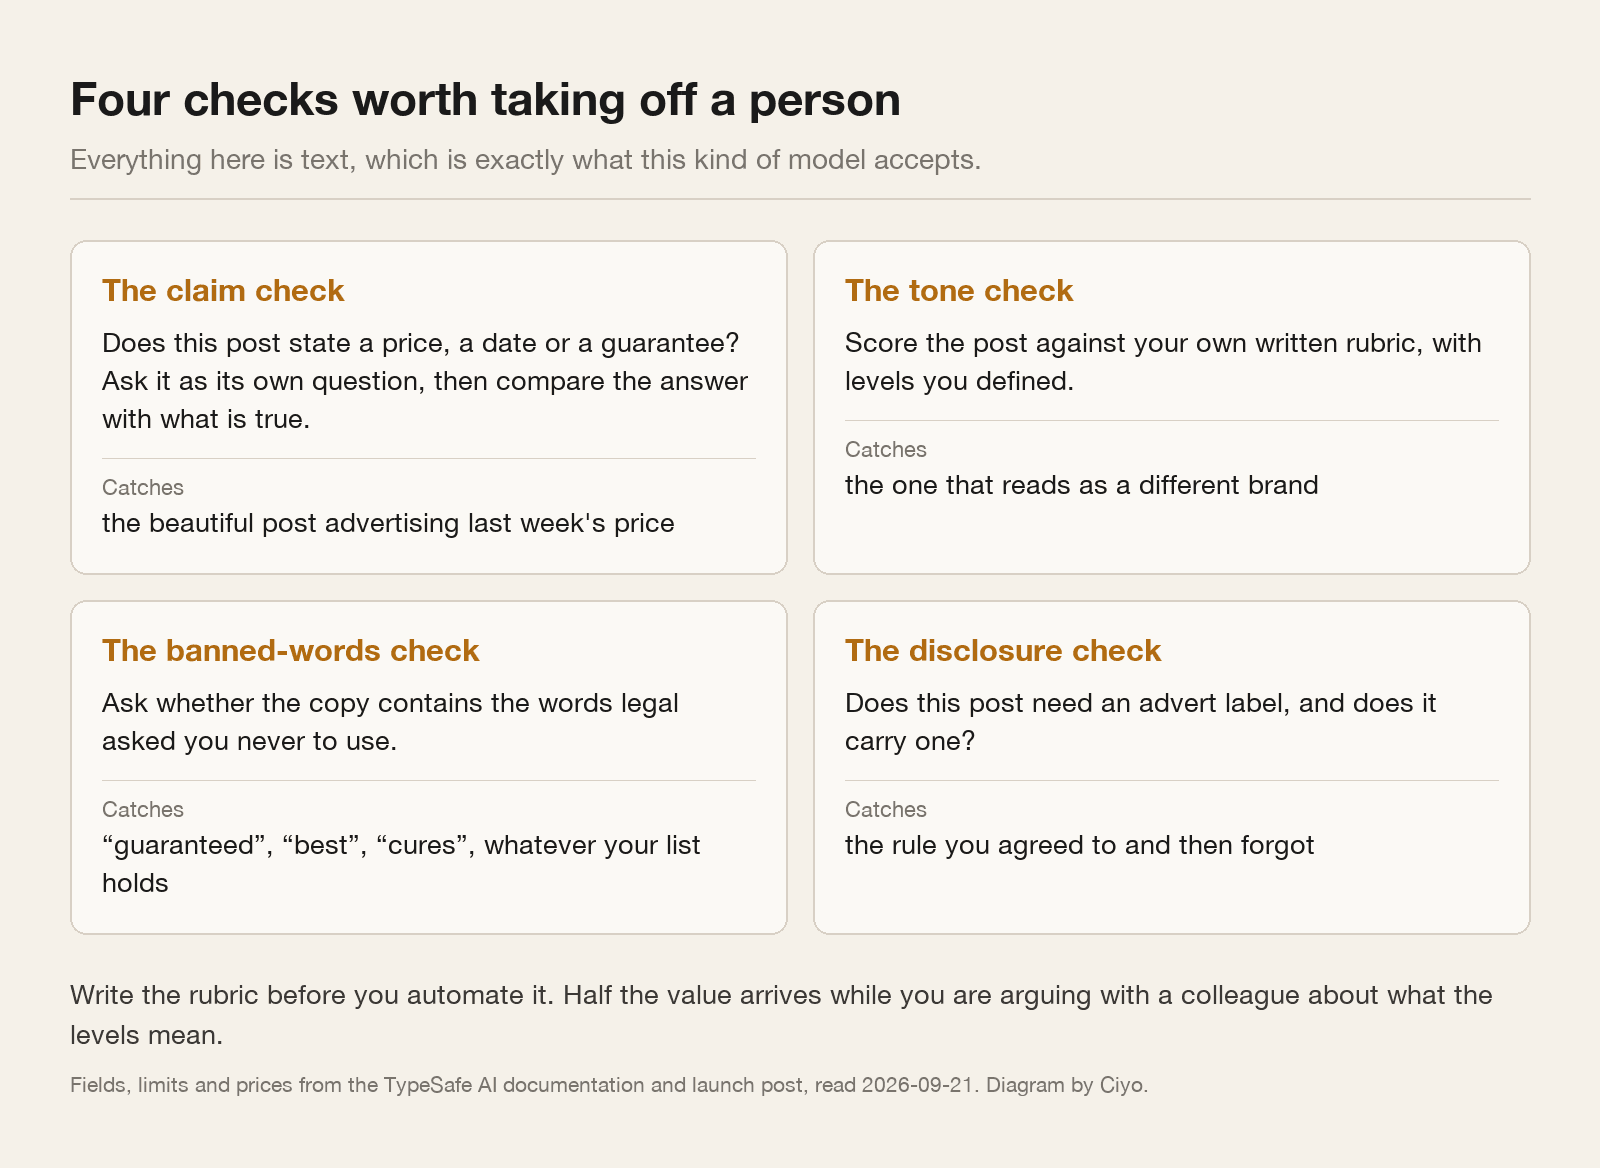
不要问一个主张是否为真,因为模型根本没有办法知道。要问文案到底有没有做出一个可核实的主张,以及是哪一种。然后把那个答案和你掌握的事实对照。
所以:这篇帖子写明了价格吗?写明了日期或时间窗口吗?承诺了某种结果吗?点名了某个折扣吗?四个是非题,一次调用答完,任何答「是」的帖子都会连着旁边打印的相关事实一起交给人工。模型不核实任何东西。它找出那些需要核实的句子——而这正是人们会跳过的一步。
questions: {
  "states_a_price":    { "type": "noul", "instructions": "文案中写明了某个具体价格或金额。" },
  "states_a_date":     { "type": "noul", "instructions": "文案中写明了某个日期、某天,或某个时间窗口。" },
  "promises_a_result": { "type": "noul", "instructions": "文案向读者承诺了某种结果。" },
  "banned_wording":    { "type": "noul", "instructions": "文案中使用了 state 里提供的禁用词表中的任何词汇。" },
  "needs_ad_label":    { "type": "noul", "instructions": "这是付费或赞助内容,需要添加广告标签。" },
  "tone":              { "type": "score", "instructions": "这与我们的品牌固有语调有多接近?",
                         "criteria": ["偏离品牌", "勉强合格", "符合品牌", "完全契合"] }
}
哪些仍由人工看
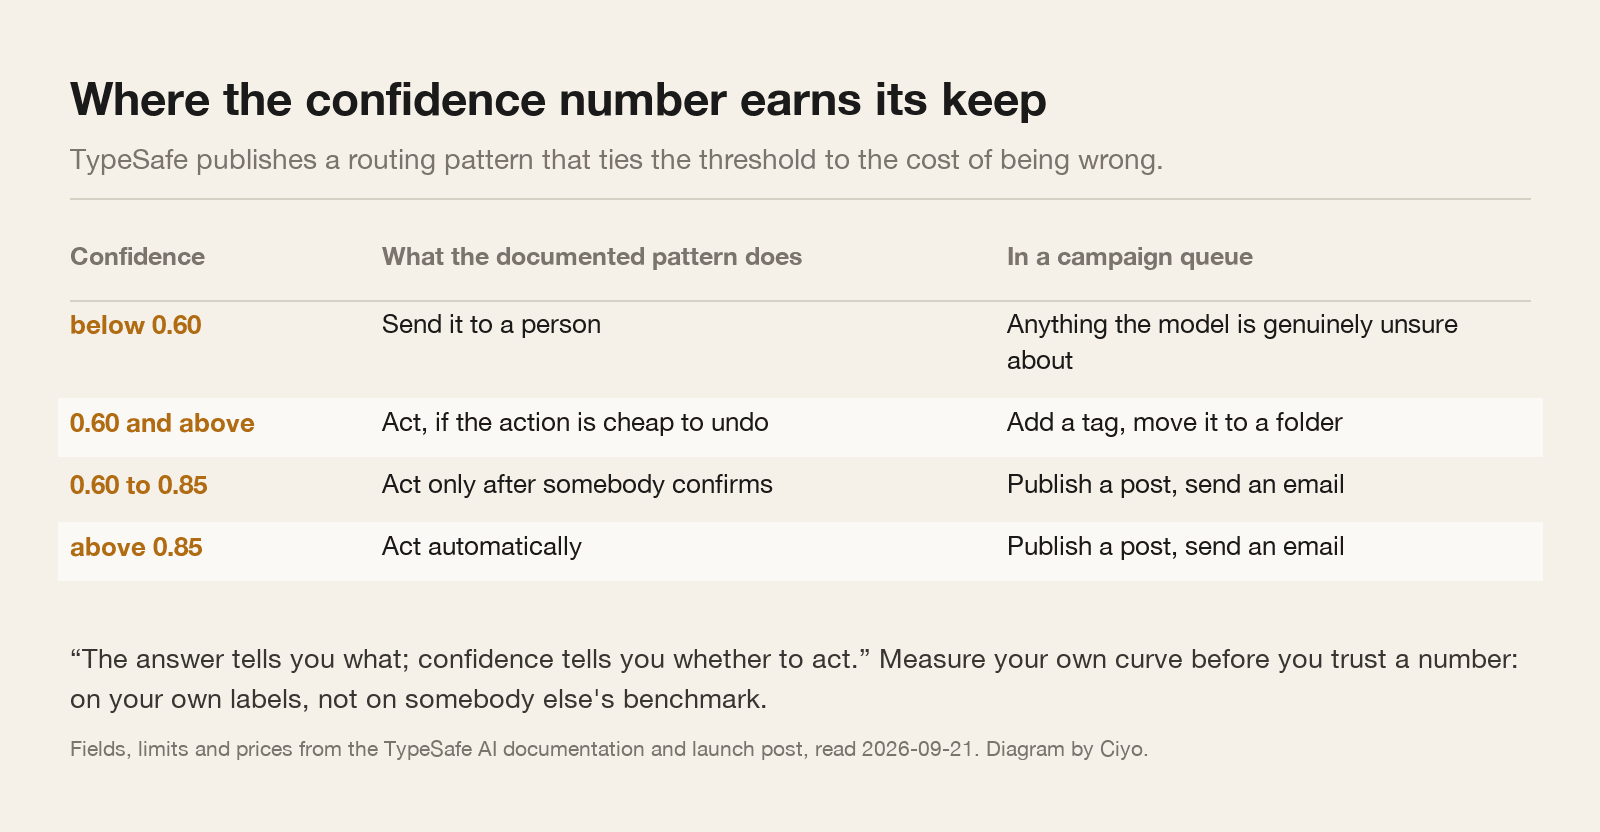
置信度的值,是把一个检查器变成工作流的东西。TypeSafe 发布了一个路由模式,把阈值和出错代价绑定在一起,而不是和模型绑定:低于 0.6 交给人工,高于 0.6 用于便宜且可撤销的操作,更贵的则想要 0.85 或一步确认。
在发布队列里这对应得很干净。加个标签是可撤销的,所以低门槛没问题。给四万人发一封邮件可不是,所以它想要高门槛,并且要有一个人的名字钉在上面。
不管你选了什么数字,都要在你自己的帖子上衡量。上面的阈值只是一个有文档记录的起点,不是关于你品牌的发现。
评分量表才是真正的活儿
四项里有三项是机械的,一下午就能搞定。语气检查不是,而且它是值得认真做好的那一项。
打分需要层级,层级需要定义。「符合品牌」不是定义。「用缩写、以「你」称呼读者、绝不用最高级、绝不以问句开头」才是一个。
和品牌语调的拥有者一起去写那些定义,并且做好对话会不舒服的准备。多数团队到这一步才发现,两个人一年来一直在用两套不同的规则。这个发现比自动化更值钱,而且就算你一次检查都没跑过,它也是你的。
| 检查 | 抓取 | 搭建成本 |
|---|---|---|
| 主张 | 错误的价格、上个月的日期、兑现不了的承诺 | 一小时 |
| 禁用词 | 法务划掉、结果大家都忘了的那个词 | 二十分钟,再加上那份词表 |
| 披露 | 付费帖子漏了它的广告标签 | 一小时,再加上弄清每个渠道的规则 |
| 语气 | 读起来像另一个品牌的文案 | 一整天,大部分花在争论评分量表上 |
在它碰到任何真实东西之前
取五十篇你已经发过的帖子,自己动手标注。把检查跑在这五十篇上,然后对照。那个一致率,是唯一能说明任何问题的数字;厂商的基准测试说的只是别人的任务。
然后让它静静地在你现有流程旁边跑两周,读它标记了什么、没标记什么。一个总是朝同一个方向犯错的检查器,现在是在每篇帖子上犯错,而不是在样本上;而低成本会让这件事在变好之前先变糟。
并且在你写下的每一个选项上都声明一个逃生出口。一项预先注册的独立评测于 2026 年 9 月 20 日发布,发现当没有「以上都不是」可用时,三十个超出范围的输入里没有一个被标记出来——模型只是挑了最接近的已声明答案。
文案检查问题
它能告诉我一个主张是否为真吗?
不能。它能告诉你文案做出了一个主张,以及是哪一种。把那点和事实对照,仍然归你;但找出那些需要核实的句子,正是人们会跳过的一步。
这比一份词表更好吗?
对禁用词来说,几乎谈不上。对语气、主张和披露,它完全是另一回事,因为这些需要判断,而不是匹配。
我该以哪个阈值发布?
有文档记录的模式用 0.6 对应便宜且可撤销的操作,用 0.85 对应昂贵的操作。在信任这两个数字之前,先在你自己的帖子上量出你自己的曲线。
Ciyo 会跑这些检查吗?
不会。Ciyo 不运行 Jev。Ciyo 的智能体可以借助 GPT-6 Astra,按写好的标准审查一篇帖子——那是一种不同的检查:是散文式的推理,而不是一个带类型、可重复的值。
继续阅读
Ciyo 写作的主题,是创意与智能体工具背后的那些模型,并会对它能运行的那些进行测试。