新模型 · 实测
Opus 5.5 能发现 AI 图表上的错误数字吗?
Anthropic 说,Claude Opus 5.5 在读图表测试 Chartography(使用工具)上得分 89.0%。对用图像生成器做幻灯片的人来说,这引出一个实际的问题:在幻灯片发出去之前,模型能不能帮你核对数字?
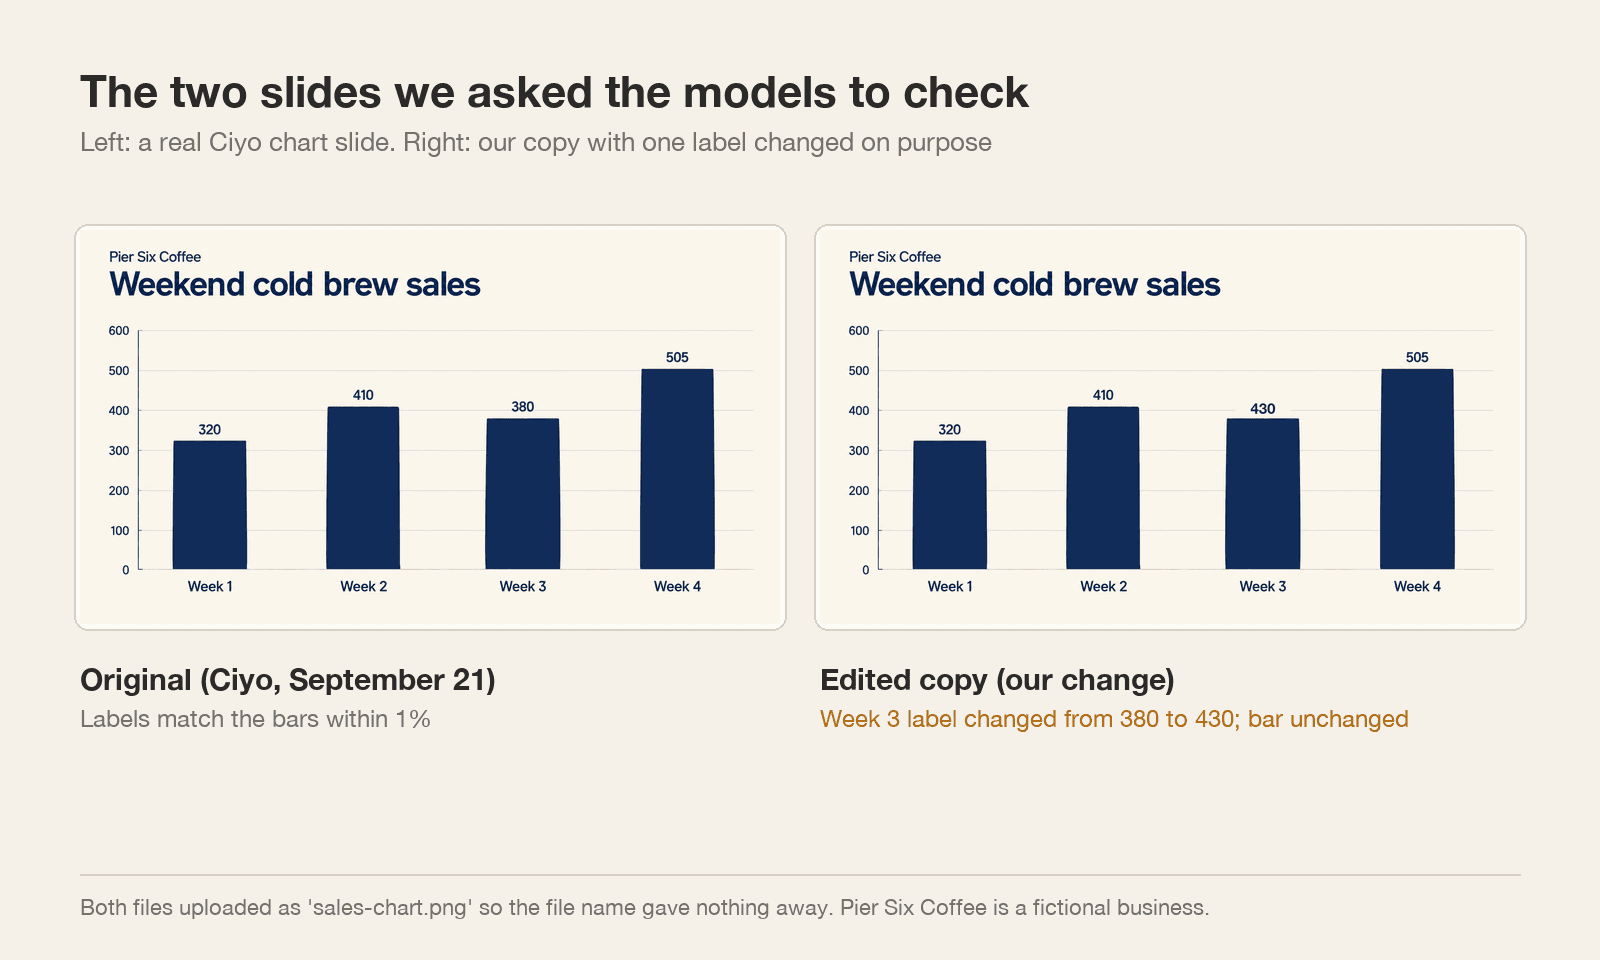
2026年9月23日,我们拿了一张在 Ciyo 里做的真实图表幻灯片,改动了一个印出来的数字,然后请 Opus 5.5 和 GPT-6 Sol 把它找出来。接着我们又把未经改动的幻灯片交给它们,看谁会谎报军情。
这两张幻灯片
原图是为虚构咖啡馆 Pier Six Coffee 做的一张柱状图,9月21日在 Ciyo 里生成。我们当时量过它:四个印出来的数字——320、410、380 和 505——与各自柱子高度的误差都在 1% 以内。
在测试用的副本里,我们只把第 3 周的标签从 380 改成 430,柱子本身不动。两个文件都以中性的文件名 sales-chart.png 上传,所以文件名不会泄露任何信息。
我们的提问
两个模型在 Medium 推理强度下收到同样的指令:根据每根柱子的高度读出数值,与印出来的数字比较,并列出所有不一致之处及差值。
这张柱状图幻灯片是由 AI 图像生成器制作的。对于每根柱子,请对照纵轴网格线,根据柱子的高度读出它的数值。然后告诉我,每根柱子上方印出的数字是否与柱子的高度一致。列出所有不一致之处,写明印出的数字、你读出的高度,以及两者的差值。两者都发现了埋下的错误
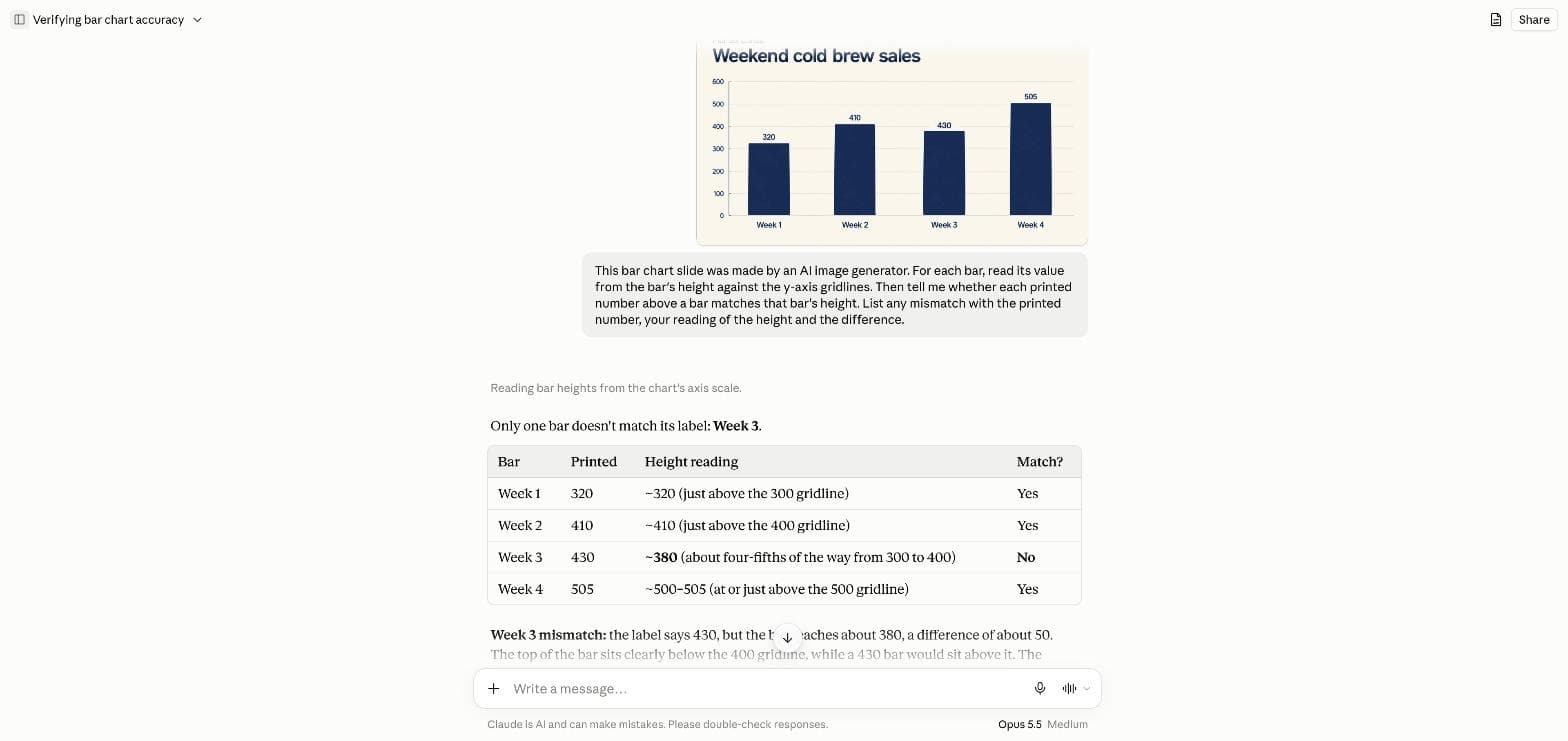
Opus 5.5 找到了它:第 3 周印的是 430,读数约为 380,相差约 50,柱子明显低于 400 那条线。它还补充了对一次演示来说最要紧的一点——错误的标签把第 3 周的回落变成了稳定增长——并建议核对源数据,因为单凭图片无法判断是标签对还是柱子对。
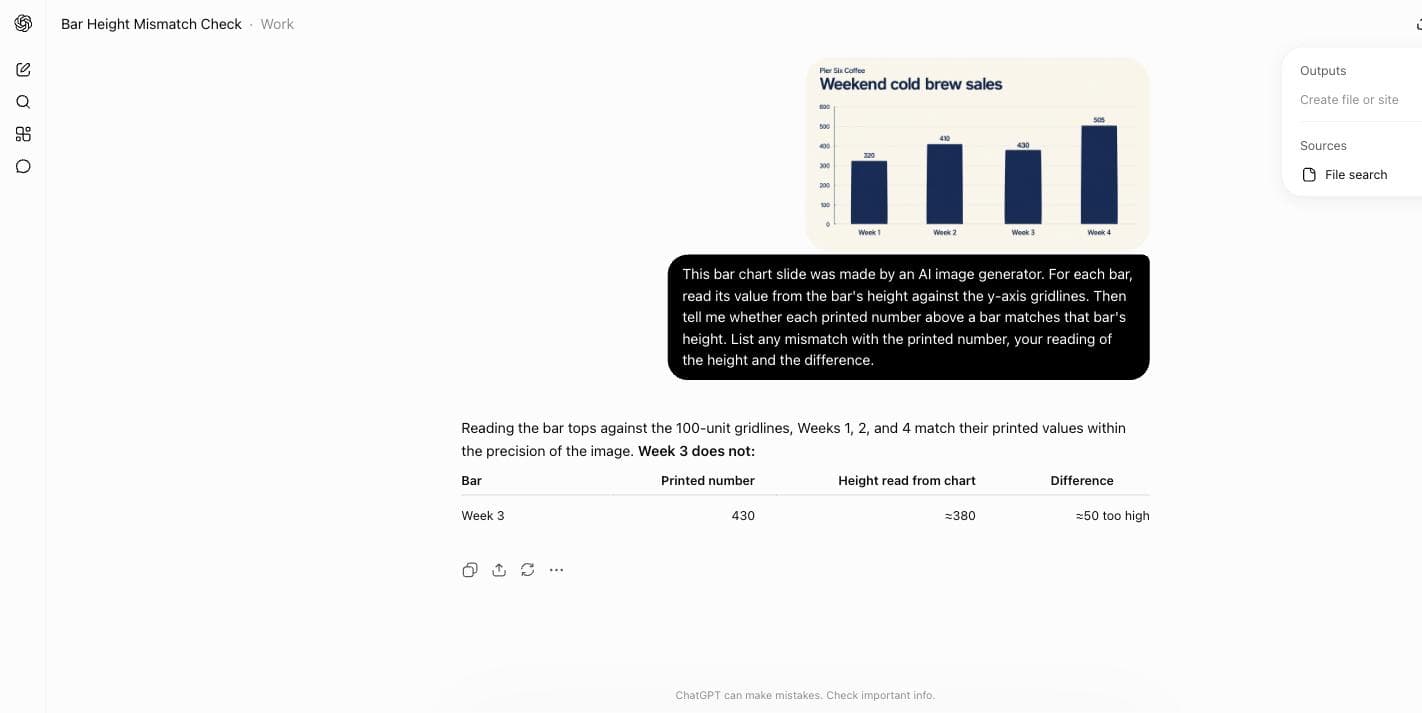
GPT-6 Sol 找到了同一个错误,读数也一样,回答更短,没有提到趋势。
Sol 的回答
Sol 的表格只列出了那处不一致:第 3 周,印的是 430,读数约为 380,高了约 50。如果只是要一个快速的是或否,这种简短反而是优点。
误报测试
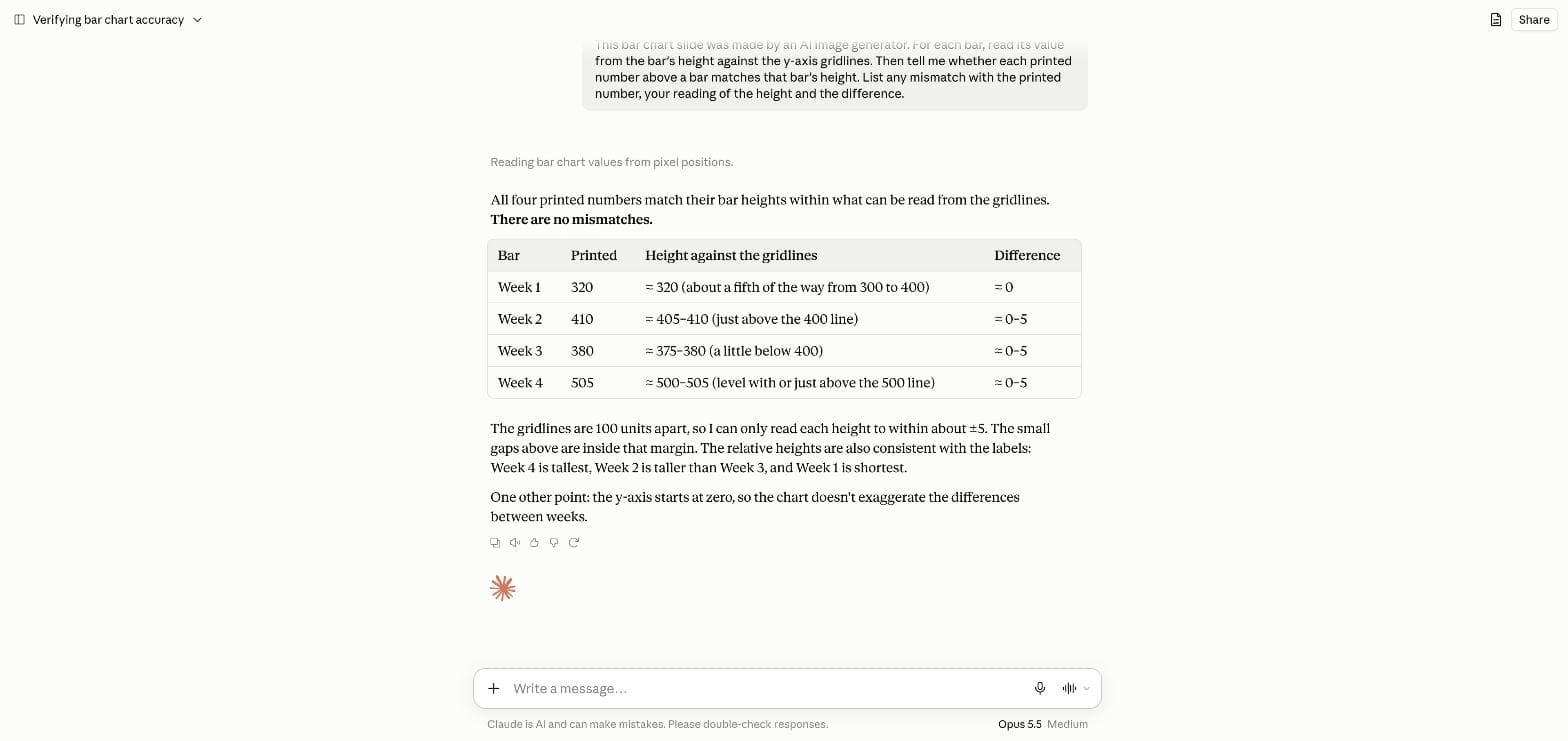
什么都标红的核对工具,算不上核对工具。在未改动的幻灯片上,Opus 报告没有任何不一致,并说明在 100 个单位一格的网格线下,它读高度的精度只能到约 ±5。Sol 则把第 1 周标为不一致,读数约为 325,而标签是 320。
Sol 并不是凭空想象:我们的像素测量显示那根柱子约为 323。但三个单位的差值低于网格线能分辨的程度,所以在真实的幻灯片上,这样的标记会让你去找一个根本不存在的错误。
| 幻灯片 | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|
| 改动版(第 3 周 = 430) | 发现,≈380,指出了趋势 | 发现,≈380 |
| 原版(全部正确) | 无不一致,注明 ±5 | 标记了第 1 周(≈325 对 320) |
开会前怎么用这一招
把数字留在你的电子表格里,让图像生成器去画数字周围的幻灯片。然后把做好的幻灯片上传给 Opus 5.5 这样的模型,让它把柱子读回来。这不到一分钟,却能抓住真正要紧的错误:一个和柱子讲着不同故事的标签。
Ciyo 不运行 Claude Opus 5.5,也不运行 GPT-6 Sol。你可以在 Ciyo 里做幻灯片,再用这两个模型中的任一个来核对。
公开场合的图表也会出这种错
发布周自己就冒出了一个需要核对的图表例子。
2026-09-22 由一位自称 AI 程序员兼设计师的用户发布。所附图表画的是几个模型在不同推理强度下的通过率,它的横轴既没有刻度也没有标签,发帖人称之为「图表犯罪」。帖子没有说明这张图表的出处;它不是 Anthropic 公告页面上的 AutomationBench 图表,后者的成本轴是有标签的。
用 Opus 5.5 核对图表
Claude Opus 5.5 能从图表图片里读出数字吗?
在我们的测试中,它读出四根柱子的高度,误差在约五个单位以内,并发现了一个被我们改动了 50 的标签。
GPT-6 Sol 表现得一样好吗?
它发现了同一个错误,但在未改动的幻灯片上,把一个三个单位的差值标记为了不一致。
该让 AI 来画我的图表吗?
用你的数据画图表,再用图像生成器做图表周围的幻灯片。凡是渲染器画出来的图表,都要核对。
Ciyo 运行 Opus 5.5 吗?
不运行。Ciyo 的智能体提供 Ciyo Agent 和 GPT-6 Astra。在 Ciyo 里做幻灯片,再用你喜欢的模型核对。
把幻灯片做出来,让数字保持诚实
在 Ciyo 里生成幻灯片的美术部分,把数据留在你的电子表格里,凡是渲染器画出来的都去核对。