AI 模型 · 数字
核对 Jev 的价格与速度说法
每一次发布都会带来一个倍数,而 Jev 的倍数很大:在“同等前沿智能水平下”快 40 到 200 倍,输入每百万 token $0.042,输出 token 则是 “FREE (too cheap to meter)”(免费,便宜到不值得计量)。
五天之后,来自公司外部的实测只有一份。本文把两者并排摆出来,而哪一个结果都不是发布帖会让你预期的样子。
TypeSafe 对外公布的内容
2026 年 9 月 15 日的发布文章给出的延迟区间是 70 到 500 毫秒,对照前沿语言模型的 3 到 329 秒,快 40 到 200 倍这个说法就是这么来的。文章还写了在生产工作流上快 193.6 倍、便宜 444.6 倍,以及零幻觉、零类型错误。
定价方式特别到值得说两遍:输入按十亿而不是百万计量,输出免费。TechCrunch 在 9 月 18 日的报道中同时列出了客户方的数字——Vercel 实测快 5 到 18 倍,另一个团队称比 Gemini 便宜 10 到 20 倍。
上面每一个数字都来自 TypeSafe 或它的早期用户。这并不说明其中哪一个是错的。它说明的是,它们全都未经独立验证。
| 说法 | 数字 | 来源 | 是否独立? |
|---|---|---|---|
| 延迟 | 70 到 500 毫秒,对照 3 到 329 秒 | TypeSafe 发布文章 | 否 |
| 生产工作流上的速度 | 快 193.6 倍 | TypeSafe 发布文章 | 否 |
| 生产工作流上的成本 | 便宜 444.6 倍 | TypeSafe 发布文章 | 否 |
| 可靠性 | 零幻觉,零类型错误 | TypeSafe 发布文章 | 否 |
| 价格 | 输入每百万 token $0.042,输出免费 | TypeSafe 定价 | 已公布,未经实测 |
| 客户方速度 | 快 5 到 18 倍 | Vercel,经由 TechCrunch | 否,由客户自行报告 |
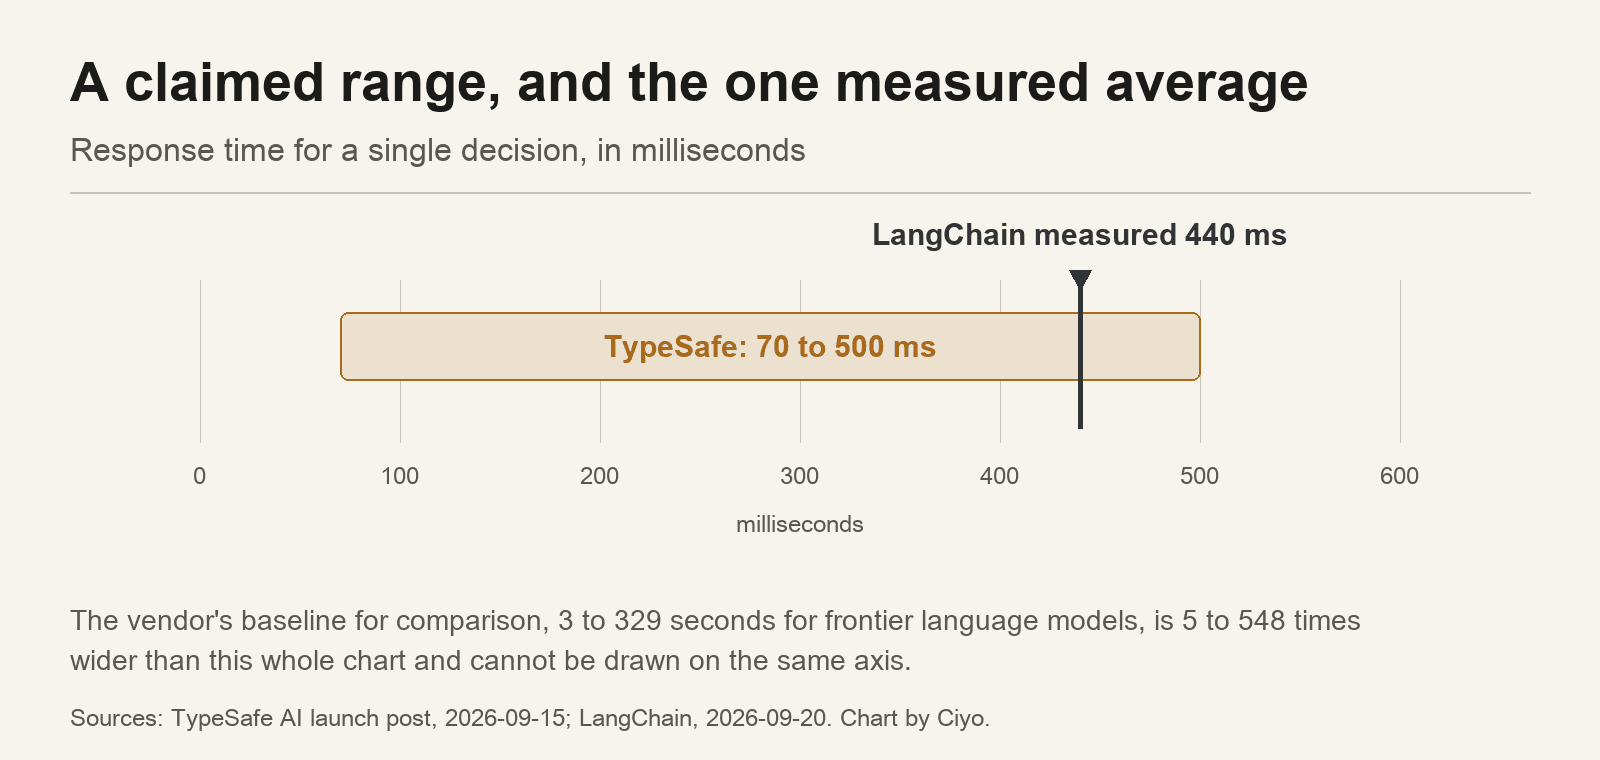
一个宣称的区间,和唯一一个实测的平均值
LangChain 在 9 月 20 日的实验报告称,每次调用平均 0.44 秒。把它放到发布文章那个区间的同一条轴上,它落在区间之内,靠近慢的那一端:440 毫秒,对照宣称的 70 到 500。
两件事同时成立,而这正是有用的观察。厂商的区间没有被推翻。那个标题上的倍数也没有被复现,因为倍数是一个比值,起决定作用的是分母。对照一个要花三秒的前沿模型,440 毫秒大约快七倍,而不是两百倍。
同一次运行花了多少钱
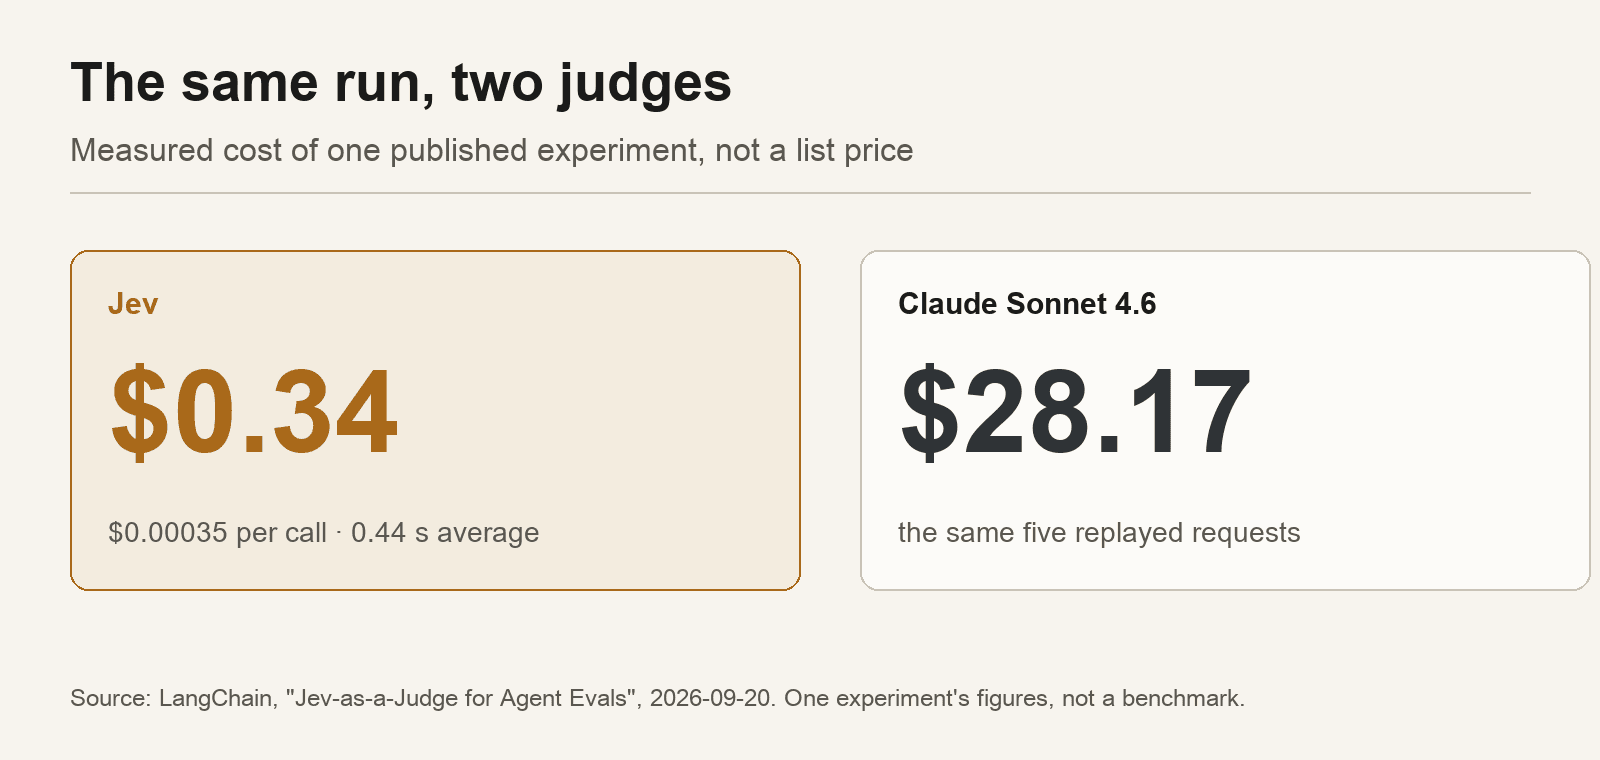
成本的对比要清楚得多。在 LangChain 的实验里,Jev 的一次判定花费 $0.00035,整轮重复判定合计 $0.34。同一轮用 Claude Sonnet 4.6 跑则是 $28.17,相差约 83 倍。
八十三不是四百四十四。但它也足以改变一个团队的做法:当一遍评估只要三分之一美元时,你不必再在覆盖率和预算之间二选一,而是可以把评审跑在每一条轨迹上,而不是抽样。
2026-09-20 由 Daniel Shea 和 Seán Roche 发布,附有公开代码仓库和锁定的版本。两天后 LangChain 与 TypeSafe 一起做了直播。
读数字的时候,把注意事项一起读
LangChain 自己写下了局限,这是一份值得读的测试的标志。这个实验建立在五个天气请求、在一个智能体上回放的基础之上。方差的结果被描述为观察到的现象,而不是训练目标造成了它的证据。他们还提醒说,低成本会放大错误,因为一个始终判错的评估器会大规模地产出糟糕的反馈。
他们同时锁定了版本并公开了代码仓库,所以这次运行是可以复现的。这就是基准测试和自吹自擂的区别,而在一次发布之后的第五天,这种做法比它应有的频率要罕见得多。
为什么输出 token 免费比那个倍数更重要
System One 模型返回的是一个带类型的值,不是一段话,所以它的输出从构造上就极小。对它不收钱与其说是打折,不如说是承认几乎没什么可收的。真正有意义的数字是输入价格,因为一条长轨迹是落在输入这一侧的。
TechCrunch 搬出了杰文斯悖论来描述接下来会发生什么,而这个类比正好贴合评估这件事:当一次判定便宜到不值得计数时,团队不会少花钱。他们会判定得多得多,维度更多,频率更高。预算的去向从“要不要评估”变成了“这么多反馈该拿来做什么”。
下一次发布该怎么核对
在转述一个数字之前,先找到原始出处和它的日期。问问是谁做的测试,他和厂商是什么关系。去找方法:重复了多少次,对照的基线是什么,任务是什么。然后问问测试里的任务和你真正要跑的任务像不像,因为一个模型完全可能在给天气回答打分上表现出色,而在其他所有事情上都未经检验。
最后,核对可用性。Jev 没有开放权重,藏在早期访问候补名单后面,多数人接触到它的途径是 Cloudflare AI Gateway 这类基础设施。一个你用不上的数字只是谈资。
关于这些数字的问题
Jev 真的能快上 40 到 200 倍?
那是 TypeSafe 针对分类任务、对照前沿语言模型给出的数字。公司之外公布的唯一一份实测是每次调用平均 0.44 秒,落在宣称的 70 到 500 毫秒区间之内,靠近慢的那一端。
一次调用要多少钱?
TypeSafe 列出的是输入每百万 token $0.042,输出免费。LangChain 实测每次调用 $0.00035,整轮运行 $0.34,而同一轮用 Claude Sonnet 4.6 要 $28.17。
有人正经做过基准测试吗?
还没有。目前只有一次窄实验,附带公开的代码仓库和锁定的版本,而做这次实验的公司在两天后与厂商一起做了直播。
继续阅读
Ciyo 关注创意工具和智能体工具背后的模型,并测试其中自己能跑的那些。