智能体 · 评估
Jev 在智能体循环中的位置:决策层
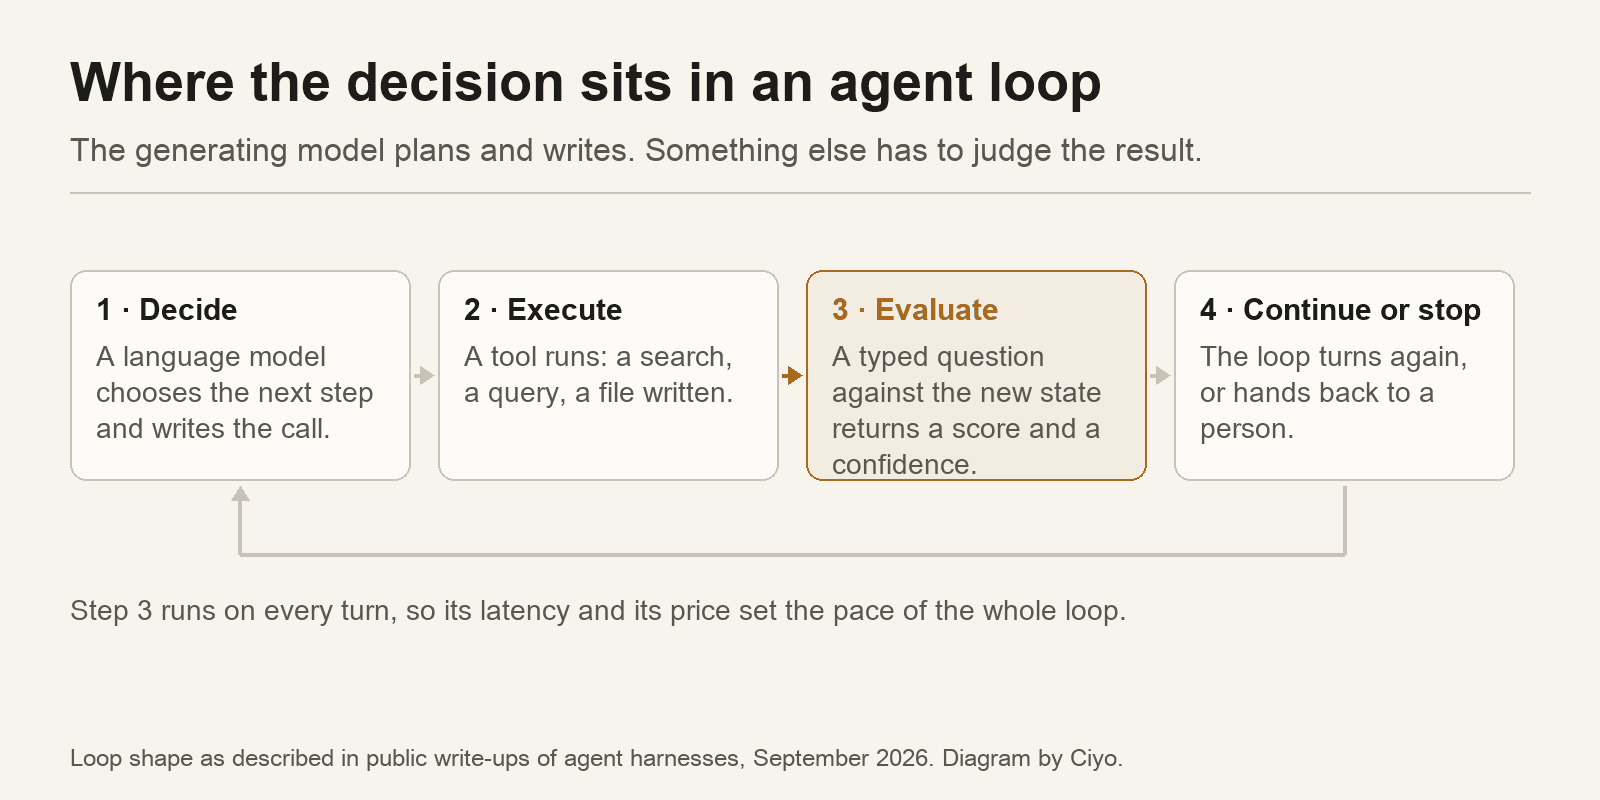
智能体是循环运转的。模型决定做什么,工具去执行,某个环节评估结果,然后循环再转一圈。前两步最受关注。第三步才是工程上通常最疼的地方。
TypeSafe AI 于 2026 年 9 月 15 日发布的 Jev,就是为这第三步而造的,除此之外什么都不做。本文讲它落在哪里、它替代了什么,以及公司之外第一份公开测试究竟量了什么。
今天团队判断一个步骤的两种做法
基于代码的评估出现得最早,至今仍是最便宜的办法。一个函数去检查智能体有没有调用工具、JSON 有没有解析成功、数字是否在范围内。它快、确定、但很窄:它需要固定的输入,而智能体的行为并不固定。要判断智能体有没有用工具的结果把用户的问题答好,这不是你用几个条件分支能穷举出来的。
于是团队转向 LLM 评审:把非结构化的轨迹丢给它,用一条提示词打分。这买来了通用性,代价要付三次:一是延迟,因为判断是一个 token 一个 token 写出来的;二是钱,每次调用都要付;三是波动,同一条轨迹跑两次可能得到不同的分数。
第三种选择,是用一个把评估当作它本来面目的模型:这是一个决策任务。给它一份状态和一个带类型的问题,返回带类型的答案和概率。
System One 模型放在哪里
它的位置是第三步。它不做规划,不调用工具,也不写下一条指令。它只看循环刚刚产生的状态,回答那些答案由你事先声明好的问题。
这个位置也解释了为什么它的延迟和价格比看上去更重要。第三步每一轮都要跑,而在在线场景下,它可以跑在很大一部分生产轨迹上,而不只是抽样——而“抽样还是全量”正是成本通常逼着团队去做的那个取舍。
问若干个小问题,而不是一个大问题
地道的写法不是用一条提示词去要一个结论,而是一组原子化的问题,每一个都声明好自己的答案,针对同一份状态评估,再在你自己的代码里组合起来。
TypeSafe 的文档说,每一个问题都针对同一份状态并行、独立地一次性评估,而且增加问题几乎不会改变响应时间。所以自然的设计是铺开一把窄问题:工具有没有被调用,回答有没有基于检索到的证据,按一到五分的标准它有多大用处,这三种检索结果里哪一种能描述这次运行。
每一个问题都带着概率回来,而组合逻辑留在你看得见、测得了、改得动的地方,不必去动提示词。
已公开的那次测试发现了什么
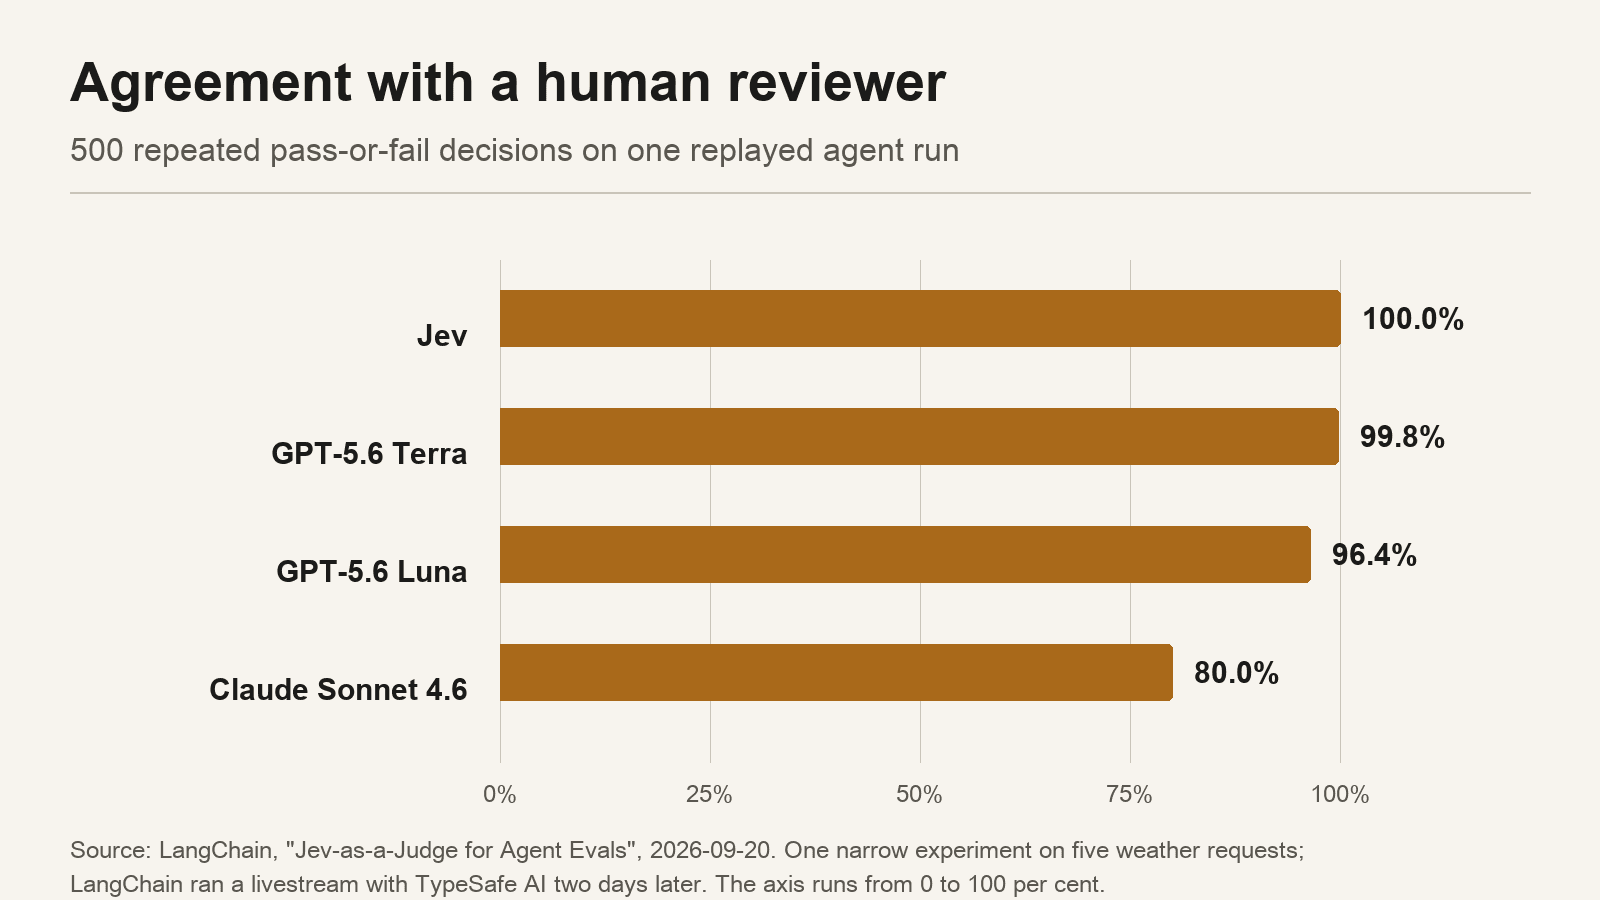
2026 年 9 月 20 日,LangChain 公开了一次实验:用 Jev 充当评审,并在同一段回放的智能体运行上与三个语言模型对比。在通过与否的二元判断上,Jev 与人工审阅者在全部 500 次重复判断上都保持一致;GPT-5.6 Terra 的一致率是 99.8%,GPT-5.6 Luna 是 96.4%,Claude Sonnet 4.6 是 80.0%。
可重复性是更锋利的那个结果。在连续的质量分数上,Jev 每个案例的平均方差是 0.0000149,LangChain 称这比那三个语言模型低 92 到 913 倍。准确度告诉你一位评审是否与人一致;方差告诉你它明天会不会还这么说。一套测试装置两者都需要。
LangChain 对这次测试不能证明什么很谨慎。他们称这是一次基于五个天气请求的窄实验,把方差结果描述为观察到的现象而非因果结论,并公开了代码仓库和锁定的库版本,方便别人复现。他们还在两天后与 TypeSafe 一起做了直播,这一点在掂量这份报告时值得知道。
发布于 2026-09-18。一位开发者对同一种循环模式的记录:LLM 决策,工具执行,模型评估。
值得提前防范的那种失败
便宜的判断会改变行为。当一次判定只要几分之一美分时,你就不再抽样,而是开始评估全部,这正是它的意义所在。但这也意味着,一位在某个方向上一贯判错的评审,现在会在所有地方悄无声息地、大规模地判错。
LangChain 把这一点直说了出来:低成本会放大错误,一个始终判错的评估器只会更快地产出糟糕的反馈。低方差会让这件事先变糟再变好,因为一位可重复的评审,在有人去核对之前,就是一个可重复的错误。
缓解办法很朴素。保留一份人工标注的基准集,每次改动问题就重新测一遍一致率,并且去读一部分被评审判为不合格的轨迹,而不是只读通过的那些。
| 做法 | 长处 | 短处 |
|---|---|---|
| 基于代码 | 确定、几乎免费、可审计 | 输入必须固定;开放式行为它判断不了 |
| 用 LLM 当评审 | 能接受非结构化轨迹;通用 | 更慢、更贵,而且多次运行之间不确定 |
| System One 模型 | 带概率的类型化答案;可重复;便宜到可以对全部内容运行 | 没有开放式推理;评分标准一旦定错,就会一贯地错下去 |
接进来之前要先写下的东西
三样东西,没有一样是提示词。状态:每次调用模型到底看到什么,以什么形式。问题:每一个都要原子化,选项或评分标准都写明白,因为那就是类型。阈值:置信度为 0.9 时你的代码怎么做,为 0.55 时又怎么做。
最后这一样,正是这类模型把工作挪了位置而不是消灭掉的地方。语言模型把阈值藏在它的行文里;带类型的决策把数字交给你,逼着你自己定。本来就维护着标注评估集的团队会觉得这很轻松。没维护的团队则会发现,自己本来就该有一份。
关于智能体评估的问题
决策模型能完全取代 LLM 评审吗?
只能取代那些答案可以事先声明的问题。凡是需要解释、改写或开放式评论的,仍然需要一个会生成文本的模型。
问的问题越多,花的时间越多吗?
TypeSafe 的文档说,问题是针对同一份状态并行、独立评估的,而且增加问题几乎不会改变响应时间。
100% 的一致率算是基准测试结果吗?
不算。那是在五个回放的天气请求上做的一次窄实验,发布方还在两天后与该厂商一起做了直播。把它当作第一个数据点。
继续阅读
Ciyo 关注创意工具和智能体工具背后的模型,并测试其中自己能跑的那些。