图像生成 · 行为
同一条提示词,不同的图。每一次都是。
你终于抽到了满意的那张。为了再要一个尺寸,你把提示词又跑了一遍,结果来的是另一张:杯子不一样,光线不一样,氛围也不一样。你输入的内容一个字都没变。
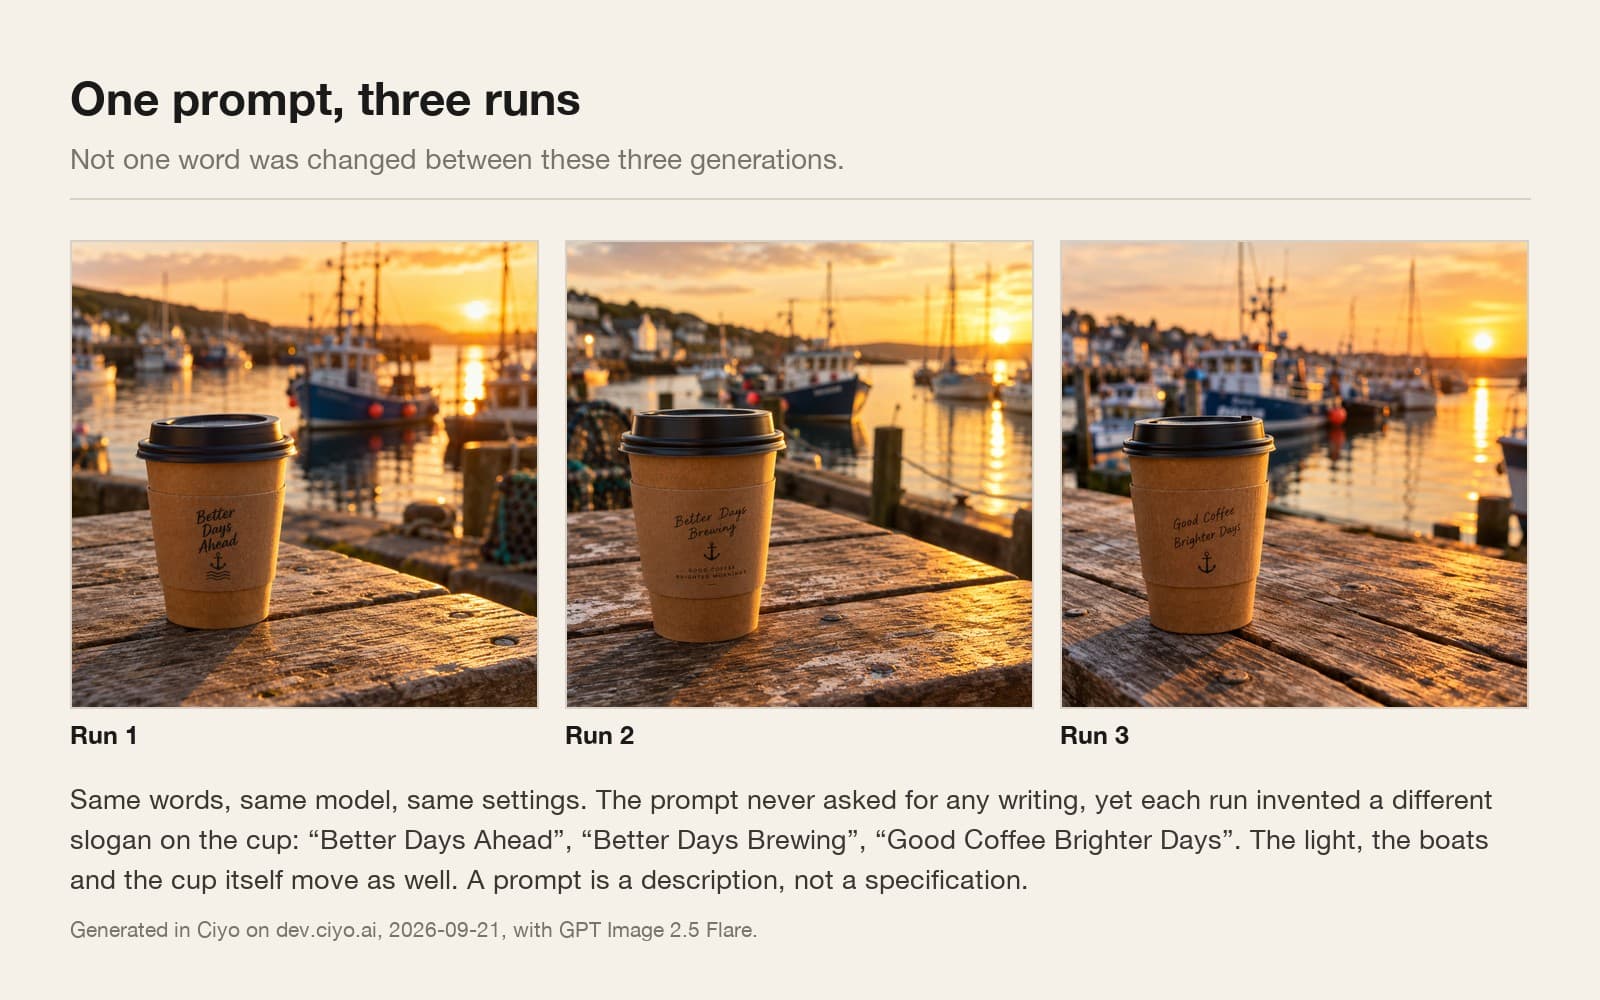
这是刚开始做图像生成的人最常遇到的意外,而且它并不是故障。为了准确展示到底能差多少,我们在 2026年9月21日把同一条提示词连着跑了三次,什么都没改。结果就在下面,其中一次还抓到了一件你在发布任何东西之前都该知道的事。
三次运行
一条提示词,分三次单独发送,模型相同、设置相同:黄昏金光下,一只外带咖啡杯放在饱经风霜的港口桌面上,背后的船只虚化。
先别看光线和构图那些明显的差别,去读杯子。提示词里完全没有提到任何文字。可三次运行都给它印上了不同的标语:先是「Better Days Ahead」,然后是「Better Days Brewing」,再然后是「Good Coffee Brighter Days」。
这才是真正影响生意的地方。生成器会自己编出你没要过的品牌,而且每次编的都不一样。如果你不读图就发布,你发的其实是别人脑子里那家虚构的咖啡馆。
为什么会这样
图像模型并不是去检索你的提示词、然后把对应的那张图取回来。它从噪声开始,一步步把噪声去掉,朝着符合你描述的方向调整。每一次的初始噪声都不同,所以路径不同,终点也就不同。
你的提示词是约束,不是坐标。「温暖而有吸引力」排除掉了海量的图,却仍然留下几百万种可能。其中每一种都是对你所提要求的合理回答。
描述用尽的地方,模型会拿一个看起来合理的东西把空缺补上。你没规定杯子上写什么,于是它写了点什么。你留白的每一处细节,它都会这样继续补下去。
当你需要第二次时该改什么
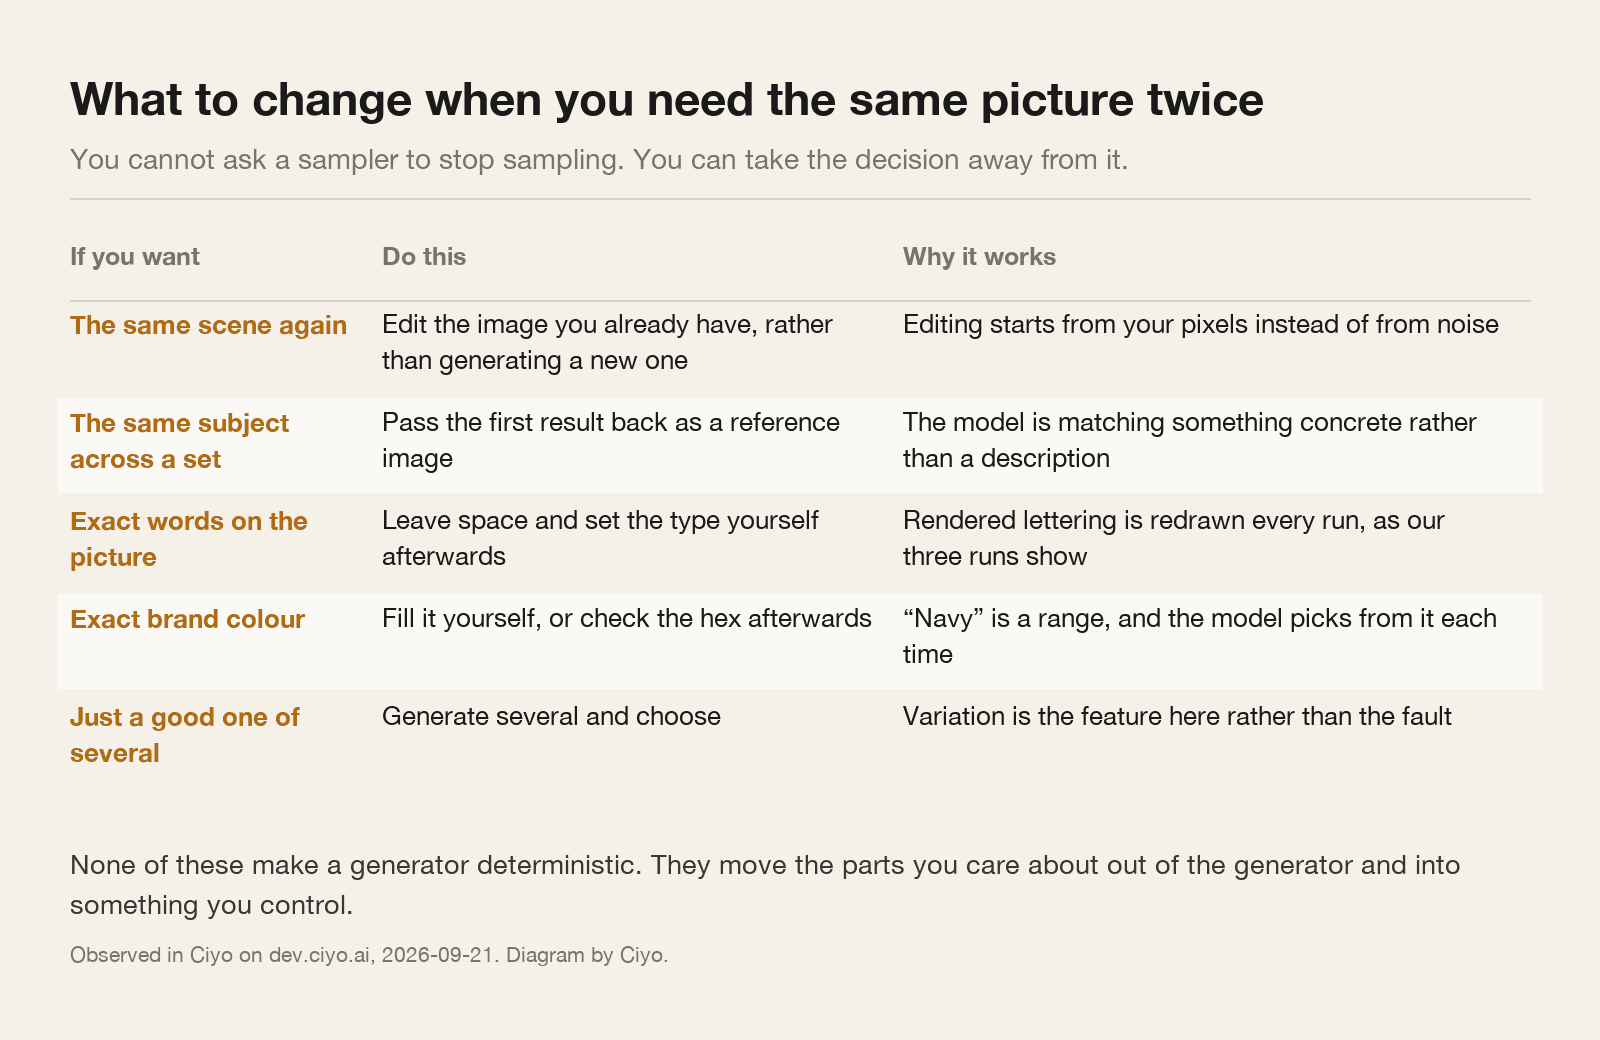
你没法叫一个采样器不要采样。你能做的,是把你在意的那几个部分挪出生成器,交给你自己能控制的东西。
去编辑,别重新生成
这是最省时间、也最不容易被想到的习惯。如果你喜欢某张图、又想改一点,那就编辑那张图。不要把提示词重写一遍再跑。
编辑是从你已有的像素出发的,所以凡是你没要求改的地方都会原样留着。重新生成则是从噪声重新开始,一切又都回到了抽签状态。
整组素材也一样。如果你需要四条看起来像一家人的帖子,先生成一条,再把它当参考图传给另外三条。这时模型比对的是一个具体的东西,而不是在揣摩一个形容词。
用画布上那张图,只改杯子:把上面所有文字去掉,让表面保持素面。桌子、光线、船只和构图全部原样保留,一点都别动。发布任何东西之前该做的检查
把图里出现的每一个字都读一遍。不是你接下来要写的配文,而是生成器画进去的那些字。
然后检查描述留白、而顾客又一定会注意到的地方:件数、包装颜色、手上的手指数对不对、背景招牌上有没有写着什么。
这只要十五秒,却能抓住编出来的标语、编出来的奖项和编出来的价格。这些东西都不在你的提示词里,而这正是它们容易被漏掉的原因。
| 会变的东西 | 变多少 | 你最好的抓手 |
|---|---|---|
| 图里的任何文字 | 每次都完全变 | 留出空位,文字自己排 |
| 光线、角度和背景 | 变很多 | 一张参考图 |
| 主体的形状和材质 | 变得很明显 | 参考图,或者改成编辑而不是重新生成 |
| 整体风格与氛围 | 如果提示词够具体就只变一点 | 风格用词要精确,并且每次保持一致 |
| 画幅比例和尺寸 | 完全不变 | 设置,这部分本来就归你管 |
当这种随机正是你要的
值得记住的是,正是这种行为让这个工具在一项工作刚开始时特别好用。如果你还不知道海报该长什么样,那么针对同一份需求给出四个不同答案,恰恰就是你想要的,而且挑选比描述更快。
挫败感只会在之后出现,也就是你已经定下来之后。所以把两个阶段区别对待:还在挑的时候就放开了生成,定下来之后就停止生成,开始编辑你选中的那一张。
那些输出很稳定的团队并没有什么秘密提示词。他们只生成一次,然后以第一张结果为基础,去编辑、去当参考,做完后面所有东西。
关于可复现性的问题
我能设定随机种子来再得到同一张图吗?
在 Ciyo 的画布里不行。实际可用的替代做法是:编辑你已有的那张图,并把它当参考图传给所有需要与之匹配的内容。
它为什么在我的产品上写了字?
因为你没说那里该写什么,而模型会拿看起来合理的东西填补空缺。在我们的三次运行里,它每次都编了一句不同的标语。
提示词写得更长会更可复现吗?
只会缩小范围,不会把它关死。写细有用,但描述永远成不了规格:凡是你留白的地方,仍然是别人替你决定的。
一整场活动都该用同一条提示词吗?
不该。先生成第一件,再把它当参考图用在其余素材上。比对一张图,比比对一段文字可靠得多。
生成一次,然后去编辑
先做出第一张并留好,其余的都从这张出发去搭,而不是从提示词出发。