モデル · System One
4つの案を評価する。そして意思決定モデルが埋める隙間
案を作るのは簡単なほうの半分です。そのなかから選ぶほうが、午後を丸ごと使う半分であり、たいていのクリエイティブツールがあなたに丸投げする半分でもあります。
そこで私たちは、レビューの工程を実際にひととおり回してみました。架空の港沿いカフェのための正方形の販促投稿を4つ、書き出した基準を4つ、そして各投稿を各基準で採点するよう求めたモデルです。結果は役に立ちましたし、同時に、Jev のような型のついた意思決定モデルが取り除くために作られた弱点を、そのまま見せてくれました。Ciyo は Jev を実行できません。画像も動画も生成せず、Ciyo のどちらのモデルレジストリにも載っていないからです。ですからこの記事では、今日動くものを示したうえで、別のものが入る継ぎ目に印を付けます。
4つの案、ひとつのオファー
依頼は、Pier Six Coffee という架空の港沿いのバーのための、週末のドリンク販促でした。Salted Maple Cold Brew を 4.50 で、土日のみ、港を歩く人に向けて。これを 2026年9月21日 に Ciyo で実行しました。最初の依頼から投稿が1枚返り、残りの3枚は意図的な別案として生成しました。グラスの寄り、港の手すりで持ったカップ、カウンターの俯瞰です。
案が4つというのは現実的な数です。すべてを頭の中に並べきれない程度には多く、それでいて人が一枚ずつ本当に見られる程度には少ない数です。
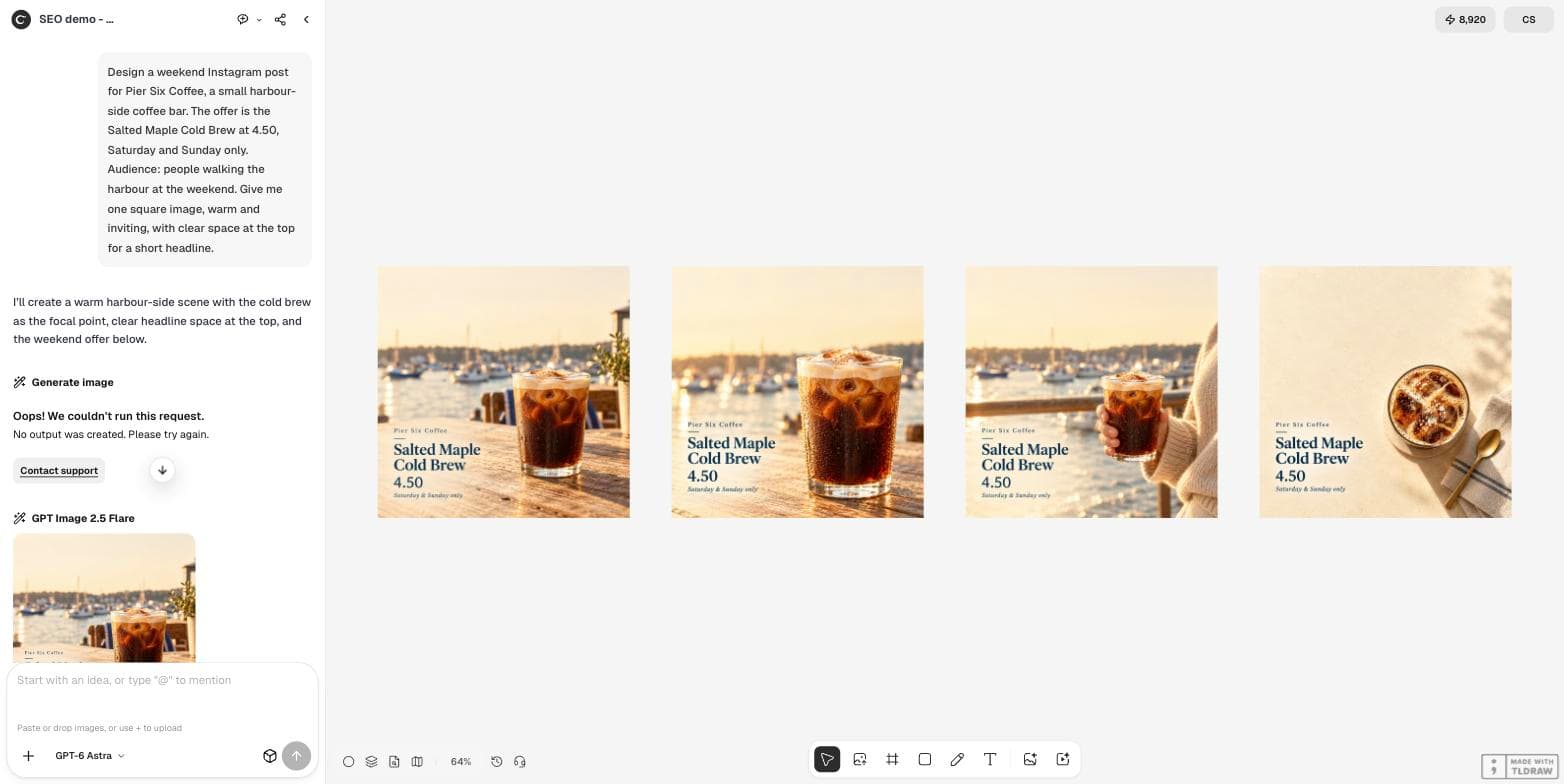
見る前に基準を書く
レビューの工程を値打ちのあるものにする規律は、案を見る前に、何を評価するのかを書き留めておくことです。そうしなければ、最初から気に入っていたものに、あとから理屈を付けることになります。
基準は4つ、どれも答えの出る問いにしました。飲み物が最初に目に入るか。価格がサムネイルの大きさで読めるか。空けておいた見出しの場所が本当に空いているか。週末の港の情景として読めるか。どれも、このブランドを見たことのない人でも確かめられます。
キャンバス上の4つの投稿を読んでください。4つの別々の基準で、それぞれを 1 から 5 で採点してください。各項目は個別に判断してください。(1) 飲み物が最初に目に入るか、(2) 4.50 の価格がサムネイルの大きさで読めるか、(3) 上部の見出しの場所が本当に空いているか、(4) 週末の港の情景として読めるか。投稿ごとに1行、基準ごとに1列の表を作り、そのうえで、投稿すべきものと、その理由をひとつだけ挙げてください。返ってきたもの
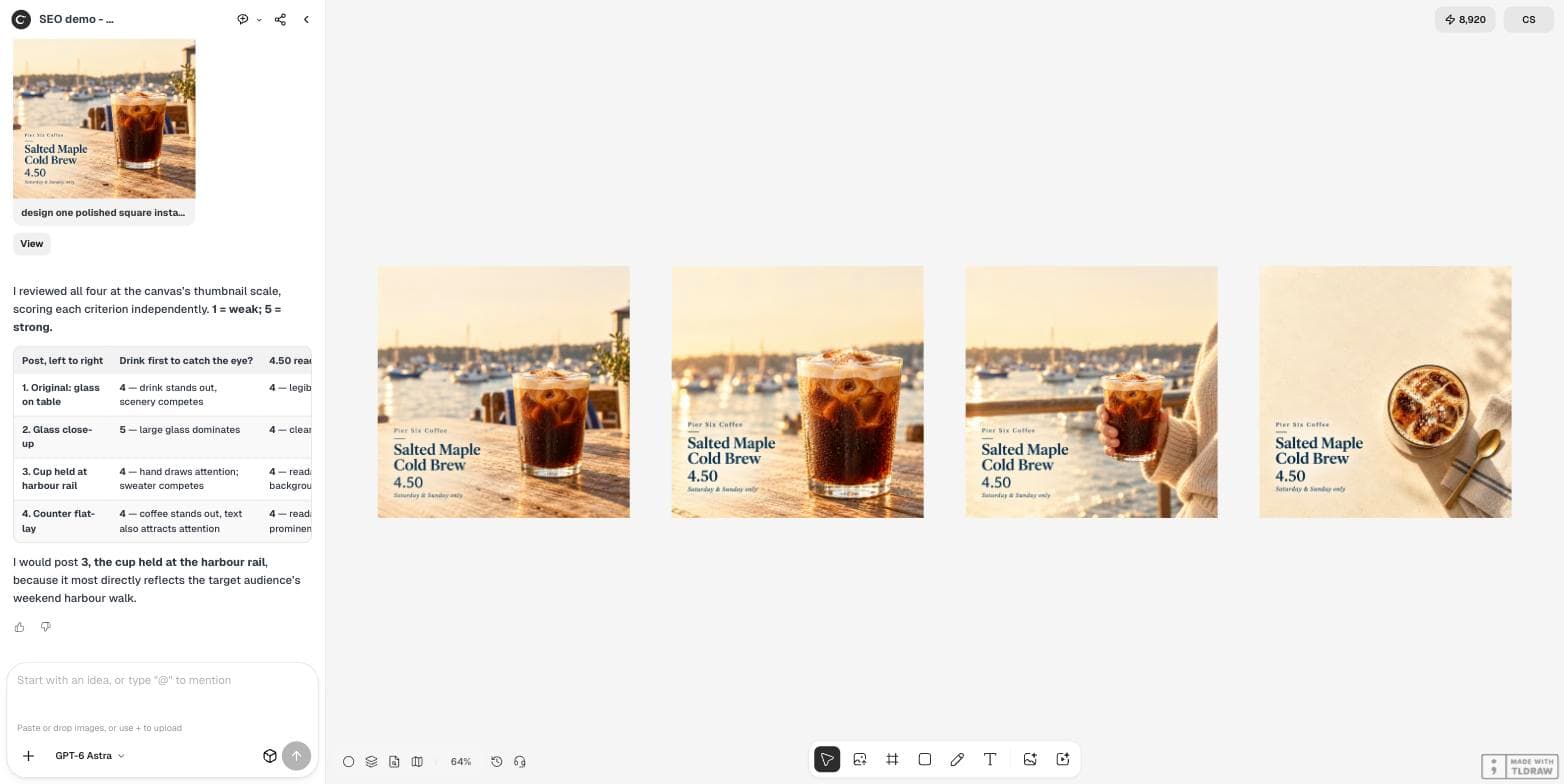
うまくいきました。モデルは4つすべてをサムネイルの大きさで読み、各セルに短い根拠を添えた4行4列の表を作り、勝者を1つ挙げました。港の手すりで持たれたカップです。理由は「読者の週末の港沿いの散歩を、もっとも直接に映しているから」。最初に書き出した基準に照らして導かれた、筋の通る答えです。
本当の失敗も1つ捉えていました。カウンターの俯瞰は「週末の港の情景として読めるか」で 1 が付き、目に見える港の手がかりがなく、週末であることはコピーだけで伝えられている、という注記が添えられていました。これはまさに、午後4時に4つ目の案を見るころの人間が見落とす種類のものです。
弱点を明かす数字
セルは 16 個。そのうち 15 個が 4 か 5 で返ってきました。表全体で差を付けた唯一の点数が、あの 1 です。
つまりこの表は、壊れているものを見つけるのは得意で、順位を付けるのは苦手です。どの案が壊れているかは確かに教えてくれます。けれども、残った3案のうちどれが最良かは、確かには教えてくれません。1 から 5 の尺度の真ん中が使われないからです。
これはこのモデルの欠陥でも、この指示文の欠陥でもありません。判断を、数字を含んだ文章として表現させたときに起きることです。
| 問い | 十分に答えられたか | 理由 |
|---|---|---|
| 壊れている案はあるか | はい | 俯瞰の案は港の情景で 1 が付き、具体的な理由も添えられていた |
| 良いもののうち、どれが最良か | いいえ | 16 セル中 15 が 4 か 5 だった。尺度が差を付けられなかった |
| 明日も同じ点数になるか | 分からない | 一度しか実行していない。再現性は、文章で採点する仕組みのいちばん弱いところ |
| 人間はやはり見るべきか | はい | ここではブランドの語り口は何も決まらず、勝者も理由ひとつで選ばれている |
System One モデルが座る場所
ここが継ぎ目です。型のついた意思決定モデルは、点数の入った文章を書きません。代わりに、あなたが宣言した型の値を、確率と信頼度の数値とともに返しますし、もう一度聞けば同じ値を返します。
この課題であれば、4つの Score 質問と明示的な評価軸、つまり「1 から 5」ではなく、書かれた定義を持つ4つの名前付き段階を各投稿に当て、さらに全体の判定には `needs_a_human` を明示的に含む Choice を足すことになります。組み合わせの規則はあなたのコードに置けるので、有料出稿では読みやすさを雰囲気より重く、オーガニックの投稿ではその逆に、といった調整ができます。
得られるのは、より良い審美眼ではありません。毎回同じ意味を持つ点数、人が見るべき時を決める信頼度、そして指示文を書き直さずに読んで変えられる規則です。
失うのは理由のほうです。俯瞰の案に港の手がかりがないと教えてくれたあのセルは文章であり、意思決定モデルは文章を作りません。実際に面白い設計は両方を使います。順位付けと振り分けには型のついた点数を、それを説明する文章には言語モデルを当てるのです。
Jev がここでできないこと、率直に
投稿を見ることはできません。TypeSafe 自身のドキュメントには、state は文字列か、JSON オブジェクトか、テキスト値の配列でなければならず、画像・音声・動画はまだ対応していないと書かれています。目で見るレビューは、今日のこのモデルが受け取れる範囲の外です。
案を作ることもできません。画像も動画も生成しませんし、だからこそ Ciyo のどちらのモデルレジストリにも載らず、Ciyo がそれを提供できない理由にもなっています。
ですから、この記事の考え方を正直に言えば、対象はテキストです。意思決定モデルが評価できるのは、依頼文、キャプション、代替テキスト、キャンペーンのメタデータ、生成物の構造化された記述、つまりクリエイティブの仕事のうち、すでに言葉になっている部分です。絵そのものにはやはり目が要りますし、今日その目は、あなたか、視覚を扱うモデルのものです。
それでもレビューの工程は回してください。見る前に基準を書き留めることが価値の大半で、それは手元のどのモデルでも成り立ちます。
レビューの工程についての質問
Jev は私の広告案を採点できますか
画像はできません。ドキュメント上の state はテキストのみ、つまり文字列か、JSON オブジェクトか、テキスト値の配列なので、画像は今日受け取れる範囲の外です。依頼文やキャプション、構造化された記述なら採点できます。
なぜ点数のほとんどが 4 か 5 で返ってきたのですか
判断を書かれた数字として表現する文章モデルは、尺度を上のほうに寄せてしまうからです。各セルに書かれた理由のほうが、その数字より多くを語っていました。
それでもレビューの工程を回す価値はありますか
あります。作ったその日の午後に、本当の失敗をひとつ捉えました。どのモデルで採点するにせよ、見る前に基準を書き留めることが利得の大半です。
Ciyo は Jev を実行しますか
いいえ。画像も動画も生成せず、Ciyo のどちらのモデルレジストリにも載っていません。この記事の採点は、Ciyo が実際に実行している GPT-6 Astra が行いました。
自分のレビューの工程を回す
案を4つ生成し、見る前に基準を4つ書き、エージェントに各案をすべて採点させてください。