エージェント · 評価
エージェントのループの中の Jev:判断の層
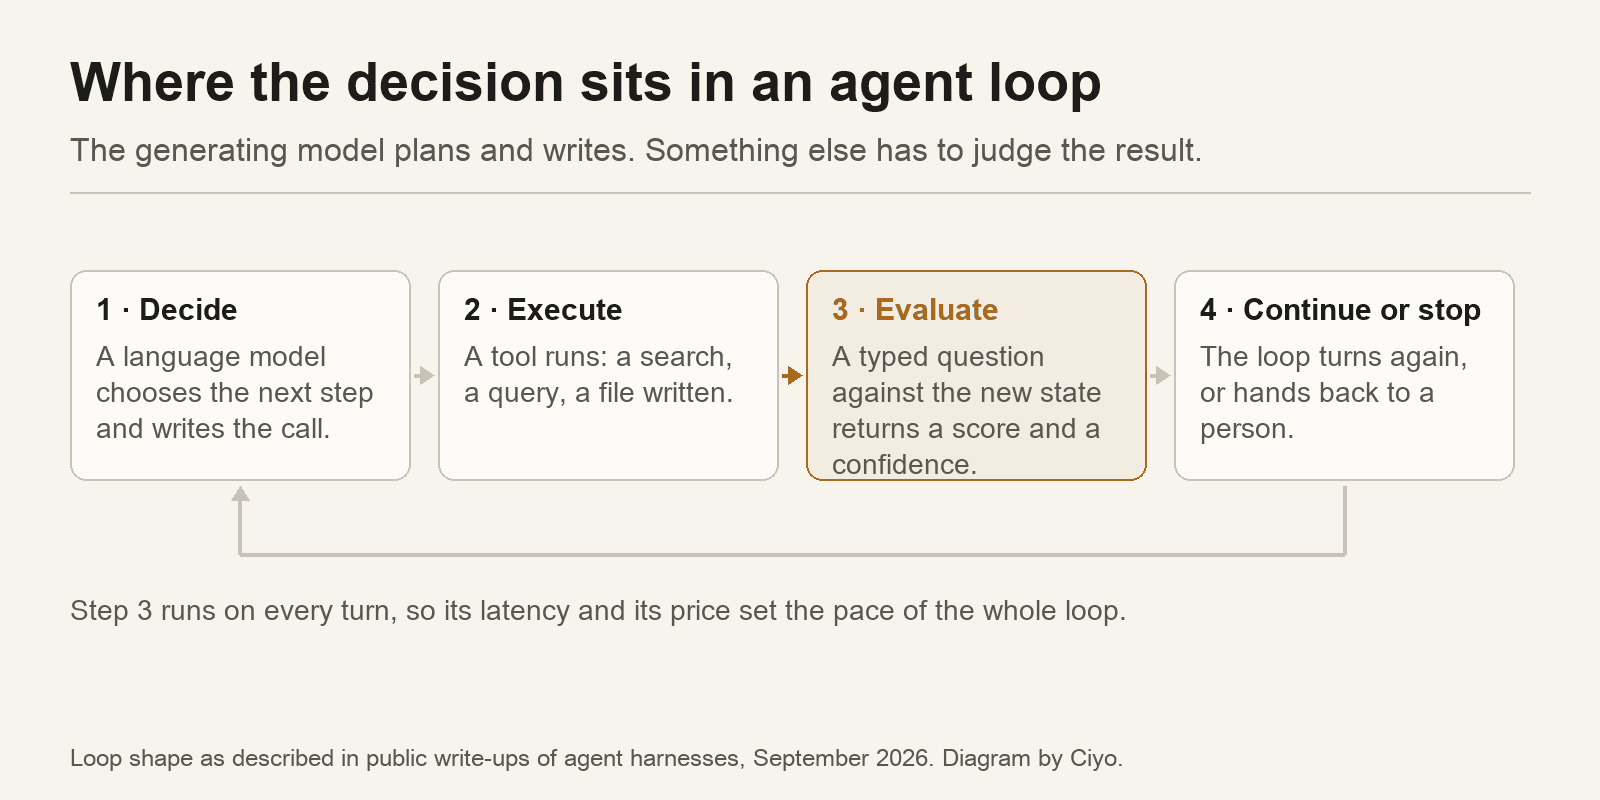
エージェントはループの中で動きます。モデルが次の行動を決め、道具が実行し、何かが結果を評価し、またループが回ります。注目されるのは最初の2つです。技術者が苦労するのは、たいてい3つめです。
TypeSafe AI が2026年9月15日に公開した Jev は、その3つめのためだけに作られています。この記事では、それがどこに入り、何の代わりになり、社外で最初に公開された試験が実際に何を測ったのかを見ていきます。
いま、現場が1つの手順を判定する2つの方法
コードによる評価が先にあり、いまでもいちばん安上がりです。エージェントが道具を呼んだか、JSON が解析できたか、数値が範囲に入っているかを、関数が調べます。速く、結果が毎回同じで、そして守備範囲が狭いのが特徴です。入力が決まっていることが前提ですが、エージェントのふるまいは決まっていません。道具の結果を使って利用者の問いにうまく答えられたか、という判断は条件分岐では数え上げられません。
そこで現場は、判定役の LLM に手を伸ばします。形の定まらない記録をそのまま受け取り、プロンプトで採点してくれます。その汎用性の代償は3つあります。応答時間です。判断が1語ずつ書かれるからです。費用です。呼び出すたびにかかります。そして、ばらつきです。同じ記録でも、2回実行すれば違う点数が出ることがあります。
3つめの選択肢が、評価をその正体どおり、判断の作業として扱うモデルです。状態と型のある問いを渡し、型のある答えを確率とともに受け取ります。
System One モデルが入る場所
入る場所は3つめの手順です。計画は立てず、道具も呼ばず、次の指示も書きません。ループが直前に作った状態を見て、答えをあらかじめ宣言してある問いに答えるだけです。
この位置にあるからこそ、応答時間と価格が見た目以上に効いてきます。3つめの手順は毎回動きますし、運用中であれば、標本だけでなく実運用の記録の大半に対して動かせます。費用のせいで現場が選ばされてきたのは、まさにそこです。
大きな問いを1つではなく、小さな問いをいくつも
この模型らしい書き方は、判定を求めるプロンプトを1本書くことではありません。答えを宣言した細かい問いをいくつか用意し、同じ状態に対して評価し、自分のコードで組み合わせることです。
TypeSafe の説明書には、すべての問いが同じ状態に対して並列に、互いに独立に、一度で評価され、問いを増やしても応答時間はほとんど変わらないと書かれています。ですから自然な設計は、狭い問いを扇形に並べることになります。道具は呼ばれたか、答えは取り出した根拠にもとづいているか、5段階の基準でどれくらい役に立つか、3つの検索の結末のどれに当てはまるか、といった具合です。
それぞれが確率とともに返り、組み合わせる処理は、自分で読めて、試験でき、プロンプトに触れずに変えられる場所に置かれます。
公開された1つの試験でわかったこと
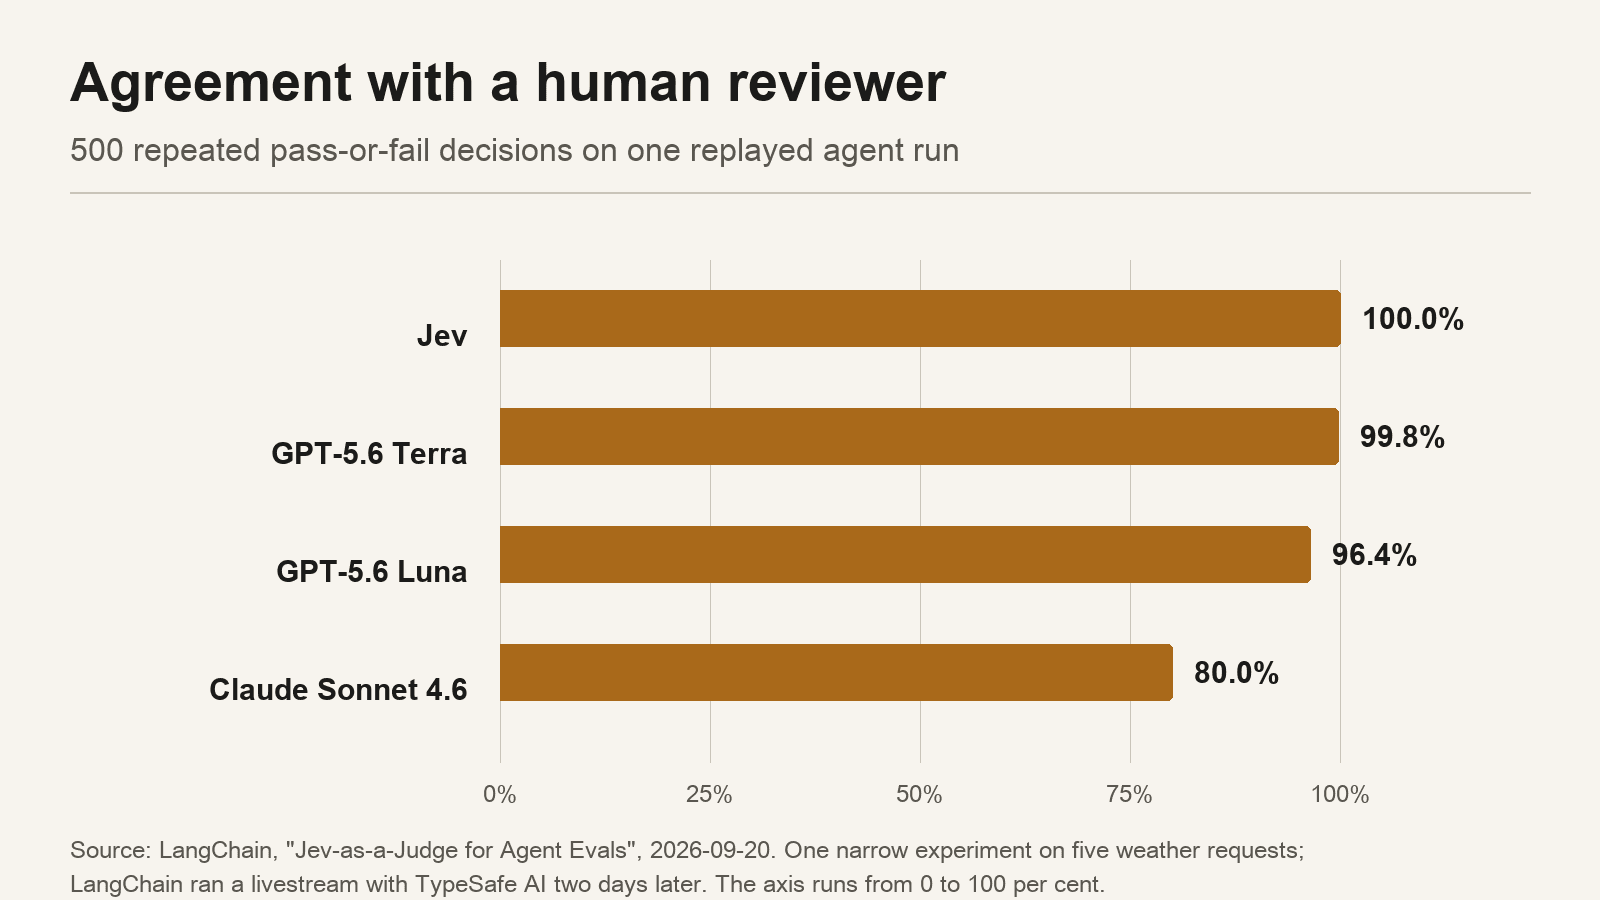
2026年9月20日、LangChain が Jev を判定役として使い、同じ再生したエージェントの実行で3つの言語モデルと比べた実験を公開しました。合否の二択の判断では、Jev は繰り返した 500 回の判断すべてで人の評価者と一致しました。GPT-5.6 Terra は 99.8 パーセント、GPT-5.6 Luna は 96.4、Claude Sonnet 4.6 は 80.0 でした。
より鋭い結果は、繰り返したときの安定性でした。連続値の品質スコアでは、Jev の事例ごとのばらつきの平均は 0.0000149 で、LangChain はこれを3つの言語モデルより 92 倍から 913 倍小さいと報告しています。正確さは判定役が人と一致するかを示し、ばらつきは明日も同じことを言うかを示します。試験の仕組みには、その両方が要ります。
LangChain は、これで何が言えないかにも慎重です。5件の天気の依頼にもとづく狭い実験だと述べ、ばらつきの結果は因果ではなく観察だと説明し、誰かが追試できるように保管庫とライブラリの固定した版を公開しています。また、その2日後に TypeSafe との生配信を行っており、この記事を評価するときに知っておく価値があります。
2026-09-18 の投稿です。同じループの形についての開発者の記録で、LLM が決め、道具が実行し、モデルが評価するという流れです。
設計で備えるべき失敗のしかた
判定が安くなると、ふるまいが変わります。1回の判定が1セントに満たなくなれば、標本抽出をやめてすべてを評価するようになります。それが狙いです。同時に、いつも同じ方向に外れる判定役は、静かに、大規模に、あらゆる場所で外れることにもなります。
LangChain はそれをはっきり書いています。費用が低いと誤りが増幅されうること、そして一貫して外れる評価役は、悪い手がかりをより速く生み出すことです。ばらつきの小ささは、良くなる前にこれを悪くします。繰り返し同じことを言う判定役は、誰かが確かめるまで、繰り返し同じ誤りを出し続けるからです。
対策は地味です。人が正解を付けた基準データを持ち続け、問いを変えたら一致率を測り直し、判定役が通したものだけでなく、落としたものの記録も抜き取って読むことです。
| やり方 | 得意なこと | 苦手なこと |
|---|---|---|
| コードによる評価 | 結果が毎回同じ、ほぼ無料、あとから検証できる | 入力が決まっている必要がある。形の定まらないふるまいは判定できない |
| 判定役の LLM | 形の定まらない記録をそのまま扱える。汎用性が高い | 遅く、高く、実行のたびに結果が変わる |
| System One モデル | 型のある答えと確率。結果が安定し、すべてに対して回せるほど安い | 開かれた推論はできない。評価基準が誤っていると、一貫して誤り続ける |
組み込む前に書き出しておくこと
3つあり、どれもプロンプトではありません。状態、つまり呼び出しごとにモデルが何をどんな形で見るのか。問い、つまり選択肢や評価基準まで書き下した、ひとつひとつが細かい問い。そして境目、つまり確信度が 0.9 のときにコードが何をし、0.55 のときに何をするかです。
最後のひとつは、この種のモデルが仕事を減らすのではなく移すところです。言語モデルは境目を文章の中に隠しますが、型のある判断は数字をそのまま渡し、あなたに決めさせます。正解を付けた評価用のデータをすでに持っている現場には簡単です。持っていない現場は、もともとそれが必要だったと気づくことになります。
エージェントの評価についての質問
判断用のモデルは、判定役の LLM を完全に置き換えますか?
答えをあらかじめ宣言できる問いについてだけです。説明や書き直し、開かれた批評が必要なものには、文章を生成するモデルが引き続き必要です。
問いを増やすと時間はかかりますか?
TypeSafe の説明書には、問いは同じ状態に対して並列に、互いに独立に評価され、問いを増やしても応答時間はほとんど変わらないと書かれています。
一致率 100 パーセントは、ベンチマークの結果と言えますか?
いいえ。再生した5件の天気の依頼にもとづく狭い実験が1件あるだけで、公開したのは、その2日後に提供元と生配信を行った会社です。最初の手がかりとして扱ってください。
続けて読む
Ciyo は、制作とエージェントの道具の背後にあるモデルについて書き、動かせるものは試しています。