模型 · 給設計師
大規模替代文字,以及它無法做的檢查
替代文字是個人人都同意、卻幾乎沒人審計的無障礙工作。它由上傳的人最後才寫,寫完之後就再也沒人看它一眼。
而且它很不尋常,是一項靠近創意、純文字模型幾乎可以整體接手的工作 —— 因為替代文字就是文字。一個 2026年9月15日 發佈的模型,用大約三分之一秒、花不到一美分,就能回答關於文字的若干已聲明問題。Ciyo 無法執行 Jev:它不生成影像也不生成影片,也不在我們的任何一個模型註冊表裡。但這類檢查器能告訴你什麼、不能告訴你什麼,這個分界是本文最有用的部分,無論你最後用哪款工具。
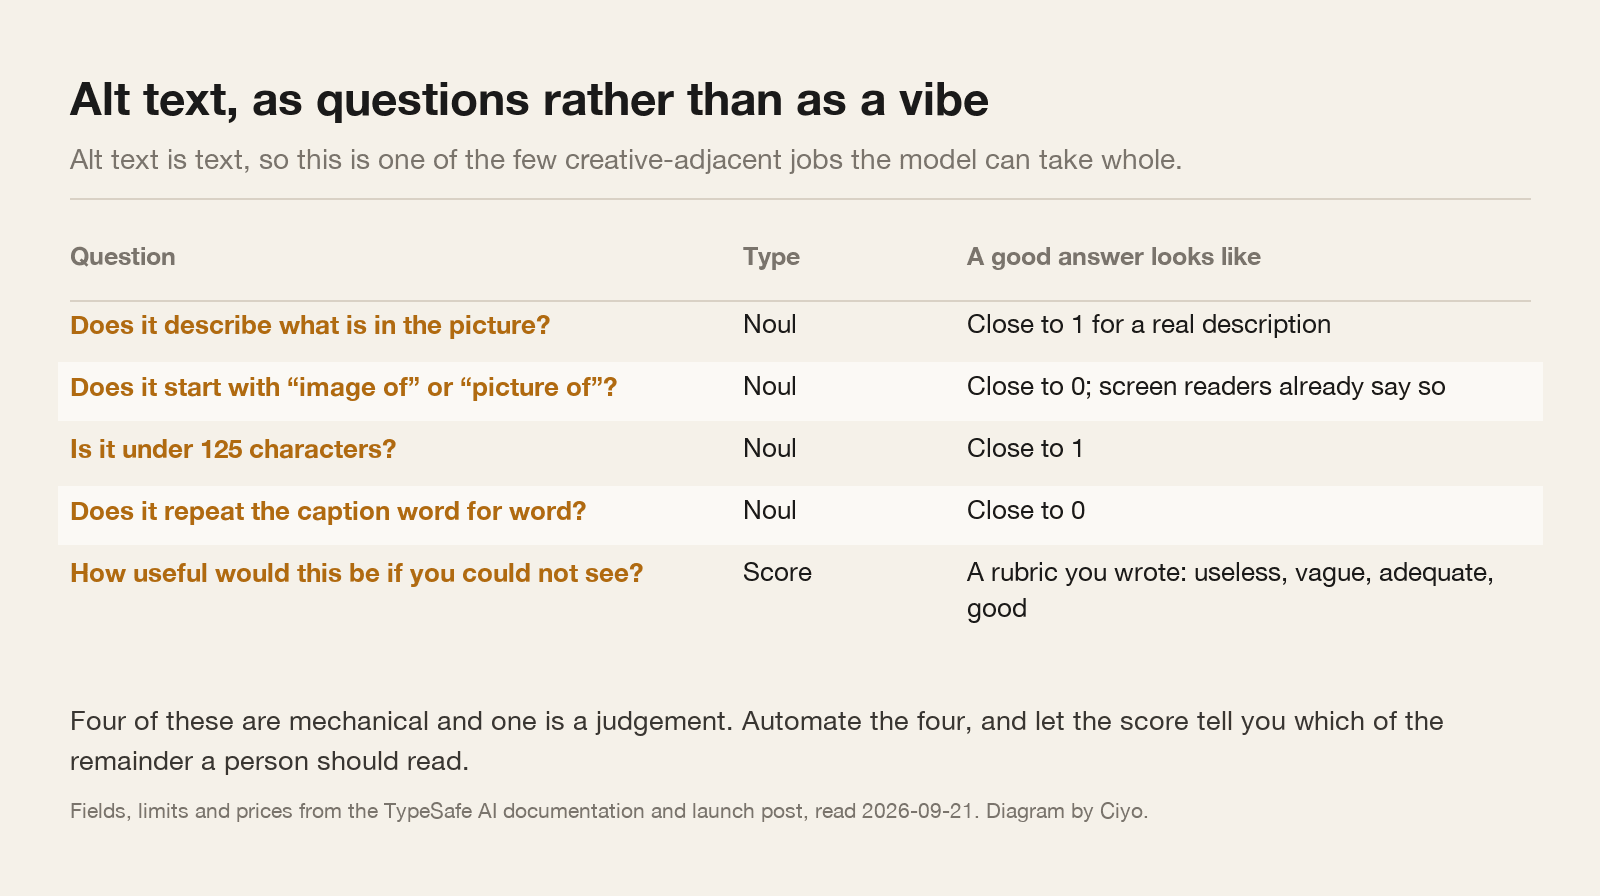
讓替代文字變好的要素,寫成問題
多數替代文字指南是一列原則。把原則變成帶有已聲明答案的問題,你就得到了可以在每一張曾經發布的圖上運作的東西。
其中四件是機械性的:長度、措辭、結構,以及它是否只是重複圖說。有一件是判斷,而那一件該打分數,而不是回答是或否。
它無法做的檢查,以及為什麼它比其餘都重要
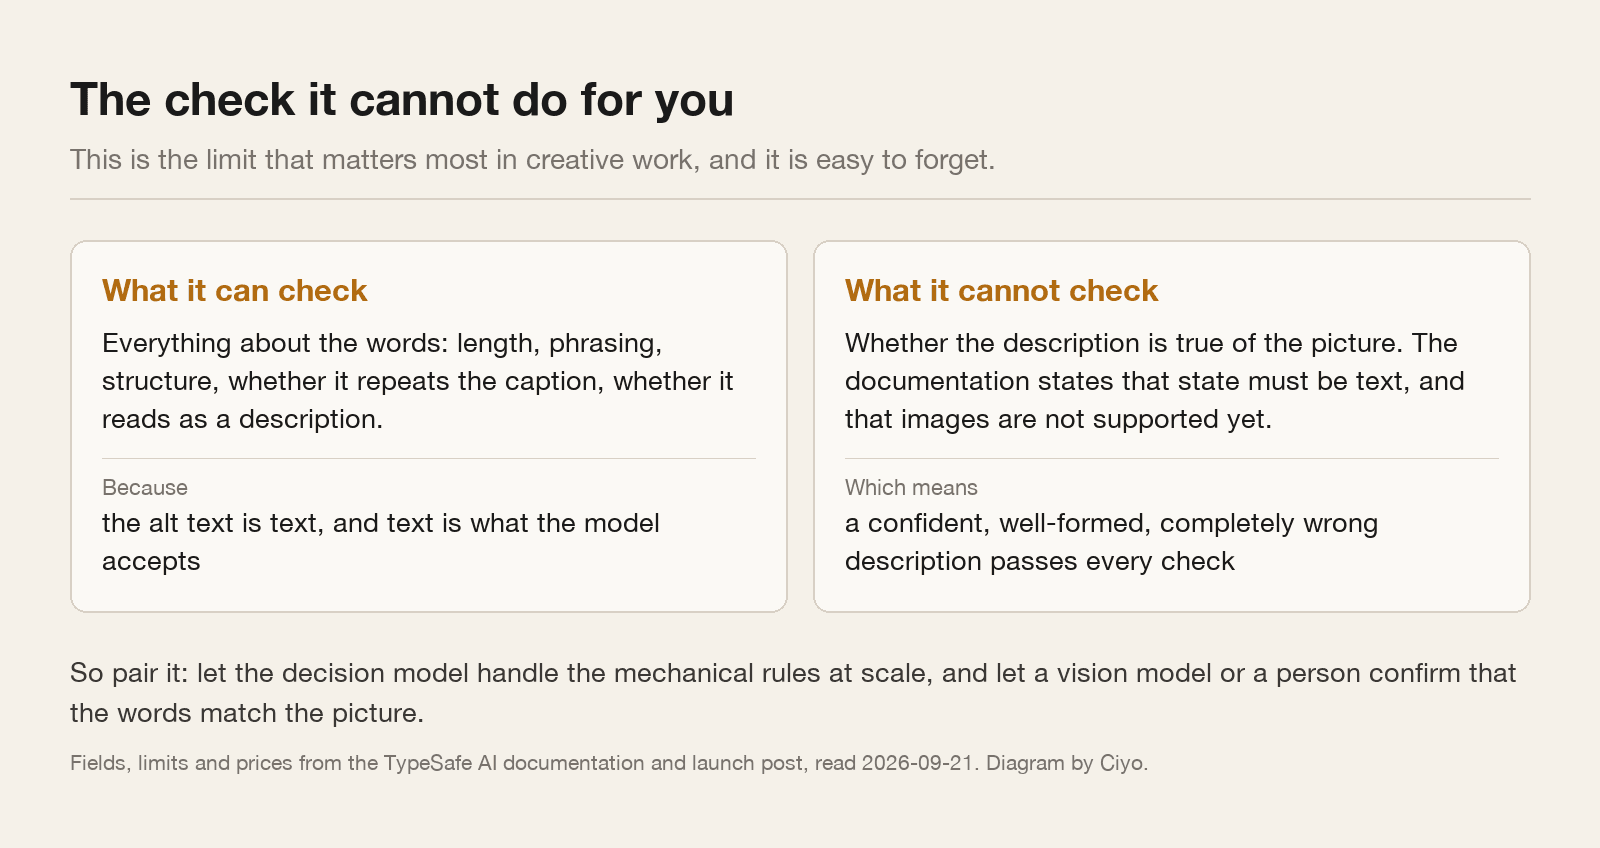
純文字模型讀你的替代文字。它從來看不到你的圖片。TypeSafe 的文件說,輸入必須是字串、JSON 物件或文字值組成的陣列,而且影像目前還不支援。
所以它能確認你的替代文字是一段格式良好、長度恰當、不重複的描述。它無法確認這段描述是否屬實。
「一隻藍色沙發上熟睡的金色尋回犬」完美通過每一項機械檢查。如果照片是廚房地板上的一隻貓,模型無從知曉,而螢幕閱讀器使用者會被以十足的信心告知一件假事。這種失敗比缺失替代文字更糟,因為缺失的替代文字至少對那道缺口是誠實的。
這是最值得記住的單一限制,它適用於每一個純文字檢查器,不止這一種。
所以把它配對用,別只信它一個
真正管用的設計,是用兩種不同的工具對付問題的兩個不同半邊。
讓決策模型在大規模上處理機械規則:每週在站點每一張圖上跑一遍,花幾美分。這一遍能找出空字串、被當成描述粘進去的檔名、替代文字只是重複圖說的那四十張圖,以及以「圖片中的」開頭的那些。
然後讓有眼睛的東西 —— 一個視覺模型,或一個人 —— 在樣本上、以及在分數標記為含糊的任何東西上,確認文字與圖片相符。那比全部小得多的一堆,正是重點。
| 問題 | 誰回答 | 頻率 |
|---|---|---|
| 到底有沒有替代文字? | 任何文字檢查器 | 每張圖,每週 |
| 長度和形狀對不對? | 決策模型 | 每張圖,每週 |
| 只是重複圖說嗎? | 決策模型 | 每張圖,每週 |
| 對看不見的人有用嗎? | 決策模型,作為分數 | 每張圖;讀那些低分 |
| 對這張圖是真的嗎? | 視覺模型,或人 | 一個樣本,加上所有被標記的 |
寫好評分表,讓分數有意義
有用性這個問題是分數,不是是/否,而分數需要帶定義的分級。兩到十級的評分表正是這類模型所期望的,級別由你來寫。
這裡用四級很合適:useless、vague、adequate、good。useless 是檔名或空字串。vague 是「產品照片」。adequate 點出主體和場景。good 給讀者本該從看圖得到的東西,包括周圍文字要緊的那個細節。
在跑任何東西之前先把定義寫好,並用手工對照它們給三十個真實例子打標籤。那組打了標籤的集合會告訴你分數是否在跟你的判斷走,即使你從不自動化也值得擁有。
state: { "alt": "...", "caption": "...", "page_title": "..." }

questions: {
  "describes":       { "type": "noul", "instructions": "替代文字描述的是可見的內容,而不是在命名一個檔案或類別。" },
  "redundant_open":  { "type": "noul", "instructions": "替代文字以「圖片中的」、「照片中的」或「圖中的」開頭。" },
  "length_ok":       { "type": "noul", "instructions": "替代文字少於 125 個字元。" },
  "repeats_caption": { "type": "noul", "instructions": "替代文字幾乎一字不差地重複圖說。" },
  "usefulness":      { "type": "score", "instructions": "這對看不見這張圖的人會有多大用處?",
                       "criteria": ["useless", "vague", "adequate", "good"] }
}
第一次掃描通常會發現什麼
預期結果比你以為的更糟,比你害怕的好修。
常見的發現到處都一樣:忙碌某個月裡一批完全沒有替代文字的圖、某人粘進檔名的那一段、以及替代文字又是圖說的長尾。這些沒有一個需要判斷才能修。它們需要一張清單。
含糊的那些,才是分數派上用場的地方。「我們的新系列」在技術上算描述,卻沒告訴螢幕閱讀器使用者任何東西,而機械規則永遠不會抓到它,因為它長度正確、也不重複任何東西。
並且在你寫的任何選項上都聲明一個退出項。一項 2026年9月20日 發佈的、預先註冊過的獨立評測發現,在沒有「這些都不是」可用時,三十個超出範圍的輸入沒有一個被標記 —— 最近的已聲明答案回來時看起來已經定了。
誠實的總結
你可以用每遍幾美分,把替代文字品質控制的五分之四自動化,而且你應該這麼做,因為替代方案是根本沒人檢查其中任何一項。
你無法自動化那五分之一 —— 它問文字對圖片是否屬實 —— 而那一項在出錯時最傷讀者。讓人或視覺模型永久地、在樣本上,守住那一項。
任何向你推銷「純文字工具、號稱能對照圖片驗證替代文字」的人,描述的都是其文件說模型做不到的事。
替代文字問題
純文字模型能檢查我的替代文字嗎?
它能檢查關於文字的一切:長度、措辭、結構,以及是否重複圖說。它無法檢查描述對圖片是否屬實,因為它從來看不到圖片。
替代文字應該多長?
少於大約 125 個字元是個合理的規則,而且是可以對每張圖運作的機械檢查。更長的描述通常更適合放在周圍文字裡。
替代文字應該以「圖片中的」開頭嗎?
不該。螢幕閱讀器已經宣告這是一張圖片,所以那些字只是白白佔用你的字元數。這是最容易自動化的檢查之一。
Ciyo 執行這個檢查嗎?
不能。Ciyo 不執行 Jev。Ciyo 的智慧代理可以為你生成的圖片起草替代文字,那是另一項工作:寫它,而不是大規模審計它。
繼續閱讀
Ciyo 寫的是創意和智慧代理工具背後的模型,並測試它能執行的那些。