模型 · System One
評判四個變體,以及決策模型補上的那道缺口
生成選項是容易的那一半。在它們之間做選擇,是吃掉一整個下午的那一半,也是大多數創作工具留給你自己的那一半。
於是我們認真地跑了一遍評審流程:為一家虛構的港口咖啡館做了四張方形促銷圖,寫了四條標準,並讓一個模型對每張圖按每條標準打分。結果很有用,也正好暴露出像 Jev 這種型別化決策模型旨在消除的弱點。Ciyo 無法執行 Jev —— 它不生成影像也不生成影片,也不在我們的任何一個模型註冊表之中 —— 所以本文展示今天能用的部分,並標出該由別的東西接手的那道縫。
四個變體,一個優惠
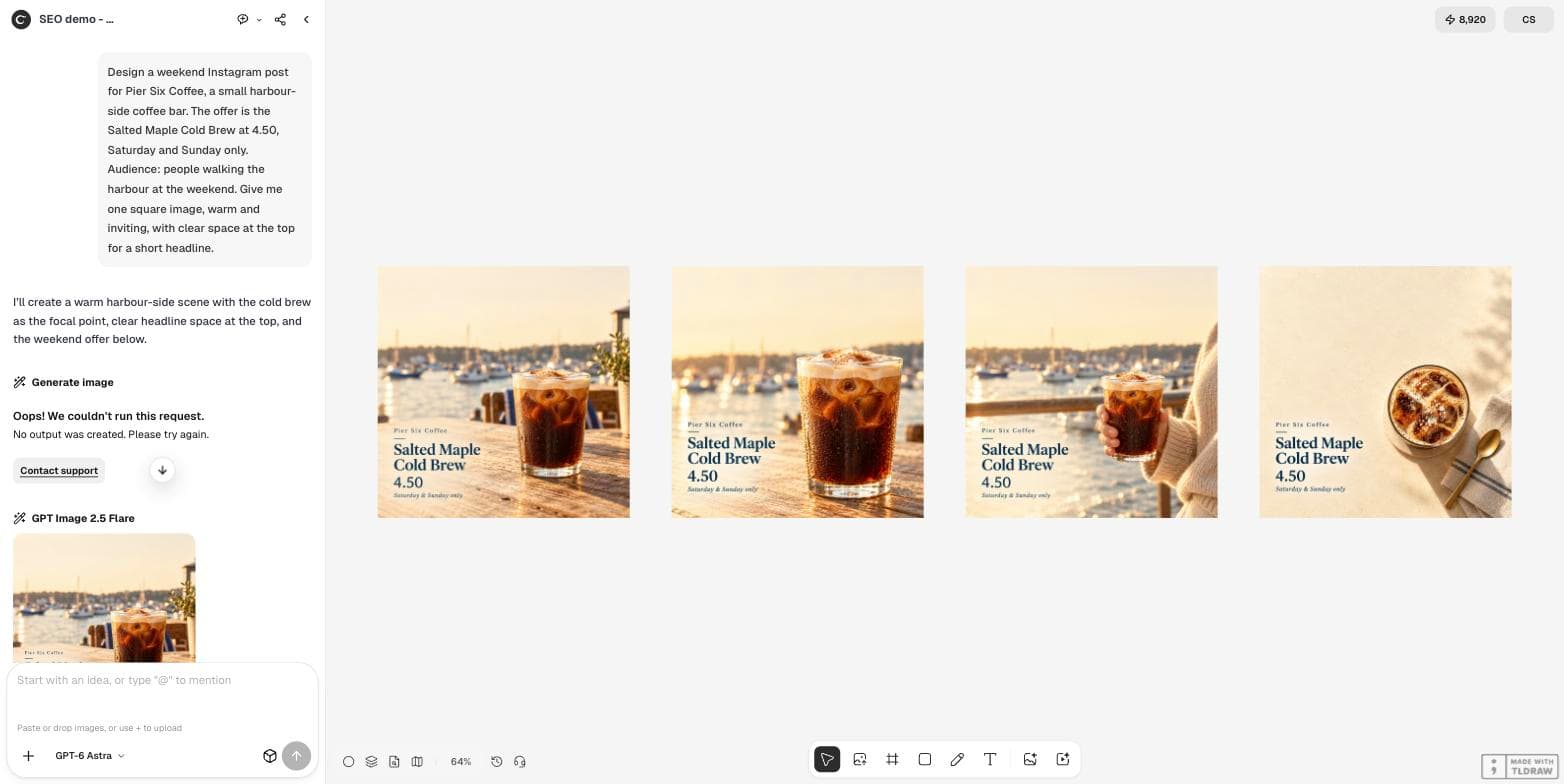
簡報是為虛構的港口酒吧 Pier Six Coffee 做的一個週末飲品促銷:Salted Maple Cold Brew,售價 4.50,僅限週六和週日,面向在港口散步的人。我們於 2026年9月21日 在 Ciyo 上跑了一遍。原始簡報產出了一張圖;另外三張是刻意生成的替代方案——玻璃杯的特寫、在港口欄桿旁端著的杯子,以及檯面上方的俯拍。
四個候選是現實的數量。多到無法全部記在腦子裡,又少到一個人真的會把每一張都看一遍。
在你看之前先把標準寫出來
讓一次評審流程值得做的紀律,是在看到候選之前就寫下你要評判什麼。否則你只是在為已經喜歡的那張找理由。
四條標準,每條都是一道有答案的問題:飲品是否最先抓住視線;價格在小圖尺寸下是否可讀;預留的標題位置是否真的清晰;整體是否讀起來像週末港口的場景。每一條,沒見過這個品牌的人都能核對。
讀取畫布上的4張貼文。按4條獨立標準,對每張從1到5打分,逐條單獨發問:(1) 飲品是否最先抓住視線,(2) 4.50的價格在小圖尺寸下是否可讀,(3) 頂部標題區是否真的清晰,(4) 是否讀起來像週末港口場景。給我一張表,每行一張貼文、每列一條標準,然後說出你會發布哪一張,以及唯一的理由。回傳了什麼
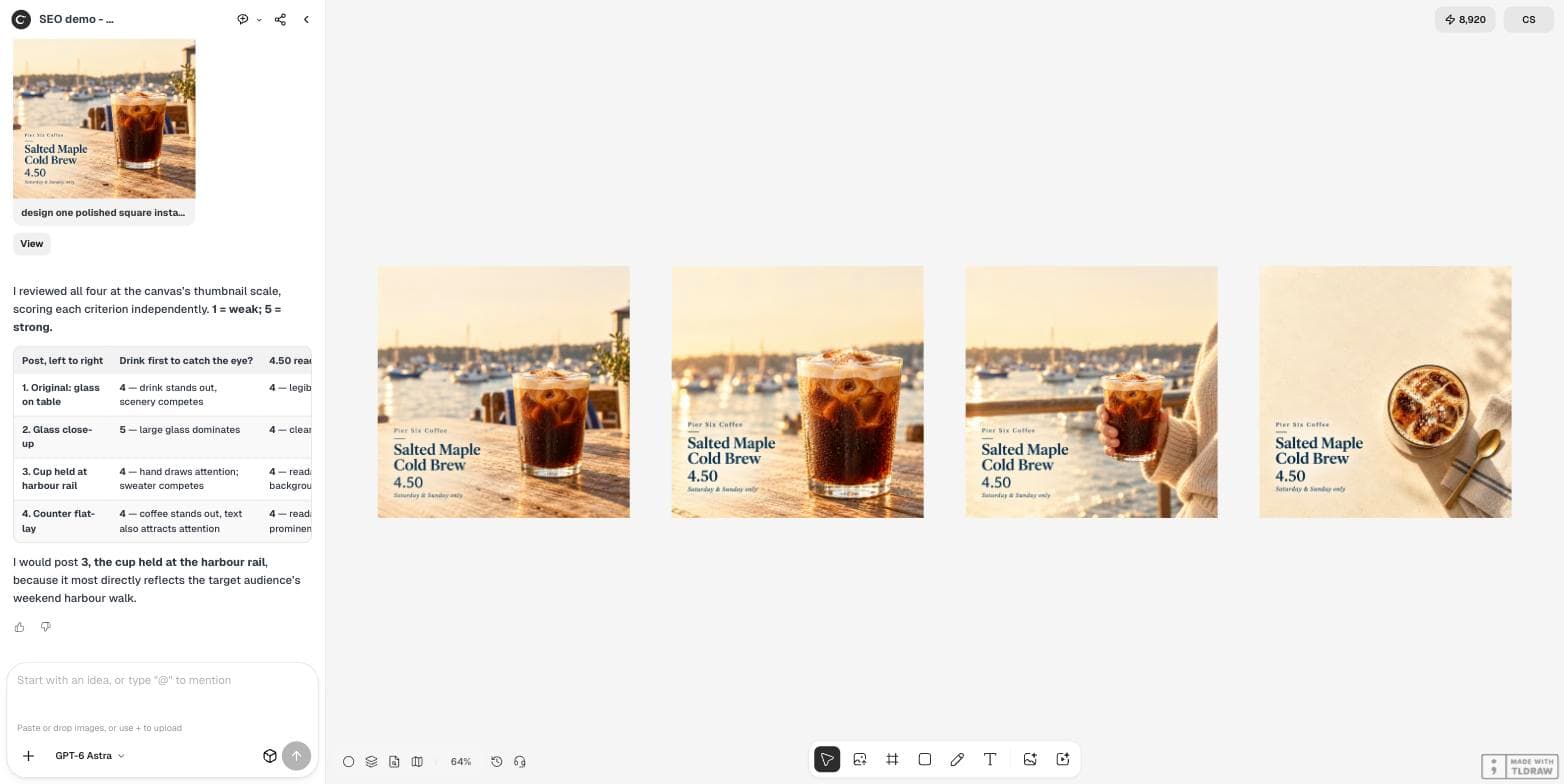
成功了。模型以小圖尺寸讀完了全部四張,產出一張四乘四的表,每個格子裡都附了簡短理由,並點名了一個勝出者:在港口欄桿旁端著的杯子,「因為它最直觀地映照了讀者週末在港口散步的情景」。這是一個站得住腳的回答,是拿我們最先寫下的標準對照得出的。
它也捕捉到了那個唯一的真實失敗。檯面上的俯拍在「讀起來像週末港口場景」上得了 1 分,並備註說沒有任何可見的港口線索,週末全靠文案傳達。這恰恰是一個人在下午四點、對著第四個變體時會漏掉的東西。
暴露弱點的那個數字
16 個儲存格。其中 15 個回來的是 4 或 5。整張表裡唯一起到區分作用的分數,就是那個 1。
所以這張表是個好的故障探測器,卻是差的排序器。它能可靠地告訴你哪個變體壞了。它不能可靠地告訴你存活下來的三個變體裡哪個最好,因為在「一到五」的量表上它不用中間段。
這不是這個模型或這條指令的缺陷。當一個判斷不得不表達成一句含有數字的話時,就會這樣。
| 問題 | 回答得好嗎 | 原因 |
|---|---|---|
| 有沒有變體是壞的? | 是 | 俯拍在港口場景上得了 1 分,且給出了具體理由 |
| 好的裡面哪個最好? | 否 | 16 個儲存格裡有 15 個是 4 或 5;量表沒能把它們區分開 |
| 明天打分還會一樣嗎? | 未知 | 我們只跑過一次;可重複性恰恰是散文式打分器最弱的地方。 |
| 人還是應該看一眼嗎? | 是 | 這裡沒有任何東西決定一個品牌的調性,而勝出者只是基於一條理由被選出的 |
System One 模型會落在何處
這就是那道縫。一個型別化的決策模型不會寫一句含有分數的話;它回傳你宣告了型別的一個值,附帶機率和一個信度數值,並且再問一次會回傳同樣的值。
放到這個具體任務上,意味著四個 Score 問題加一份明確的評分表——不是「1 到 5」,而是四個帶書面定義的具名等級——對每張貼文評估,再加上一個用於整體判定的 Choice,並帶明確的 `needs_a_human` 選項。合併規則寫在你自己程式碼裡:付費投放時可以讓可讀性重於氛圍,自然投放時反過來。
你將獲得的不是更好的品味。而是一個每次執行都意味相同的分數,一個用來決定何時該讓人來看的信度的值,以及一條不用重寫指令就能讀和修改的規則。
你會失去的是理由。告訴我們俯拍沒有港口線索的那個格子是散文,而決策模型不生產散文。實際中,有意思的設計是兩者兼備:給排序和路由用型別化的分數,給解釋它的那句話用語言模型。
Jev 在這裡做不到什麼,直說
它無法看貼文。TypeSafe 自己的文件寫明,state 必須是一個字串、一個 JSON 物件,或一組文字值的陣列,並且影像、音訊和影片目前還不支援。視覺評審流程超出了這個模型今天能接受的範圍。
它也不能製作變體。它不生成影像也不生成影片,正因如此它不在 Ciyo 的任何一個模型註冊表裡,也正因如此 Ciyo 無法提供它。
所以這篇文章觀點的誠實版本是一個文字形狀的:決策模型可以評判簡報、圖注、替代文字、行銷元資料和一張渲染圖的結構化描述——也就是創意工作裡本來就是文字的那些部分。圖片仍然需要眼睛,而今天那雙眼睛是你自己的,或是一個視覺模型的。
儘管如此,還是跑一遍評審流程。在你看之前把標準寫下來,就是價值的大部分,而且你手邊任何模型都能用。
評審流程的問題
Jev 能給我的廣告變體打分嗎?
不是圖片。它文件裡寫明的 state 只有文字——一個字串、一個 JSON 物件,或一組文字值的陣列——所以圖片在它今天接受的範圍之外。它能打分的是簡報、圖注或結構化描述。
為什麼幾乎每個分數回來都是 4 或 5?
因為把判斷表達成寫出來的數字,散文模型會把量表往頂端壓縮。每個格子裡寫下的理由,承載的資訊比那些數字更多。
儘管如此,評審流程還值得跑嗎?
值得。它在做出來的那個下午就捕捉到了一處真實的失敗;而無論用哪個模型打分,看之前把標準寫下來都是好處的大部分。
Ciyo 執行 Jev 嗎?
不。它不生成影像也不生成影片,也不在 Ciyo 的任何模型註冊表裡。本文的打分是由 GPT-6 Astra 完成的,而 Ciyo 確實執行它。
跑你自己的評審流程
生成四個變體,在看之前寫下四條標準,並讓智慧體對每一個變體都打分。