代理 · 評估
代理迴圈中的 Jev:決策層
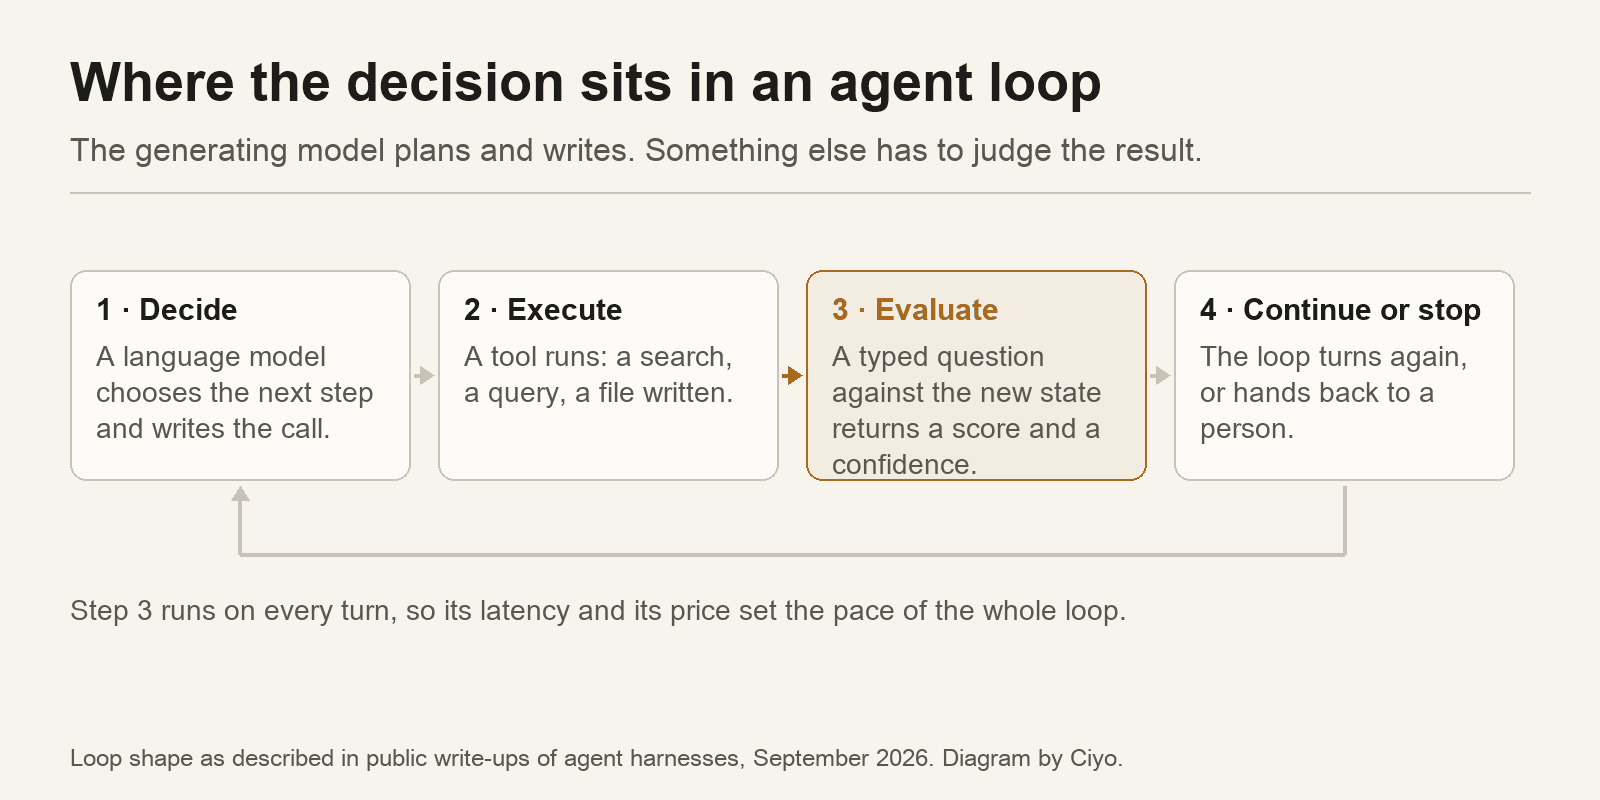
代理程式是以迴圈在跑。模型決定要做什麼,工具去執行,某個東西評估結果,然後迴圈再轉一次。前兩步最受注目,第三步才是工程通常會痛的地方。
TypeSafe AI 在 2026 年 9 月 15 日發表的 Jev,就是為了那第三步而打造的,而且只為了那一步。這篇文章看它落在什麼位置、取代了什麼,以及供應商之外第一份公開測試實際量到了什麼。
今天團隊判斷一個步驟的兩種做法
程式化評估出現得最早,到現在仍然是最便宜的選項。一個函式檢查代理程式有沒有呼叫工具、JSON 有沒有解析成功、數字有沒有落在範圍內。它快速、有決定性,而且很窄:它需要固定的輸入,但代理行為並不固定。要判斷代理程式有沒有好好運用工具結果回答使用者的問題,這不是用條件式列舉得出來的。
於是團隊改用 LLM 評審,讓它接受非結構化的追蹤紀錄,再用一則提示詞評分。這買到了通用性,代價付了三次:延遲,因為判斷是一次一個 token 寫出來的;金錢,每一次呼叫都要付;以及變異,因為同一份追蹤紀錄跑兩次可能得到不同分數。
第三個選項,是一個把評估當成它本來面目的模型——一項決策任務。給它一個狀態和一個有型別的問題,回傳有型別的答案和它的機率。
System One 模型該放在哪裡
位置是第三步。它不規劃,不呼叫工具,也不寫出下一道指令。它看迴圈剛產生的狀態,回答那些答案已由你事先宣告的問題。
這個位置也解釋了為什麼它的延遲和價格比看起來更重要。第三步每一輪都會跑,而在線上情境中,它可以跑在很大一部分的正式追蹤紀錄上,而不只是抽樣——那正是成本通常逼著團隊去做的取捨。
問好幾個小問題,不要問一個大問題
慣用的形狀不是一則要求下結論的提示詞,而是一小把原子化的問題,每一個都宣告好答案,針對同一個狀態評估,再用你自己的程式碼組合起來。
TypeSafe 的文件說每一個問題都針對同一個狀態,平行而且彼此獨立地一次評估完成,而且增加問題幾乎不會改變回應時間。所以自然的設計是一把窄問題:工具有沒有被呼叫、答案有沒有取回的證據支撐、以一到五分的評分準則來看有多好用、這次執行符合三種搜尋結果中的哪一種。
每一個問題都會帶著機率回來,而組合的邏輯就住在你讀得到、測得到、不必動提示詞就能改的地方。
一份公開測試發現了什麼
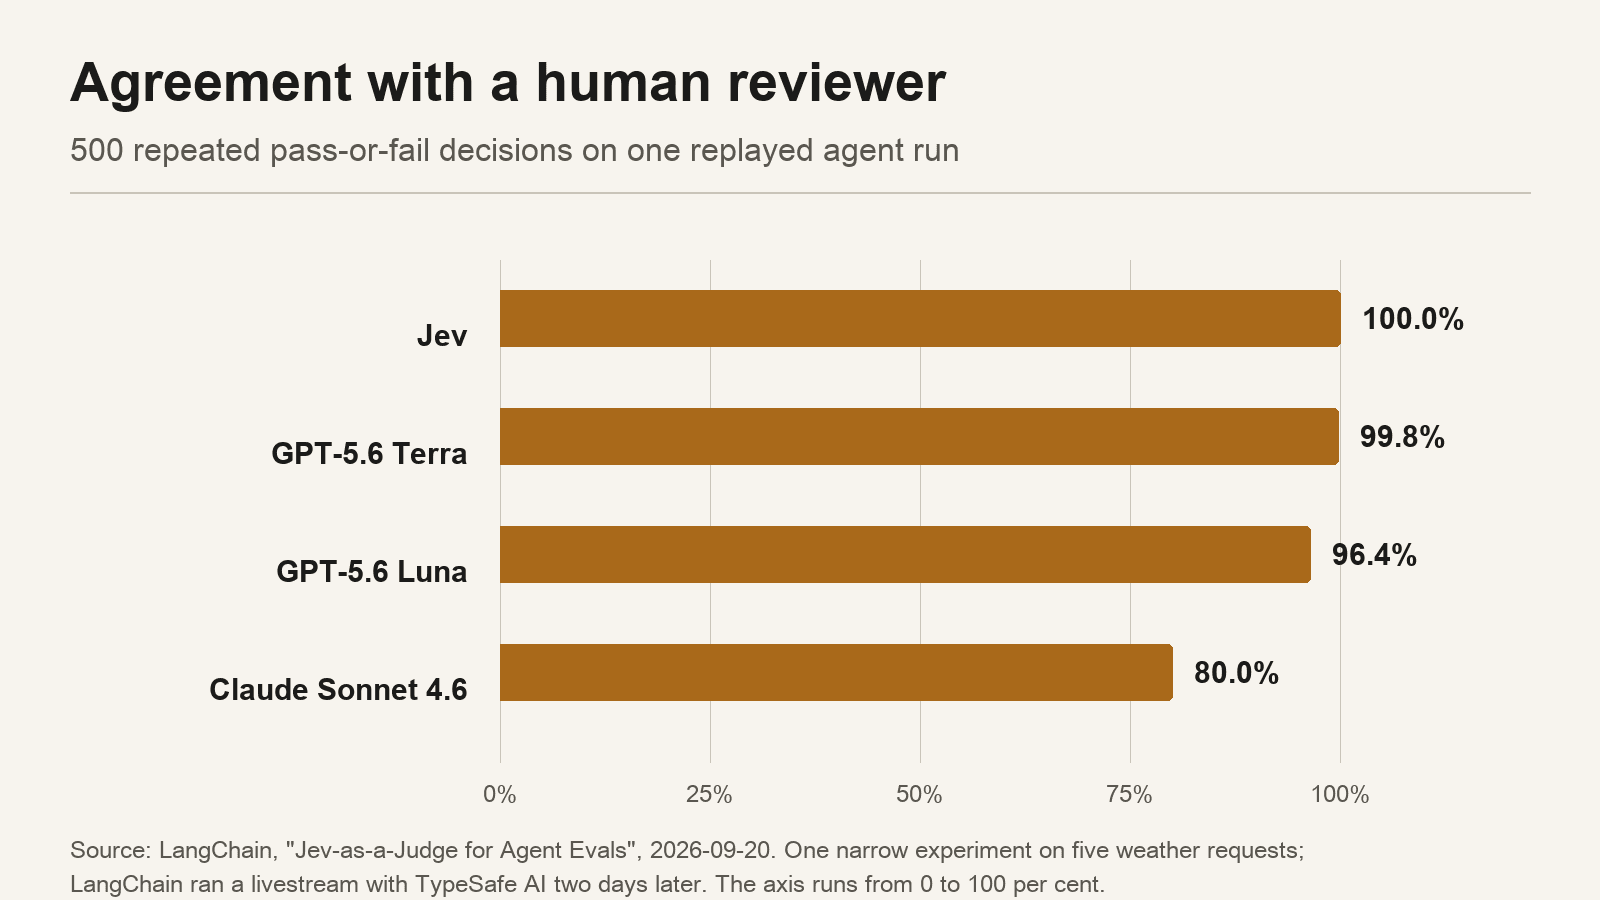
2026 年 9 月 20 日,LangChain 發表了一項實驗,用 Jev 當評審,並在同一份重播的代理執行紀錄上和三個語言模型比較。在通過與否的二元判斷上,Jev 在全部 500 次重複判斷中都與人類審查者一致;GPT-5.6 Terra 一致率為 99.8%,GPT-5.6 Luna 為 96.4%,Claude Sonnet 4.6 為 80.0%。
可重複性是更銳利的結果。在連續的品質分數上,Jev 每案的平均變異是 0.0000149,LangChain 指出這比那三個語言模型低 92 到 913 倍。準確度告訴你評審是否與人類一致;變異告訴你它明天會不會說一樣的話。一套測試裝置兩者都需要。
LangChain 對這項測試無法證明什麼很小心。他們稱它是建立在五個天氣請求上的窄幅實驗,把變異的發現描述為觀察性而非因果性的,並且公開了程式碼倉庫和釘住的函式庫版本,好讓別人可以重跑。他們也在兩天後和 TypeSafe 一起辦了直播,衡量這份報告時值得把這件事放進去。
發表於 2026-09-18。一位開發者對同一套迴圈模式的紀錄:LLM 決定,工具執行,模型評估。
值得預先設防的失效模式
便宜的判斷會改變行為。當一次判定只花不到一美分,你就會停止抽樣、開始全部評估,而這正是重點。但這也表示,一個往固定方向犯錯的評審,現在會無聲無息地在所有地方、以規模犯同一個錯。
LangChain 把這一點直說了:低成本會放大錯誤,而一個持續判斷錯誤的評估器,只會更快產生糟糕的回饋。低變異在變好之前會先讓情況變糟,因為一個可重複的評審,在有人去查之前就是一個可重複的錯誤。
緩解方法很無聊。維持一組人工標註的標準答案集,每次改動問題就重新量一次一致率,而且要去讀那些被評審否決的追蹤紀錄樣本,不要只讀通過的。
| 做法 | 強項 | 弱項 |
|---|---|---|
| 程式化 | 有決定性、幾乎免費、可稽核 | 需要固定的輸入;無法判斷開放式行為 |
| 以 LLM 當評審 | 接受非結構化的追蹤紀錄;通用 | 較慢、較貴,而且跨次執行沒有決定性 |
| System One 模型 | 帶機率的有型別答案;可重複;便宜到可以跑在所有資料上 | 沒有開放式推理;評分準則錯了就會一路錯得很一致 |
接上去之前該先寫下來的東西
三件事,而且沒有一件是提示詞。狀態:每一次呼叫時模型究竟看到什麼,以及以什麼形狀呈現。問題:每一個都要原子化,把選項或評分準則寫明白,因為那些就是型別。門檻:信心值 0.9 時你的程式做什麼,0.55 時又做什麼。
最後那一項,正是這類模型把工作搬動、而不是消除的地方。語言模型把門檻藏在散文裡;有型別的決策把數字交到你手上,逼你自己決定。已經在維護標註評估集的團隊會覺得這很簡單。還沒有的團隊會發現,自己本來就需要一套。
關於代理評估的問題
決策模型可以完全取代 LLM 評審嗎?
只有在答案能事先宣告的問題上可以。任何需要解釋、改寫或開放式評論的工作,仍然需要一個會生成文字的模型。
問更多問題會花更多時間嗎?
TypeSafe 的文件說問題是針對同一個狀態,平行而且彼此獨立地評估,而且增加問題幾乎不會改變回應時間。
100% 的一致率算是基準測試結果嗎?
不算。那是在五個重播的天氣請求上做的一次窄幅實驗,發表者在兩天後還和供應商一起辦了直播。把它當成第一個資料點。
繼續閱讀
Ciyo 書寫創意與代理工具背後的模型,並實測那些自己跑得動的。