视频声音 · 实测
用 AI 给视频加音效,精确到每一帧
一条无声的产品短片总显得没做完,光加音乐也补不上。让美食和产品视频看着过瘾的,是那些细小的声音:面包皮裂开,杯子碰到桌面。这些声音只有正好落在动作上才有效果。爆裂声早了半秒,听起来就是假的。
2026年9月30日,我们在 Ciyo 里为虚构面包店 Crumb & Kettle 做了一条 8 秒的 Reels,并请 Ciyo Agent(Ciyo 智能体)加上四个音效和一层安静的环境音。它自己在视频里找到了这些时刻,并为每个音效报告了时间点。我们测量了成片的音频:杯子声正好落在那一帧上,爆裂声最响的部分也落在面包裂开的过程之内。
从一条无声片段开始
如果你已经有片段,上传就行。我们的片段是在 Ciyo 里做的:一条 8 秒的竖版特写,一双手在盘子上方撕开一个可颂,碎屑落下,然后一杯咖啡被放在旁边。用最便宜的视频设置花了 9 个额度,我们要求不带音频。
无声很重要。视频模型自己加上的声音会和你之后放的音效打架,而且没法干净地去掉。
我经营一家小面包店 Crumb & Kettle。为一条 Instagram Reels,请给我做一条无声的 8 秒竖版片段(最便宜的视频设置,不要音频):特写一双手在白色盘子上方把一个新鲜可颂撕开,碎屑落下,然后一杯咖啡被放在旁边。镜头保持不动。先不要加任何声音;下一步我想加音效。说出时刻,而不只是声音
只列一串声音是不够的。要说明每个声音属于什么动作,这样智能体才能在画面里找到它:面包皮裂开,两半被拉开,碎屑落下,杯子碰到桌面。再加一层环境音让画面有空气感,并说明它该有多安静。要求它给出时间点,这样你就能检查。
片段不错。现在加上音效,让它们落在动作上:面包皮裂开时清脆的爆裂声,两半被拉开时轻柔的拉扯声,碎屑落到盘子上的声音,杯子碰到桌面的声音,底下再垫一层安静的咖啡馆环境音。请你自己在视频里找出确切的时刻,告诉我每个音效的时间点,并把环境音压低,让动作的声音突出。不要音乐,不要人声。2026-09-27 发布。这位创作者把一条静音视频上传到 Codex,请智能体在不用 DAW 或采样库的情况下设计音效,并分享了提示词。其中有两条规则适用于任何工具:先把画面里的事件列出来;不要相信智能体能听出结果,而是让它给出一份音效提示表,由你自己来判断。那是另一个产品和作者自己的工作流程,不是 Ciyo。
智能体怎么找到这些时刻
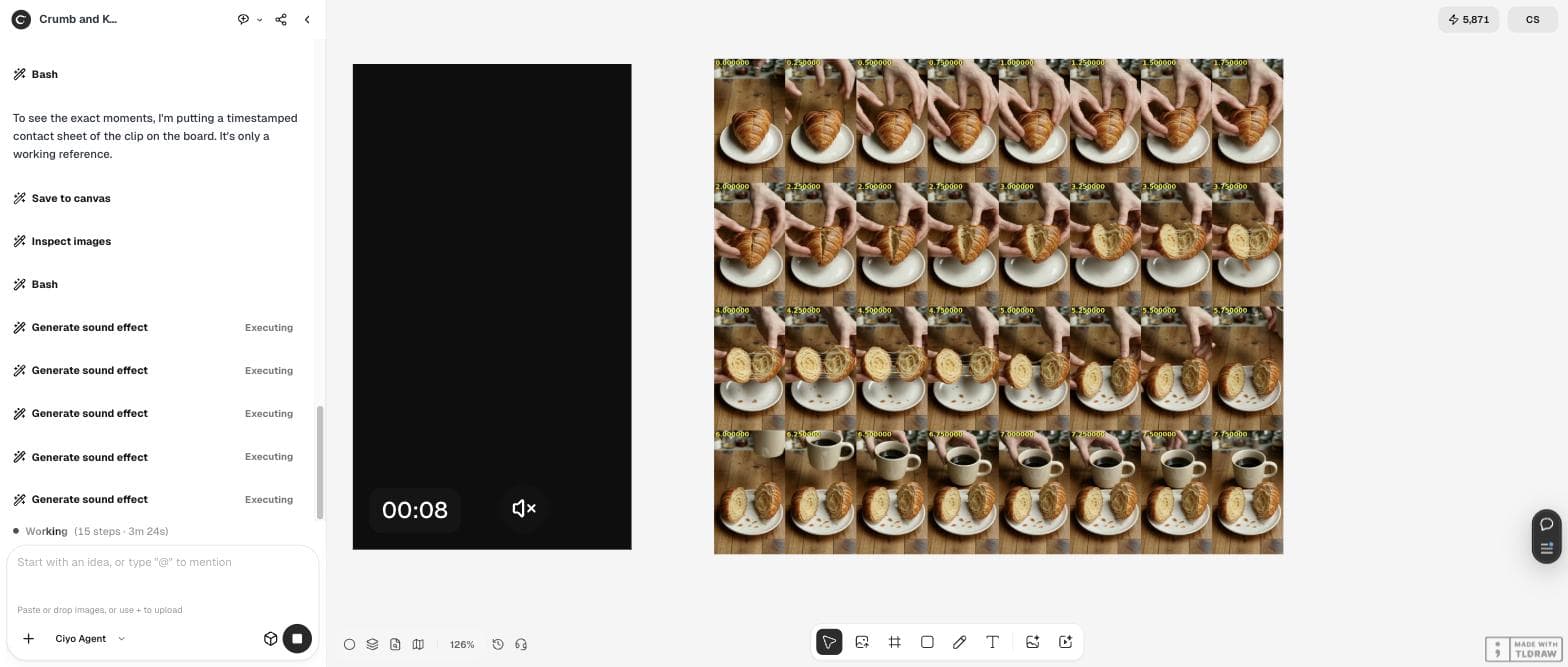
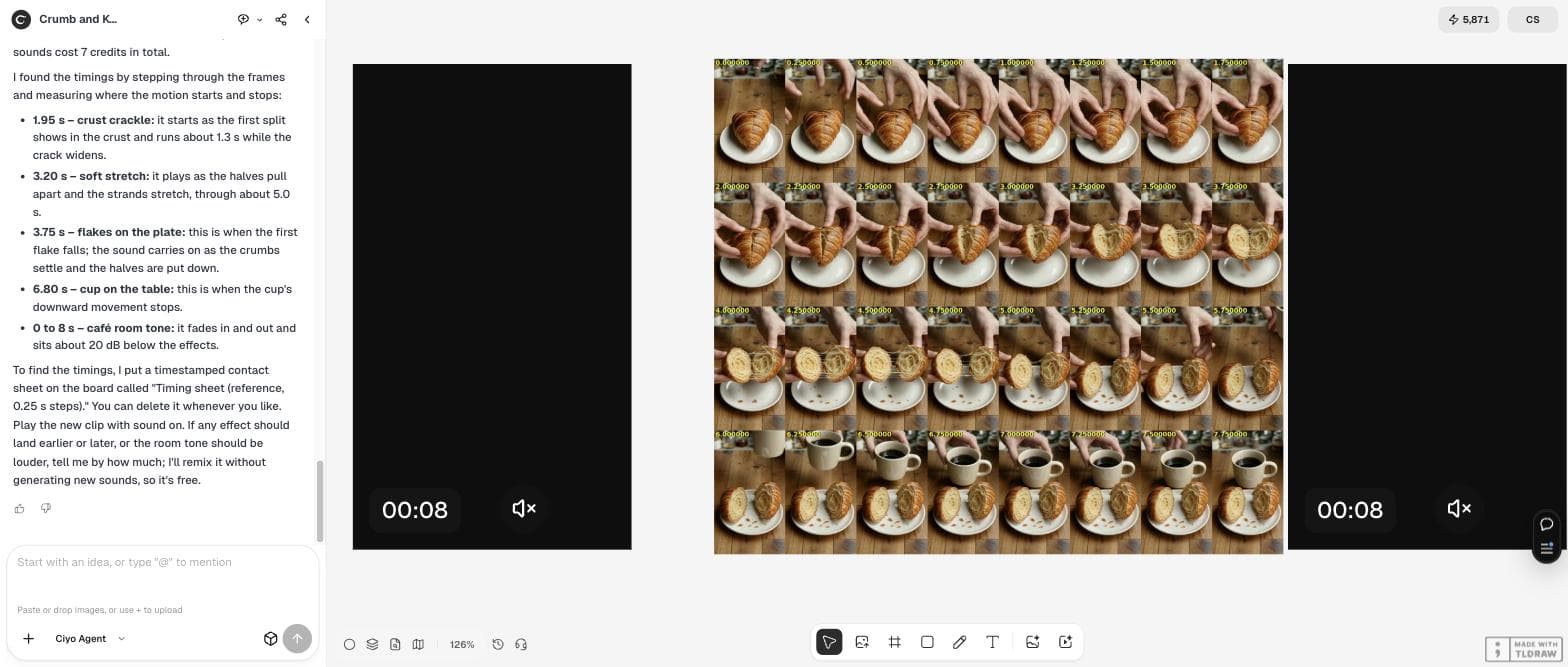
智能体逐帧浏览视频,在画板上放了一张时间对照表:32 帧,每 0.25 秒一帧,每帧都标着时间。它是一份可以删掉的工作参考,也是你检查结果最快的方式。
然后它生成了五个声音,混进片段的一个副本里,原片保留不动。五个声音花了 7 个额度;混音不花钱。
它选择的时间点
智能体报告了每个音效以及选这个时间的理由,比如杯子在 6.80 秒落下,“when the cup's downward movement stops”(也就是杯子向下的动作停止的时候)。环境音贯穿整条片段,比音效低约 20 dB。
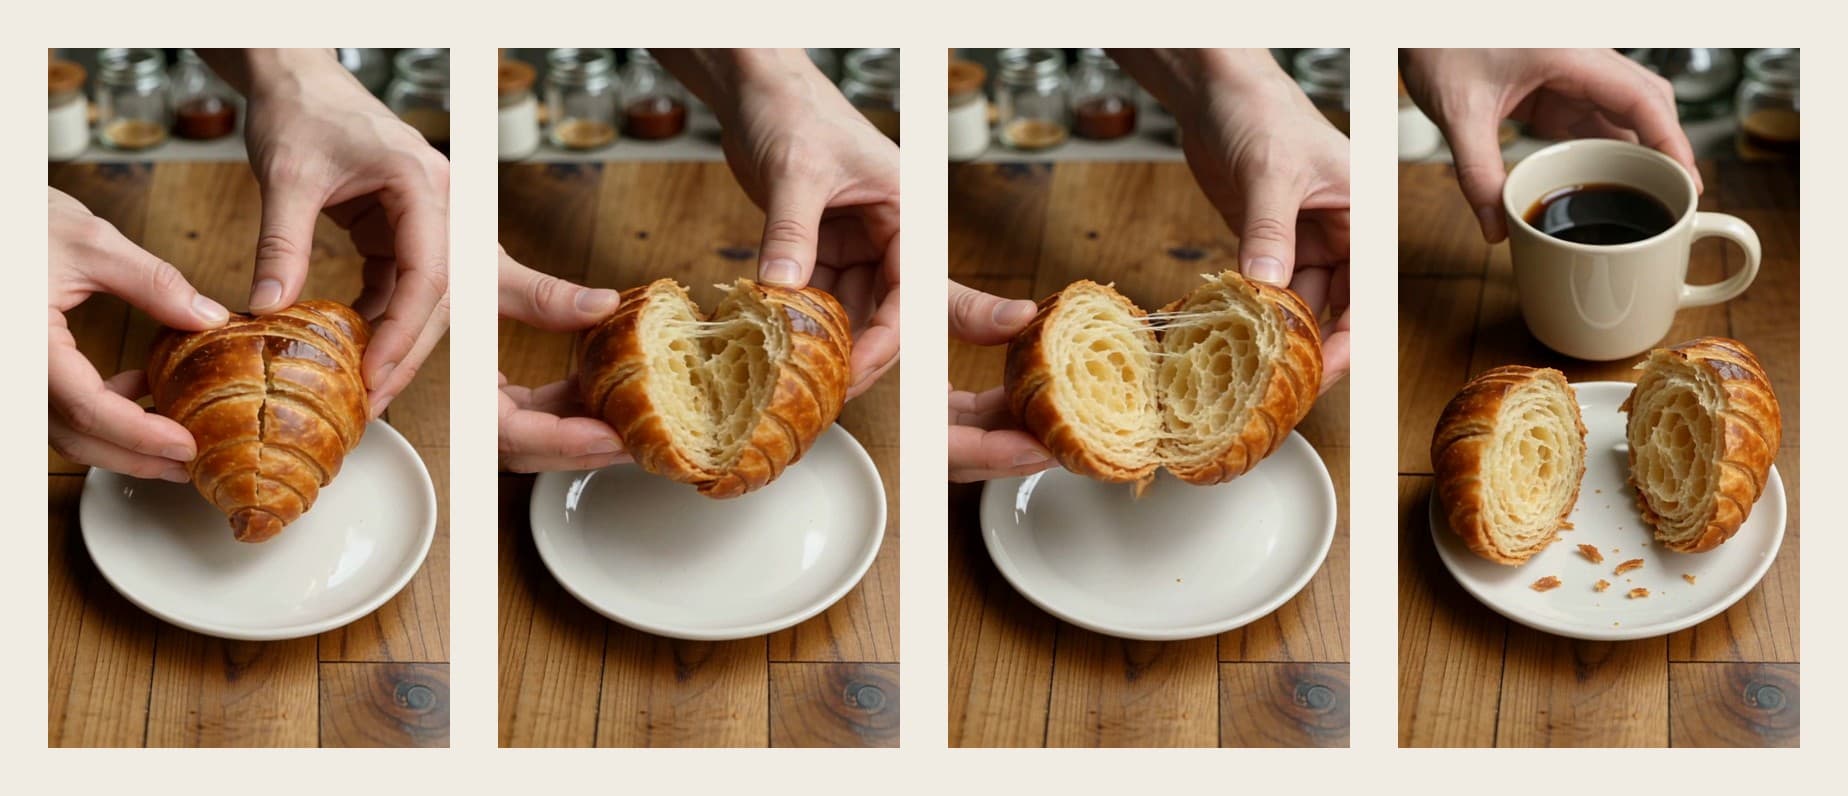
下面这几帧取自成片中的这四个时间点。
| 音效 | 开始时间 | 对应画面里的什么 |
|---|---|---|
| 面包皮爆裂声 | 1.95 s | 面包皮第一次裂开;随着裂口变大持续约 1.3 s |
| 轻柔拉扯声 | 3.20 s | 两半被拉开,一直到约 5.0 s |
| 碎屑落盘声 | 3.75 s | 第一片碎屑落下 |
| 杯子放到桌上 | 6.80 s | 杯子停止向下移动 |
| 咖啡馆环境音 | 0 到 8 s | 淡入淡出,比音效低约 20 dB |
我们测量了音频
我们下载了成片 MP4,每 50 毫秒测一次响度。环境音大约在 −46 到 −48 dB。杯子声是最响的时刻,−18 dB,正好从 6.80 秒开始。碎屑声在 3.70 秒升起。爆裂声放在 1.95 秒,但它最响的部分出现在 2.5 到 3.0 秒、裂口最大的时候,这仍然在智能体选定的时间段之内。
所以环境音比最响的音效低约 28 dB,比智能体说的“about 20 dB”(约 20 dB)还要安静一些,整条 Reels 的响度测得为 −19.7 LUFS。如果它和你的其他 Reels 放在一起显得偏小声,就要求混得响一点;智能体主动提出可以不生成新声音、免费重新混音。
用耳朵检查,再做调整
AI 智能体能测量波形,但没法告诉你爆裂声听起来像不像可颂。戴上耳机听一遍,再用手机扬声器听一遍。对每个音效问两个问题:它是不是从动作开始的那一帧开始?它听起来像不像那个东西?如果某个声音早了或晚了,就把时间对照表上的帧时间和调整方向告诉智能体,比如“把爆裂声往后移 0.3 s”。
| 检查项 | 我们的 Reels |
|---|---|
| 每个音效都从对应动作开始 | 杯子声准确落在 6.80 s;爆裂声峰值在裂开过程之内 |
| 环境音低于音效 | 比最响的声音低约 28 dB |
| 没要求就不加音乐或人声 | 没有 |
| 整体响度 | −19.7 LUFS;需要的话可以要求调响 |
| 保留原片 | 是,无声片段留在画板上 |
这条 Reels 的下一步
音效、音乐和人声各有各的空间时,才能配合得好。在音效下面垫一层音乐,或者在音效之后加一段简短的旁白,并保留无声原片,留给下一次剪辑。
用 AI 添加音效
AI 能让音效卡准我的视频吗?
能,只要它看得到画面。在我们的测试中,Ciyo Agent 为片段做了一张时间对照表,并按动作放置每个音效;按我们的测量,杯子声正好从 6.80 秒开始。
应该让视频模型来生成声音吗?
如果你想要掌控,就不要。先生成无声片段,再加上可以逐个移动和调整的音效。
环境音应该多响?
低到能让动作的声音突出就行。我们的环境音比最响的音效低约 28 dB。如果片段在声音之间显得空,就把它调高一点。
花了多少钱?
2026年9月30日共花 16 个额度:无声片段 9 个,五个音效 7 个。混音以及任何不生成新声音的重新混音都是免费的。
在 Ciyo 里给你的片段加声音
上传一条无声片段,说出哪些时刻需要声音,并请 Ciyo Agent 给出时间点,方便你检查。