模型 · 面向设计师
大规模替代文本,以及它无法做的检查
替代文本是个人人都同意、却几乎没人审计的无障碍工作。它由上传的人最后才写,写完之后再也没人看它一眼。
而且它很不寻常,是一项靠近创意、纯文本模型几乎可以整体接手的工作 —— 因为替代文本就是文本。一个 2026年9月15日 发布的模型,用大约三分之一秒、花不到一美分,就能回答关于文本的若干已声明问题。Ciyo 无法运行 Jev:它不生成图像也不生成视频,也不在我们的任何一个模型注册表里。但这类检查器能告诉你什么、不能告诉你什么,这个分界是本文最有用的部分,无论你最后用哪款工具。
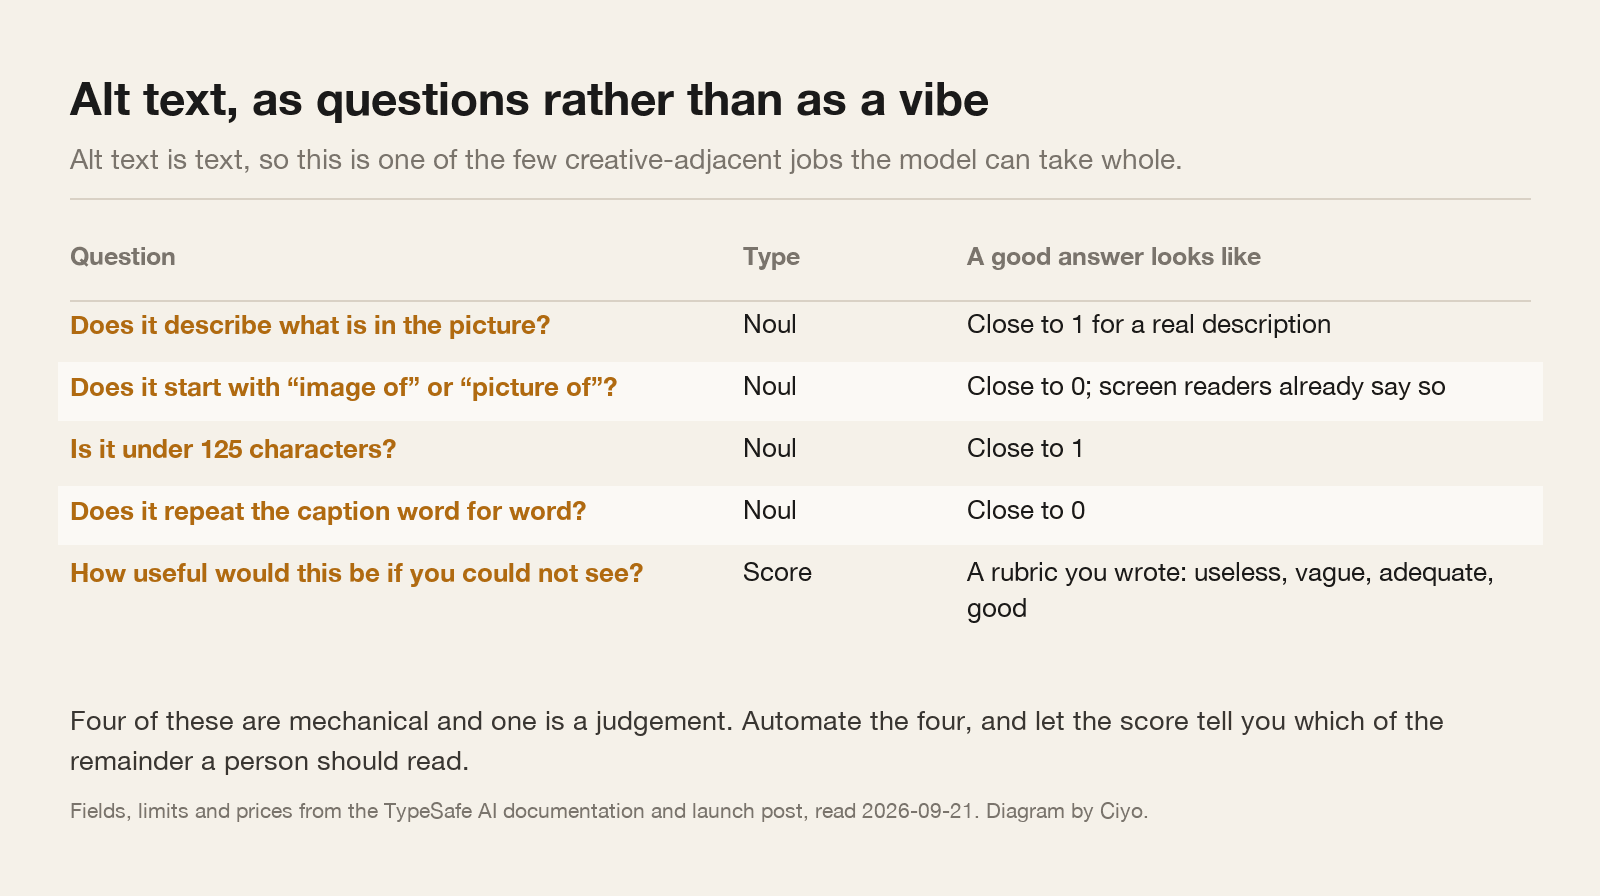
让替代文本变好的要素,写成问题
多数替代文本指南是一列原则。把原则变成带有已声明答案的问题,你就得到了可以在每一张曾经发布的图上运行的东西。
其中四件是机械性的:长度、措辞、结构,以及它是否只是重复图注。有一件是判断,而那一件该打分数,而不是回答是或否。
它无法做的检查,以及为什么它比其余都重要
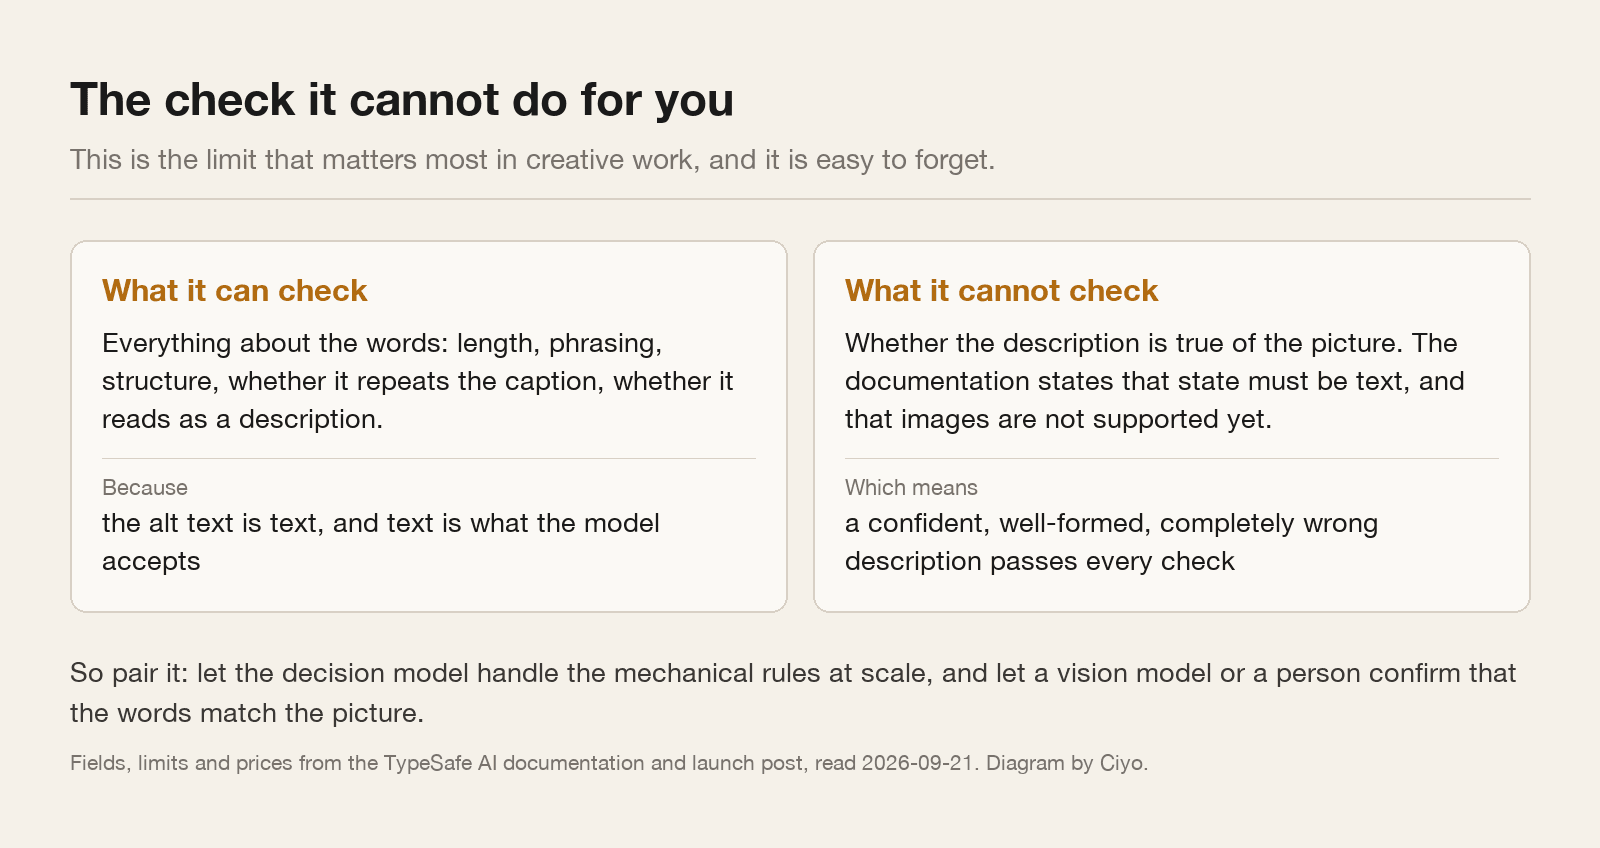
纯文本模型读你的替代文本。它从来看不到你的图片。TypeSafe 的文档说,输入必须是字符串、JSON 对象或文本值组成的数组,而且图像目前还不支持。
所以它能确认你的替代文本是一段格式良好、长度恰当、不重复的描述。它无法确认这段描述是否属实。
“一只蓝色沙发上熟睡的金色寻回犬”完美通过每一项机械检查。如果照片是厨房地板上的一只猫,模型无从知晓,而屏幕阅读器用户会被以十足的信心告知一件假事。这种失败比缺失替代文本更糟,因为缺失的替代文本至少对那道缺口是诚实的。
这是最值得记住的单一限制,它适用于每一个纯文本检查器,不止这一种。
所以把它配对用,别只信它一个
真正管用的设计,是用两种不同的工具对付问题的两个不同半边。
让决策模型在大规模上处理机械规则:每周在站点每一张图上跑一遍,花几美分。这一遍能找出空字符串、被当成描述粘进去的文件名、替代文本只是重复图注的那四十张图,以及以“图片中的”开头的那些。
然后让有眼睛的东西 —— 一个视觉模型,或一个人 —— 在样本上、以及在分数标记为含糊的任何东西上,确认文字与图片相符。那比全部小得多的一堆,正是重点。
| 问题 | 谁回答 | 频率 |
|---|---|---|
| 到底有没有替代文本? | 任何文本检查器 | 每张图,每周 |
| 长度和形状对不对? | 决策模型 | 每张图,每周 |
| 只是重复图注吗? | 决策模型 | 每张图,每周 |
| 对看不见的人有用吗? | 决策模型,作为分数 | 每张图;读那些低分 |
| 对这张图是真的吗? | 视觉模型,或人 | 一个样本,加上所有被标记的 |
写好评分量表,让分数有意义
有用性这个问题是分数,不是是/否,而分数需要带定义的分级。两到十级的评分量表正是这类模型所期望的,级别由你来写。
这里用四级很合适:useless、vague、adequate、good。useless 是文件名或空字符串。vague 是“产品照片”。adequate 点出主体和场景。good 给读者本该从看图得到的东西,包括周围文字要紧的那个细节。
在跑任何东西之前先把定义写好,并用手工对照它们给三十个真实例子打标签。那组打了标签的集合会告诉你分数是否在跟你的判断走,即使你从不安自动化也值得拥有。
state: { "alt": "...", "caption": "...", "page_title": "..." }

questions: {
  "describes":       { "type": "noul", "instructions": "替代文本描述的是可见的内容,而不是在命名一个文件或类别。" },
  "redundant_open":  { "type": "noul", "instructions": "替代文本以“图片中的”、“照片中的”或“图中的”开头。" },
  "length_ok":       { "type": "noul", "instructions": "替代文本少于 125 个字符。" },
  "repeats_caption": { "type": "noul", "instructions": "替代文本几乎一字不差地重复图注。" },
  "usefulness":      { "type": "score", "instructions": "这对看不见这张图的人会有多大用处?",
                       "criteria": ["useless", "vague", "adequate", "good"] }
}
第一次扫描通常会发现什么
预期结果比你以为的更糟,比你害怕的好修。
常见的发现到处都一样:忙碌某个月里一批完全没有替代文本的图、某人粘进文件名的那一段、以及替代文本又是图注的长尾。这些没有一个需要判断才能修。它们需要一张清单。
含糊的那些,才是分数派上用场的地方。“我们的新系列”在技术上算描述,却没告诉屏幕阅读器用户任何东西,而机械规则永远不会抓到它,因为它长度正确、也不重复任何东西。
并且在你写的任何选项上都声明一个退出项。一项 2026年9月20日 发布的、预先注册过的独立评测发现,在没有“这些都不是”可用时,三十个超出范围的输入没有一个被标记 —— 最近的已声明答案回来时看起来已经定了。
诚实的总结
你可以用每遍几美分,把替代文本质量控制的五分之四自动化,而且你应该这么做,因为替代方案是根本没人检查其中任何一项。
你无法自动化那五分之一 —— 它问文字对图片是否属实 —— 而那一项在出错时最伤读者。让人或视觉模型永久地、在样本上,守住那一项。
任何向你推销“纯文本工具、号称能对照图片核验替代文本”的人,描述的都是其文档说模型做不到的事。
替代文本问题
纯文本模型能检查我的替代文本吗?
它能检查关于文字的一切:长度、措辞、结构,以及是否重复图注。它无法检查描述对图片是否属实,因为它从来看不到图片。
替代文本应该多长?
少于大约 125 个字符是个合理的规则,而且是可以对每张图运行的机械检查。更长的描述通常更适合放在周围文字里。
替代文本应该以“图片中的”开头吗?
不该。屏幕阅读器已经宣告这是一张图片,所以那些字只是白白占用你的字符数。这是最容易自动化的检查之一。
Ciyo 运行这个检查吗?
不能。Ciyo 不运行 Jev。Ciyo 的智能体可以为你生成的图片起草替代文本,那是另一项工作:写它,而不是大规模审计它。
继续阅读
Ciyo 写的是创意和智能体工具背后的模型,并测试它能运行的那些。