模型 · 面向设计师
两万个从没人好好命名的文件
每个工作室都有那么一个文件夹。十年的活儿,文件名像 final_v3_REAL_use_this 这样,三套不同的命名规则来自三个不同的客户经理,还有一个人——只有他知道 2023 年的包装图在哪。
没人去整理,因为整理意味着两万个微小的判断,而两万个微小判断就是两周的活儿。改变这一算术的是 2026 年 9 月 15 日——那天 TypeSafe AI 发布了一个模型,能在约三分之一秒内回答一个预先声明的问题,花费不到一美分。Ciyo 无法运行 Jev——它不生成图像、也不生成视频,而且不在我们的任何一个模型注册表里——但不管最后由哪个工具来做,这件事的形态都值得弄明白。
它到底能读什么
先从边界说起,因为它决定了整个设计。这类模型读的是文本:TypeSafe 的文档写明,你发送的内容必须是一个字符串、一个 JSON 对象,或一组文本值,并且图像目前还不受支持。
所以它从不会打开你的 JPEG。它读的是文件周围的文本记录:文件名、文件夹路径、说明文字、任何替代文本、客户名称、日期、资源管理器里的备注,以及它来源的那份简报。
这听起来像是个致命的限制,直到你去看一个真实的素材库。你最需要知道的大部分信息,其实早已被写在某处,只是写得很糟。问题从来不是信息缺失,而是读两万条这样的碎片会花掉某个人整整两周的人生。
该问的问题集
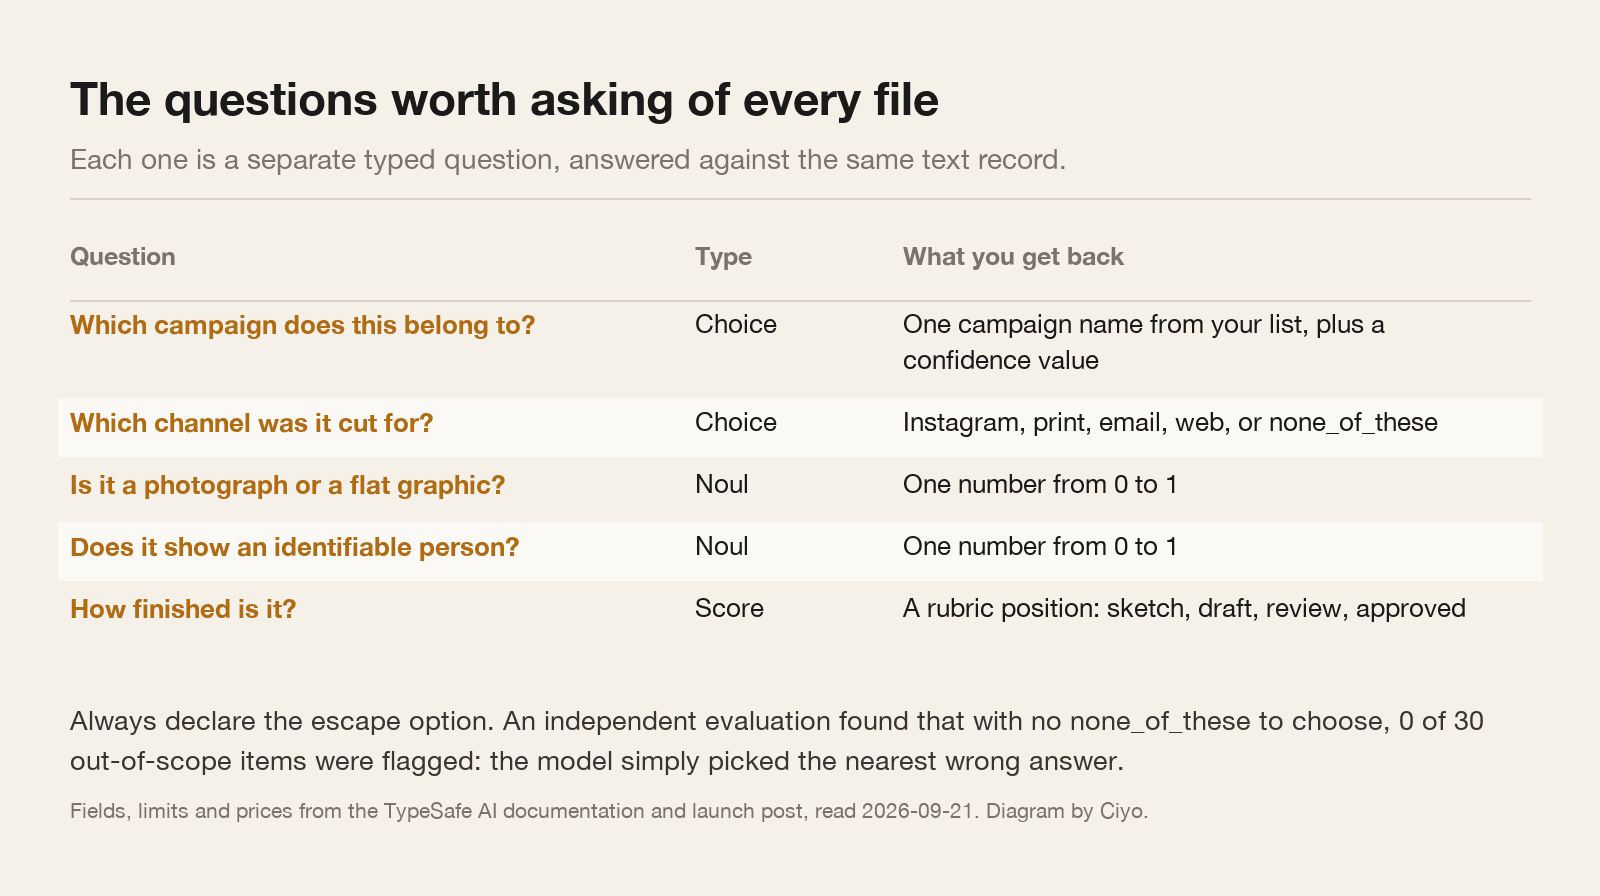
不要只问一个大问题。针对同一条记录问几个小问题,每个的答案都预先声明好。它们会被一起评估,所以一旦文本上了线路,问五个几乎不花额外成本。
陷阱,以及避开它的那一行
有一个发现应该改变你写问题的方式。一项预先注册的独立评测于 2026 年 9 月 20 日发布,它测试了当某个文件不属于你声明的任何一个类别时会发生什么。
在这三十个这样的案例里,由于没有可用的逃生选项,它一个也没有标记出来。它每次都返回最接近的已声明答案,并附上一个置信度的值。没有失败。看起来也没错。
这不是缺陷,而是类型系统履行了它的承诺:你说过答案会是这五个之一,所以它就是。但在素材库里,这意味着你 2019 年的招聘照片会被悄悄归到当时还不存在的某个营销活动下,直到有人去翻找才会发现。
解决办法就是多加一个选项。声明 `none_of_these`,或者 `needs_a_human`,并为它写下和真实类别一样仔细的判定标准。然后在你自己的代码里做路由。
整理整个素材库要花多少
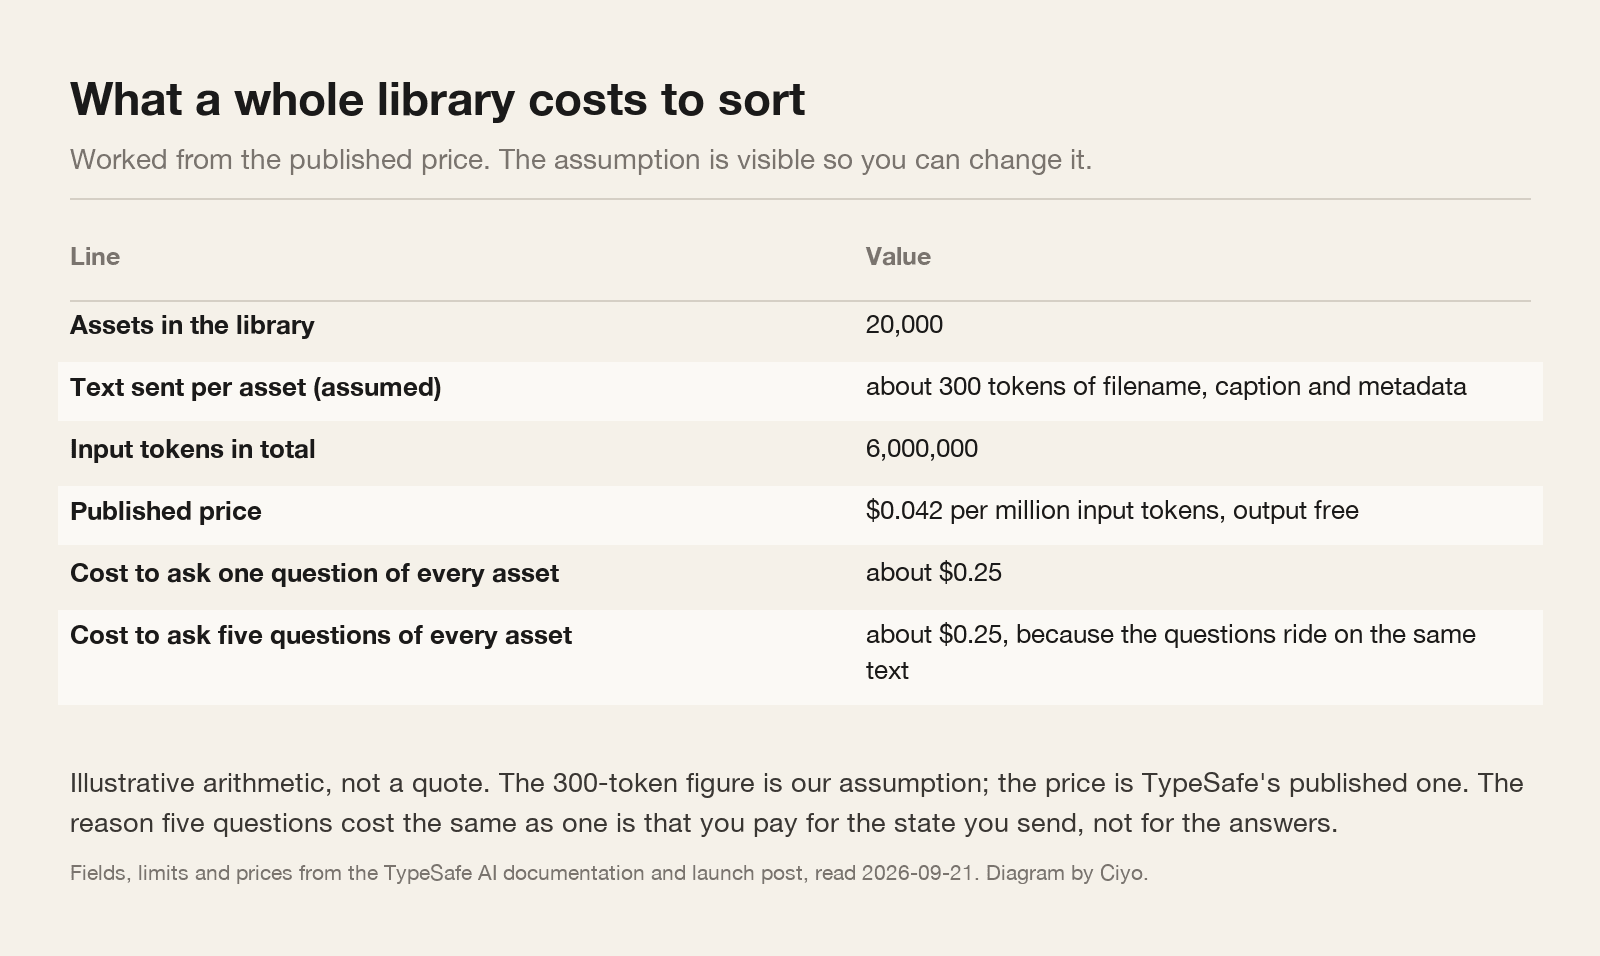
公布的价格是每百万输入 token 0.042 美元,输出免费。下面的计算假设每个素材的文件名、说明和元数据约 300 个 token——这是我们的假设,不是实测值——如果你的记录更长,可以改掉它。
两万个素材,每个 300 个 token,合计六百万 token——也就是给库里每个文件问一个问题,大约二十五美分。
让人意外的地方在于:问五个问题花的还是那二十五美分,因为你付的是发送文本的钱,而不是收回答案的钱。
发布于 2026-09-21,是在观察该模型实际使用后记下的一个帖子串的一部分。那张清单——“给这个分类。给这个分流。给这个打分。选这个工具。核验这个输出。”——是我们所见过的对这项工作最清楚的简短表述,而整理素材库正是其中的第一项。发帖人写的是软件决策,而非创意工作。
到底怎么跑起来,又不搞砸任何东西
第一轮千万不要让任何东西写回你的素材库。输出一张表格:每个文件一行,每个问题一列,再加上各自的置信度。
按置信度给这张表排序,读最底下两百行。真正含糊不清的文件就在那里,你也会在那里发现自己定义的类别其实彼此重叠。
然后只采用高置信度的答案,其余的交给人工。TypeSafe 发布了一个路由模式,把阈值和出错代价绑定在一起:低于 0.6 交给人工,高于 0.6 用于便宜且可撤销的操作,更贵的则设更高的门槛。加一个标签几乎是撤销成本最低的操作,所以在这里设一个低门槛说得通,而删文件就不行。
| 步骤 | 你要做什么 | 为什么是这个顺序 |
|---|---|---|
| 1. 导出 | 把文件名、路径、说明和备注,每个素材汇总成一条文本记录 | 没收集起来,你就无法判断 |
| 2. 手工标注 | 自己给 100 个文件打标签,并留着它们 | 这是判断这一切是否有效的唯一尺度 |
| 3. 提问 | 把问题集跑遍所有文件,写到一张表格里 | 此时还没有任何东西碰到素材库 |
| 4. 核对 | 和你的 100 个对照,并读置信度最低的行 | 是在你自己的数据上的一致率,不是别人的基准测试 |
| 5. 应用 | 只把超过你阈值的答案写回去 | 剩下的交给人工排队处理,不是失败 |
最后你得到什么
不是整洁的素材库,而是可搜索的——后者更好,因为整洁会退化,而搜索不会。
现实的结果是:百分之八十的文件会得到一个营销活动、一个渠道和一个状态;几百个进入评审队列;而终于有人能不打开文件夹就回答「我们有蓝色包装的照片吗」。
而你最终得到的,是比标签更持久的东西:一份写下来的、关于你的类别到底意味着什么的定义,由使用它的人反复推敲。那份文档的寿命,会长过你用来打标签的任何模型。
素材库整理问题
它会去看图像本身吗?
不会。TypeSafe 的文档说输入必须是文本。它读的是文件名、路径、说明、备注,以及文件周围任何其他书面记录。
如果一个文件不属于我任何类别怎么办?
它无论如何都会选最接近的那个。一项预先注册的评测发现:在没声明逃生选项时,30 个超出范围案例里有 0 个被标记出来。永远要声明 none_of_these。
整理整个素材库要花多少?
按公布的每百万输入 token 0.042 美元计算,两万个素材、假设每个 300 token,问一个问题大约 25 美分,问五个也差不多。
Ciyo 能做到这个吗?
不能。Ciyo 不运行 Jev,而且 Ciyo 是一个用来创造作品的画布,不是素材管理器。这篇文章讲的是一项值得理解的活儿,不是 Ciyo 的功能。
继续阅读
Ciyo 写作的主题,是创意与智能体工具背后的那些模型,并会对它能运行的那些进行测试。