模型 · System One
评判四个变体,以及决策模型补上的那道缺口
生成选项是容易的那一半。在它们之间做选择,是吃掉一整个下午的那一半,也是大多数创作工具留给你自己的那一半。
于是我们认真地跑了一遍评审流程:为一家虚构的港口咖啡馆做了四张方形促销图,写了四条标准,并让一个模型对每张图按每条标准打分。结果很有用,也正好暴露出像 Jev 这种类型化决策模型旨在消除的弱点。Ciyo 无法运行 Jev —— 它不生成图像也不生成视频,也不在我们的任何一个模型注册表之中 —— 所以本文展示今天能用的部分,并标出该由别的东西接手的那道缝。
四个变体,一个优惠
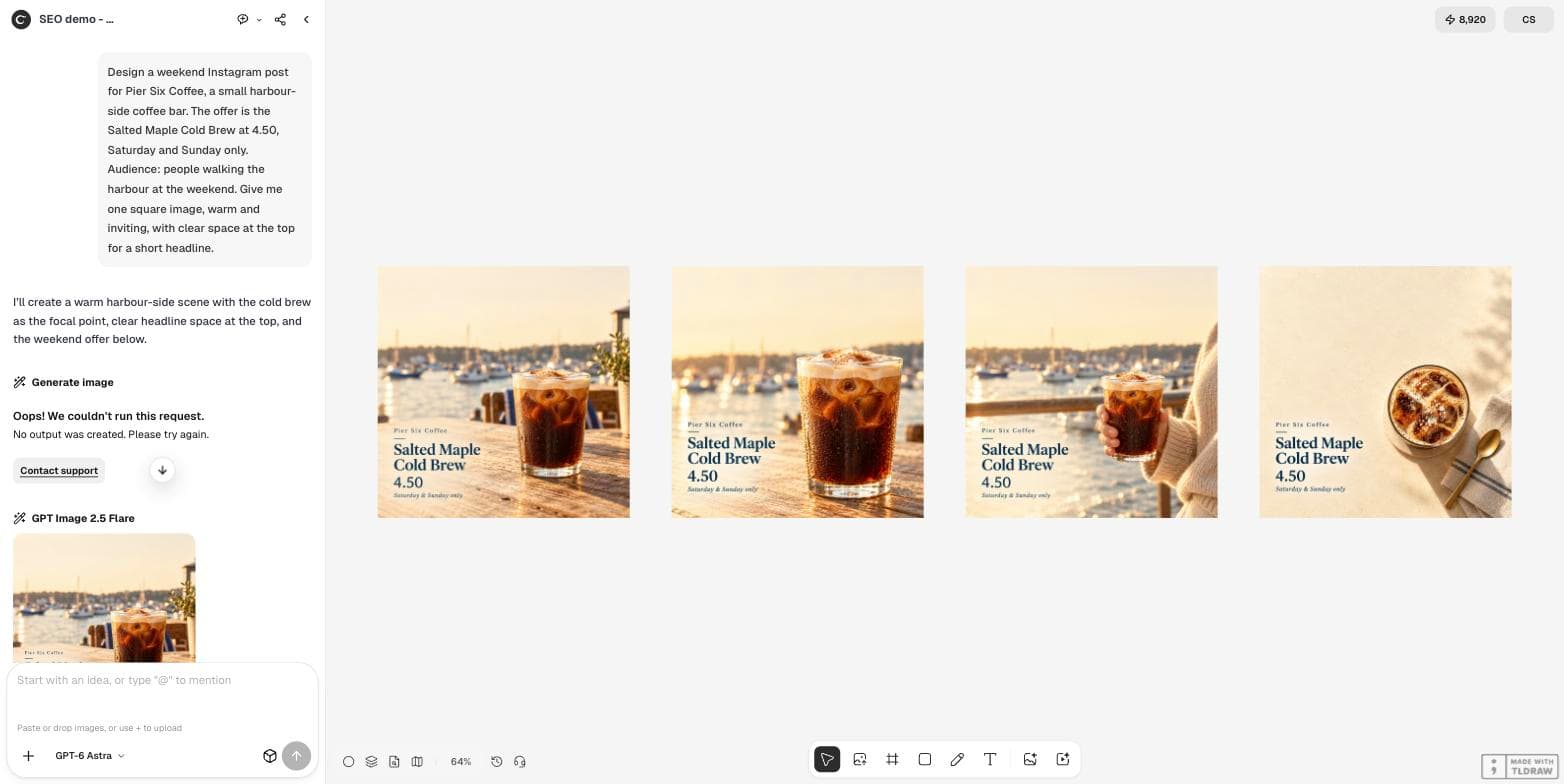
简报是为虚构的港口酒吧 Pier Six Coffee 做的一个周末饮品促销:Salted Maple Cold Brew,售价 4.50,仅限周六和周日,面向在港口散步的人。我们于 2026年9月21日 在 Ciyo 上跑了一遍。原始简报产出了一张图;另外三张是刻意生成的替代方案——玻璃杯的特写、在港口栏杆旁端着的杯子,以及台面上方的俯拍。
四个候选是现实的数量。多到无法全部记在脑子里,又少到一个人真的会把每一张都看一遍。
在你看之前先把标准写出来
让一次评审流程值得做的纪律,是在看到候选之前就写下你要评判什么。否则你只是在为已经喜欢的那张找理由。
四条标准,每条都是一道有答案的问题:饮品是否最先抓住视线;价格在小图尺寸下是否可读;预留的标题位置是否真的清晰;整体是否读起来像周末港口的场景。每一条,没见过这个品牌的人都能核对。
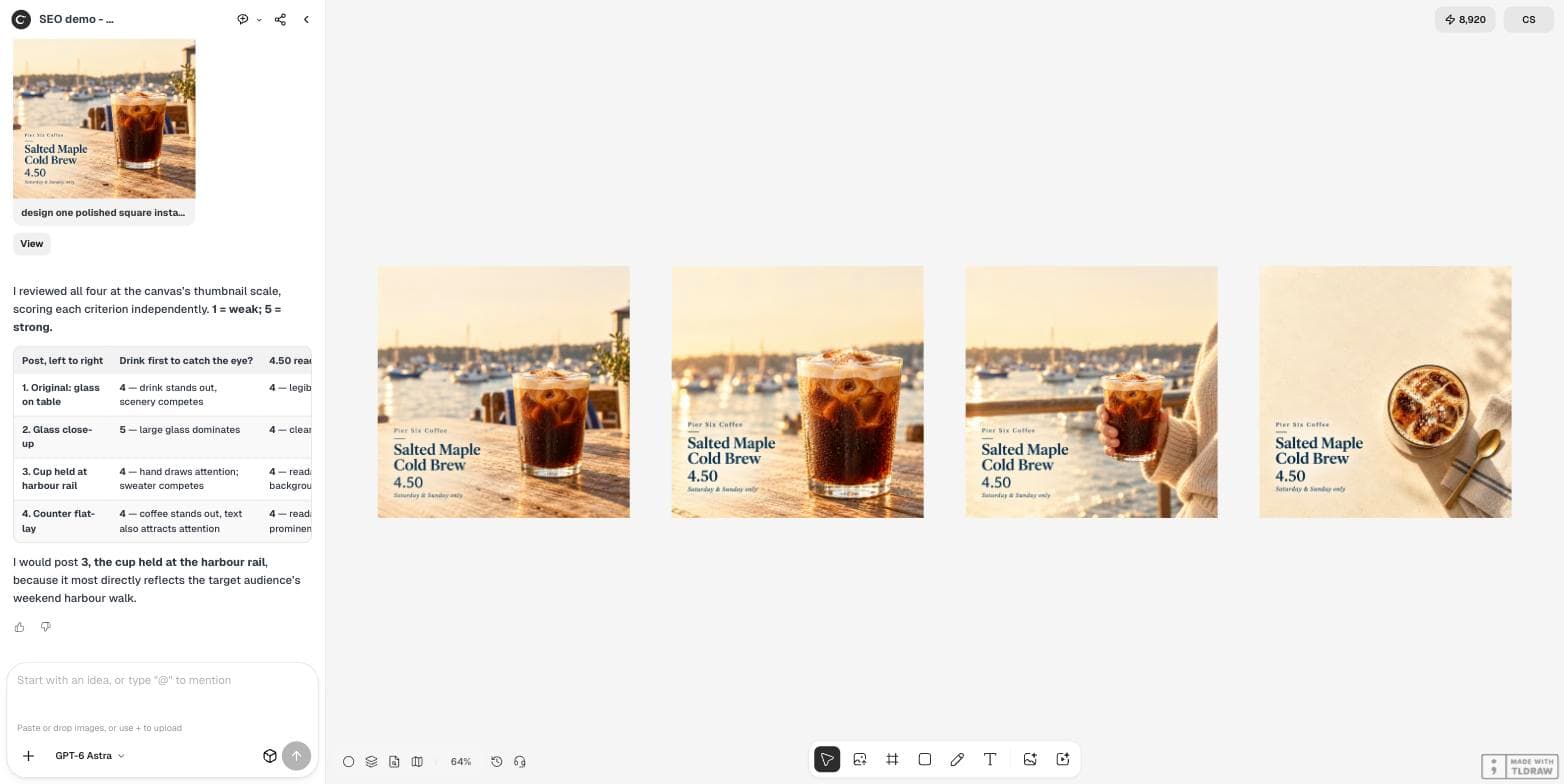
读取画布上的4张帖子。按4条独立标准,对每张从1到5打分,逐条单独发问:(1) 饮品是否最先抓住视线,(2) 4.50的价格在小图尺寸下是否可读,(3) 顶部标题区是否真的清晰,(4) 是否读起来像周末港口场景。给我一张表,每行一张帖子、每列一条标准,然后说出你会发布哪一张,以及唯一的理由。返回了什么
成功了。模型以小图尺寸读完了全部四张,产出一张四乘四的表,每个格子里都附了简短理由,并点名了一个胜出者:在港口栏杆旁端着的杯子,「因为它最直观地映照了读者周末在港口散步的情景」。这是一个站得住脚的回答,是拿我们最先写下的标准对照得出的。
它也捕捉到了那个唯一的真实失败。台面上的俯拍在「读起来像周末港口场景」上得了 1 分,并备注说没有任何可见的港口线索,周末全靠文案传达。这恰恰是一个人在下午四点、对着第四个变体时会漏掉的东西。
暴露弱点的那个数字
16 个单元格。其中 15 个回来的是 4 或 5。整张表里唯一起到区分作用的分数,就是那个 1。
所以这张表是个好的故障探测器,却是差的排序器。它能可靠地告诉你哪个变体坏了。它不能可靠地告诉你存活下来的三个变体里哪个最好,因为在「一到五」的量表上它不用中间段。
这不是这个模型或这条指令的缺陷。当一个判断不得不表达成一句含有数字的话时,就会这样。
| 问题 | 回答得好吗 | 原因 |
|---|---|---|
| 有没有变体是坏的? | 是 | 俯拍在港口场景上得了 1 分,且给出了具体理由 |
| 好的里面哪个最好? | 否 | 16 个单元格里有 15 个是 4 或 5;量表没能把它们区分开 |
| 明天打分还会一样吗? | 未知 | 我们只跑过一次;可重复性恰恰是散文式打分器最弱的地方。 |
| 人还是应该看一眼吗? | 是 | 这里没有任何东西决定一个品牌的调性,而胜出者只是基于一条理由被选出的 |
System One 模型会落在何处
这就是那道缝。一个类型化的决策模型不会写一句含有分数的话;它返回你声明了类型的一个值,附带概率和一个置信度数值,并且再问一次会返回同样的值。
放到这个具体任务上,意味着四个 Score 问题加一份明确的评分量表——不是「1 到 5」,而是四个带书面定义的具名等级——对每张帖子评估,再加上一个用于整体判定的 Choice,并带明确的 `needs_a_human` 选项。合并规则写在你自己代码里:付费投放时可以让可读性重于氛围,自然投放时反过来。
你将获得的不是更好的品味。而是一个每次运行都意味相同的分数,一个用来决定何时该让人来看的置信度的值,以及一条不用重写指令就能读和修改的规则。
你会失去的是理由。告诉我们俯拍没有港口线索的那个格子是散文,而决策模型不生产散文。实际中,有意思的设计是两者兼备:给排序和路由用类型化的分数,给解释它的那句话用语言模型。
Jev 在这里做不到什么,直说
它无法看帖子。TypeSafe 自己的文档写明,state 必须是一个字符串、一个 JSON 对象,或一组文本值的数组,并且图像、音频和视频目前还不支持。视觉评审流程超出了这个模型今天能接受的范围。
它也不能制作变体。它不生成图像也不生成视频,正因如此它不在 Ciyo 的任何一个模型注册表里,也正因如此 Ciyo 无法提供它。
所以这篇文章观点的诚实版本是一个文本形状的:决策模型可以评判简报、图注、替代文本、营销元数据和一张渲染图的结构化描述——也就是创意工作里本来就是文字的那些部分。图片仍然需要眼睛,而今天那双眼睛是你自己的,或是一个视觉模型的。
尽管如此,还是跑一遍评审流程。在你看之前把标准写下来,就是价值的大部分,而且你手头任何模型都能用。
评审流程的问题
Jev 能给我的广告变体打分吗?
不是图片。它文档里写明的 state 只有文本——一个字符串、一个 JSON 对象,或一组文本值的数组——所以图片在它今天接受的范围之外。它能打分的是简报、图注或结构化描述。
为什么几乎每个分数回来都是 4 或 5?
因为把判断表达成写出来的数字,散文模型会把量表往顶端压缩。每个格子里写下的理由,承载的信息比那些数字更多。
尽管如此,评审流程还值得跑吗?
值得。它在做出来的那个下午就捕捉到了一处真实的失败;而无论用哪个模型打分,看之前把标准写下来都是好处的大部分。
Ciyo 运行 Jev 吗?
不。它不生成图像也不生成视频,也不在 Ciyo 的任何模型注册表里。本文的打分是由 GPT-6 Astra 完成的,而 Ciyo 确实运行它。
跑你自己的评审流程
生成四个变体,在看之前写下四条标准,并让智能体对每一个变体都打分。