Modelos · System One
Juzgar cuatro variantes y la brecha que un modelo de decisión llena
Generar opciones es la mitad fácil. Elegir entre ellas es la mitad que se come una tarde entera, y es la mitad que la mayoría de las herramientas creativas te dejan a ti.
Así que ejecutamos la pasada de revisión como corresponde: cuatro publicaciones promocionales cuadradas para un bar de café portuario de ficción, cuatro criterios escritos y un modelo al que se le pidió puntuar cada publicación en cada criterio. El resultado fue útil, y además mostró exactamente la debilidad que un modelo de decisión tipado como Jev está diseñado para eliminar. Ciyo no puede ejecutar Jev — no produce imagen ni vídeo y no figura en ninguno de nuestros registros de modelos — así que este artículo muestra qué funciona hoy y marca la costura donde iría otra cosa.
Cuatro variantes, una oferta
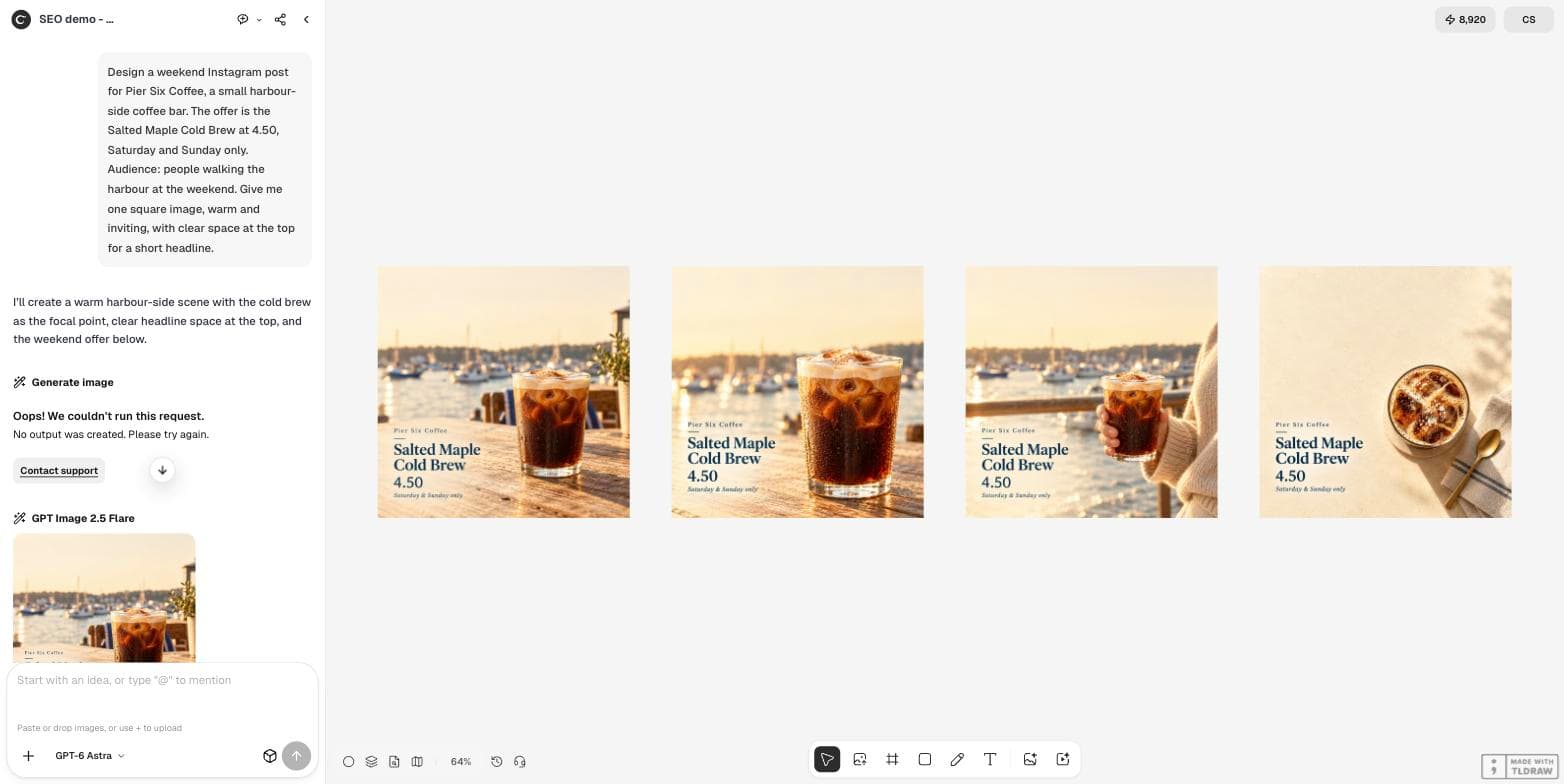
El encargo fue una promoción de bebida de fin de semana para Pier Six Coffee, un bar portuario inventado: la Salted Maple Cold Brew a 4.50, solo sábado y domingo, dirigida a quienes pasean por el puerto. Lo ejecutamos en Ciyo el 21 de septiembre de 2026. Uno de los posts salió del encargo original; se generaron tres más como alternativas deliberadas — un primer plano del vaso, una taza sostenida en la barandilla del puerto y una toma plana sobre el mostrador.
Cuatro candidatos es el número realista. Basta para que no puedas tenerlos todos en la cabeza, y pocos para que una persona mire cada uno de verdad.
Escribe los criterios antes de mirar
La disciplina que hace que una pasada de revisión merezca la pena es anotar qué estás juzgando antes de ver los candidatos. Si no, racionalizas el que ya te gustaba.
Cuatro criterios, cada uno una pregunta con respuesta: ¿el refresco atrae la mirada primero?; ¿el precio se lee a tamaño de miniatura?; ¿el espacio reservado para el titular está realmente claro?; ¿se lee como una escena de puerto de fin de semana? Cada uno de ellos es comprobable por alguien que nunca ha visto la marca.
Lee los cuatro posts en el lienzo. Puntúa cada uno de 1 a 5 en cuatro criterios separados, preguntando por cada uno por separado: (1) ¿el refresco es lo primero en lo que se posa la mirada?, (2) ¿el precio de 4.50 se lee a tamaño de miniatura?, (3) ¿el espacio del titular superior está realmente claro?, (4) ¿se lee como una escena de puerto de fin de semana? Dame una tabla con una fila por post y una columna por criterio, y luego nombra el que publicarías y la única razón.Lo que volvió
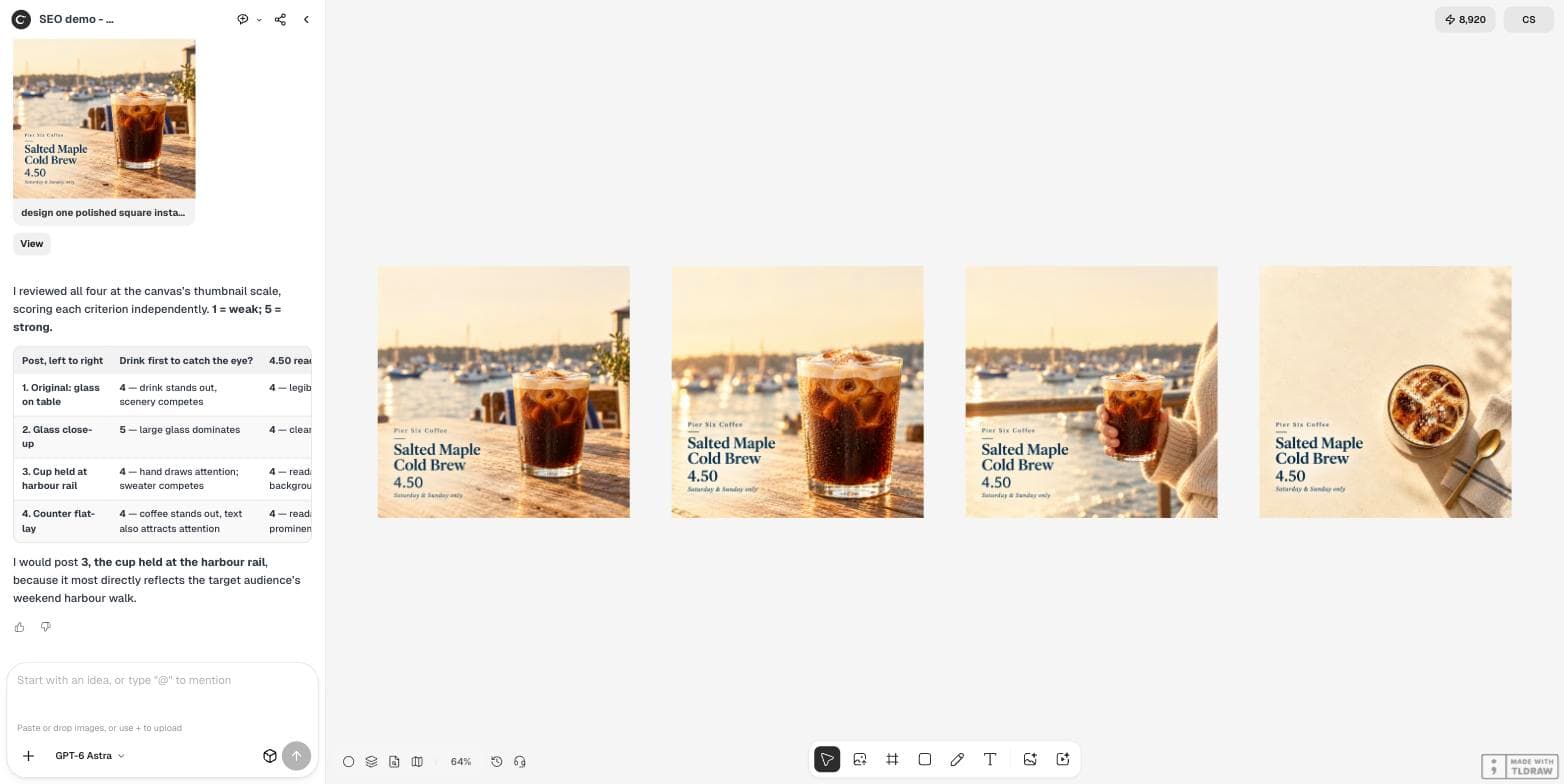
Funcionó. El modelo leyó los cuatro a escala de miniatura, produjo una tabla de cuatro por cuatro con una justificación corta en cada celda y nombró un ganador: la taza sostenida en la barandilla del puerto, «porque refleja más directamente el paseo del público por el puerto el fin de semana». Esa es una respuesta defendible, alcanzada frente a criterios que anotamos primero.
También detectó el único fallo real. La toma plana sobre el mostrador obtuvo un 1 en «se lee como una escena de puerto de fin de semana», con la nota de que no hay señales visibles del puerto y que el fin de semana solo se transmite por el texto. Eso es exactamente el tipo de cosa que una persona pasa por alto a las cuatro de la tarde en la cuarta variante.
El número que delata la debilidad
Dieciséis celdas. Quince de ellas volvieron con un 4 o un 5. La única puntuación diferenciadora en toda la tabla fue ese 1.
Así que la tabla es un buen detector de fallos y un mal ordenador. Te dirá con fiabilidad qué variante está rota. No te dirá con fiabilidad cuál de las tres variantes supervivientes es la mejor, porque en una escala de uno a cinco no usa el medio.
No es un defecto de este modelo ni de este prompt. Es lo que pasa cuando un juicio debe expresarse en una frase que contiene un número.
| Pregunta | Bien respondido | Por qué |
|---|---|---|
| ¿Alguna variante está rota? | Sí | La toma plana obtuvo un 1 en escena de puerto, con una razón específica |
| ¿Cuál de las buenas es la mejor? | No | Quince de dieciséis celdas fueron un 4 o un 5; la escala no las separó |
| ¿Puntuaría lo mismo mañana? | Desconocido | Lo ejecutamos una vez; la repetibilidad es exactamente lo que un puntuador de prosa hace peor. |
| ¿Debería mirar un humano igual? | Sí | Nada aquí decide el tono de una marca, y el ganador se eligió por una sola razón |
Dónde encajaría un modelo System One
Esta es la costura. Un modelo de decisión tipado no escribe una frase con una puntuación; devuelve un valor de un tipo que declaraste, con probabilidades y un número de confianza, y devuelve el mismo valor cuando se le pregunta otra vez.
Para esta tarea concreta eso significaría cuatro preguntas Score con una rúbrica explícita — no «de 1 a 5» sino cuatro niveles nombrados con definiciones escritas — evaluadas contra cada post, más una Choice para la decisión global con una opción explícita `needs_a_human`. La regla de combinación viviría en tu propio código, donde podrías dar más peso a la legibilidad sobre la atmósfera en una colocación de pago y al revés en un post orgánico.
Lo que ganarías no es mejor gusto. Es una puntuación que significa lo mismo en cada ejecución, un valor de confianza para decidir cuándo debe mirar una persona, y una regla que puedes leer y cambiar sin reescribir un prompt.
Lo que perderías son las razones. La celda que nos dijo que la toma plana no tiene señales de puerto es prosa, y un modelo de decisión no produce prosa. En la práctica, el diseño interesante es ambos: una puntuación tipada para el ranking y el enrutamiento, y un modelo de lenguaje para la frase que lo explica.
Lo que Jev no puede hacer aquí, sin rodeos
No puede mirar los posts. La propia documentación de TypeSafe indica que state debe ser una cadena, un objeto JSON o un array de valores de texto, y que las imágenes, el audio y el vídeo aún no son compatibles. Una pasada de revisión visual queda fuera de lo que el modelo acepta hoy.
Tampoco puede crear las variantes. No genera imagen ni vídeo, y por eso no aparece en ninguno de los registros de modelos de Ciyo y por eso Ciyo no puede ofrecerlo.
Así que la versión honesta de la idea de este artículo es una con forma de texto: un modelo de decisión puede juzgar el brief, el caption, el texto alternativo, los metadatos de la campaña y la descripción estructurada de una render — las partes del trabajo creativo que ya son palabras. La imagen sigue necesitando ojos, y hoy esos ojos son tuyos o los de un modelo de visión.
Ejecuta la pasada de revisión de todos modos. Anotar los criterios antes de mirar es la mayor parte del valor, y funciona con el modelo que tengas.
Preguntas de la pasada de revisión
¿Puede Jev puntuar mis variantes de anuncios?
No las imágenes. Su state documentado es solo texto — una cadena, un objeto JSON o un array de valores de texto — así que las imágenes quedan fuera de lo que acepta hoy. Sí podría puntuar el brief, el caption o una descripción estructurada.
¿Por qué casi todas las puntuaciones volvieron con un 4 o un 5?
Porque un modelo de prosa que expresa un juicio como un número escrito comprime la escala hacia arriba. Las razones escritas en cada celda llevaban más información que los dígitos.
¿Vale la pena ejecutar la pasada de revisión de todos modos?
Sí. Detectó un fallo real la misma tarde en que se hizo, y anotar los criterios antes de mirar es la mayor parte del beneficio sin importar qué modelo los puntúe.
¿Ejecuta Ciyo a Jev?
No. No produce imagen ni vídeo y no figura en ninguno de los registros de modelos de Ciyo. La puntuación de este artículo la hizo GPT-6 Astra, que Ciyo sí ejecuta.
Ejecuta tu propia pasada de revisión
Genera cuatro variantes, escribe cuatro criterios antes de mirarlas y haz que el agente puntúe cada variante en cada uno.