Agentes · Evaluación
Jev dentro de un bucle de agente: la capa de decisión
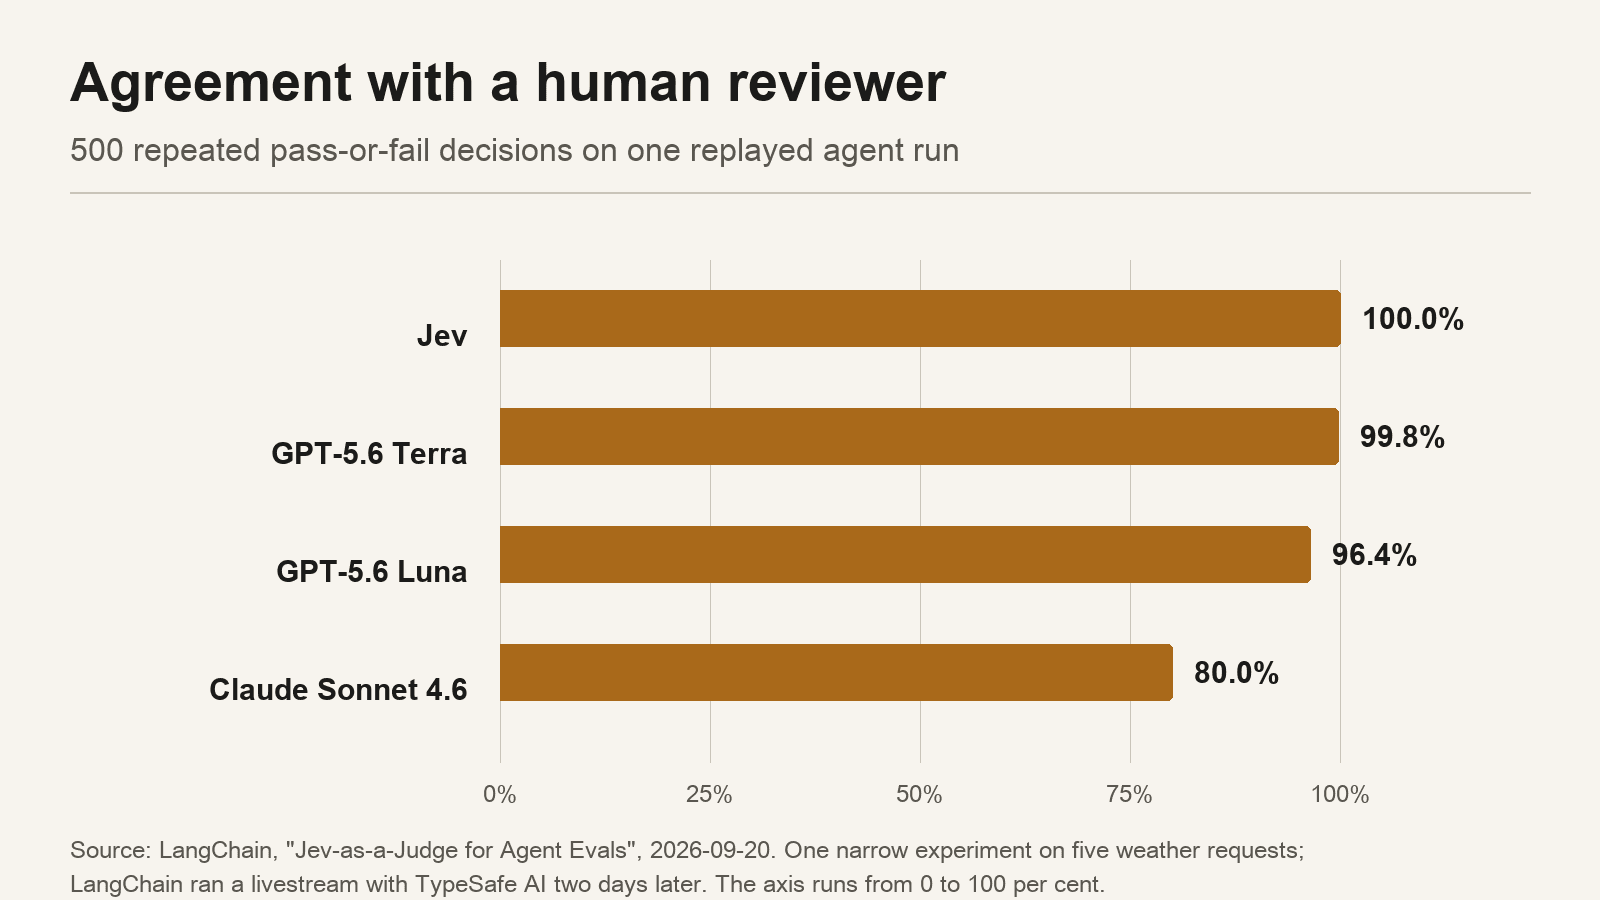
Los agentes funcionan en bucle. Un modelo decide qué hacer, una herramienta lo ejecuta, algo evalúa el resultado y el bucle gira otra vez. Los dos primeros pasos se llevan la atención. El tercero es donde suele doler la ingeniería.
Jev, lanzado por TypeSafe AI el 15 de septiembre de 2026, está hecho para ese tercer paso y para nada más. Esto es un repaso de dónde encaja, qué sustituye y qué midió de verdad la primera prueba publicada fuera del fabricante.
Dos formas de juzgar un paso hoy
La evaluación en código llegó primero y sigue siendo lo más barato que existe. Una función comprueba si el agente llamó a la herramienta, si el JSON se analizó bien, si el número está dentro de rango. Es rápida, determinista y estrecha: necesita entradas fijas, y el comportamiento de un agente no es fijo. Decidir si el agente usó bien el resultado de una herramienta para responder a la persona usuaria no es algo que puedas enumerar en un condicional.
Así que los equipos recurren a un juez basado en LLM, que acepta la traza sin estructurar y la puntúa con un prompt. Eso compra generalidad y la paga tres veces: en latencia, porque el juicio se escribe token a token; en dinero, en cada llamada; y en varianza, porque la misma traza puede puntuar distinto en dos ejecuciones.
La tercera opción es un modelo que trata la evaluación por lo que es, una tarea de decisión. Dado un estado y una pregunta tipada, devuelve la respuesta tipada con sus probabilidades.
Dónde va un modelo System One
Su hueco es el paso tres. No planifica, no llama a herramientas y no escribe la siguiente instrucción. Mira el estado que el bucle acaba de producir y responde preguntas cuyas respuestas declaraste de antemano.
Esa posición explica también por qué su latencia y su precio importan más de lo que parece. El paso tres se ejecuta en cada vuelta y, en un entorno en línea, puede ejecutarse sobre una gran parte de las trazas de producción en lugar de sobre una muestra, que es justo la decisión que el coste suele obligar a tomar.
Haz varias preguntas pequeñas, no una grande
La forma idiomática no es un prompt que pide un veredicto. Es un puñado de preguntas atómicas, cada una con sus respuestas declaradas, evaluadas contra el mismo estado y combinadas en tu propio código.
La documentación de TypeSafe dice que todas las preguntas se evalúan en paralelo y de forma aislada contra el mismo estado, de una sola vez, y que añadir preguntas apenas cambia el tiempo de respuesta. Así que el diseño natural es un abanico de preguntas estrechas: si se llamó a la herramienta, si la respuesta está fundamentada en las pruebas recuperadas, cómo de útil es en una rúbrica de uno a cinco, cuál de estos tres desenlaces de búsqueda describe la ejecución.
Cada una vuelve con probabilidades, y la lógica que las combina vive donde puedes leerla, probarla y cambiarla sin tocar ningún prompt.
Lo que encontró una prueba publicada
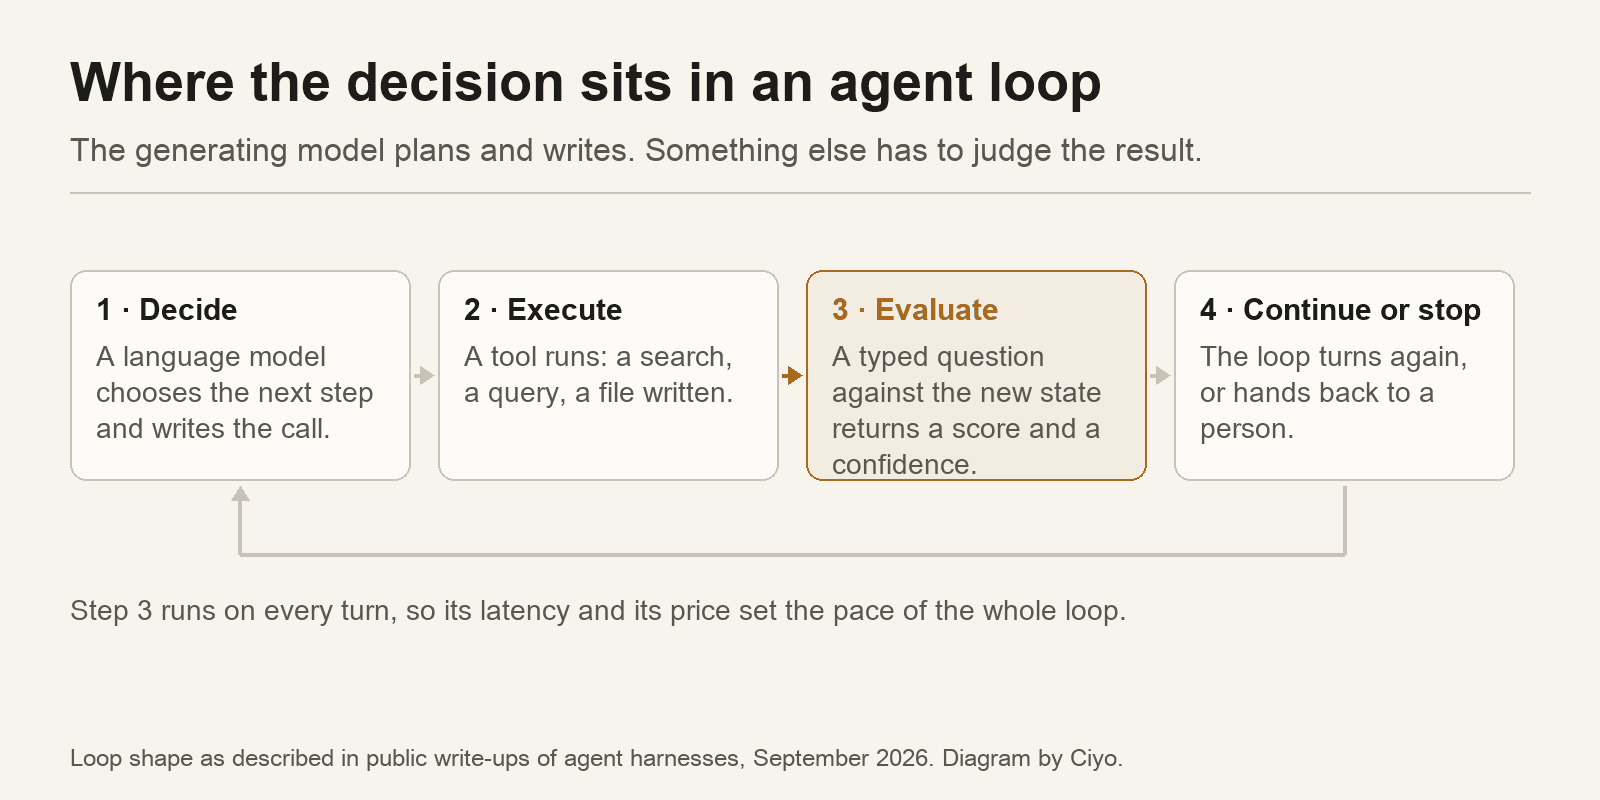
El 20 de septiembre de 2026, LangChain publicó un experimento que usa Jev como juez y lo compara con tres modelos de lenguaje sobre la misma ejecución de agente reproducida. En la decisión binaria de aprobado o suspenso, Jev coincidió con una persona revisora en las 500 decisiones repetidas; GPT-5.6 Terra coincidió en el 99.8 por ciento, GPT-5.6 Luna en el 96.4 y Claude Sonnet 4.6 en el 80.0.
La repetibilidad fue el resultado más afilado. En la puntuación continua de calidad, la varianza media por caso de Jev fue de 0.0000149, que LangChain describe como entre 92 y 913 veces menor que la de los tres modelos de lenguaje. La precisión te dice si un juez coincide con una persona; la varianza te dice si dirá lo mismo mañana. Un aparato de pruebas necesita las dos cosas.
LangChain es cuidadosa con lo que esto no demuestra. Lo llaman un experimento estrecho construido sobre cinco consultas meteorológicas, describen el hallazgo sobre la varianza como observacional y no causal, y publicaron el repositorio y las versiones fijadas de las bibliotecas para que otra persona pueda repetirlo. También hicieron una retransmisión en directo con TypeSafe dos días después, algo que conviene saber al sopesar el texto.
Publicado el 2026-09-18. El texto de una persona desarrolladora sobre el mismo patrón de bucle: un LLM decide, una herramienta ejecuta y un modelo evalúa.
El modo de fallo contra el que conviene diseñar
Un juicio barato cambia el comportamiento. Cuando un veredicto cuesta una fracción de centavo, dejas de muestrear y empiezas a evaluarlo todo, que es de lo que se trata. También significa que un juez equivocado de forma consistente ahora se equivoca en todas partes, en silencio y a escala.
LangChain lo dice abiertamente: el coste bajo puede amplificar los errores, y un evaluador consistentemente equivocado produce retroalimentación mala más deprisa. Una varianza baja empeora eso antes de mejorarlo, porque un juez repetible es un error repetible hasta que alguien lo comprueba.
La mitigación es la aburrida. Mantén un conjunto de referencia etiquetado por personas, vuelve a medir la coincidencia cuando cambies una pregunta y lee una muestra de las trazas que el juez rechazó, no solo las que aprobó.
| Enfoque | Punto fuerte | Punto débil |
|---|---|---|
| En código | Determinista, casi gratis, auditable | Necesita entradas fijas; no puede juzgar comportamiento abierto |
| LLM como juez | Acepta trazas sin estructurar; general | Más lento, más caro y no determinista entre ejecuciones |
| Modelo System One | Respuestas tipadas con probabilidades; repetible; lo bastante barato para ejecutarlo sobre todo | Sin razonamiento abierto; una rúbrica equivocada ahora se equivoca de forma consistente |
Qué anotar antes de conectar uno
Tres cosas, y ninguna es un prompt. El estado: qué ve exactamente el modelo en cada llamada y con qué forma. Las preguntas: cada una atómica, con sus opciones o su rúbrica detalladas, porque eso es el tipo. Los umbrales: qué hace tu código con una confianza de 0.9 y qué hace con un 0.55.
Ese último punto es donde este estilo de modelo mueve el trabajo en lugar de eliminarlo. Un modelo de lenguaje esconde el umbral dentro de su prosa; una decisión tipada te entrega el número y te obliga a decidir. A los equipos que ya mantienen un conjunto de evaluación etiquetado esto les resultará fácil. Los que no lo tienen descubrirán que lo necesitaban igualmente.
Preguntas sobre la evaluación de agentes
¿Un modelo de decisión sustituye del todo a un juez basado en LLM?
Solo para preguntas cuyas respuestas puedes declarar de antemano. Todo lo que necesite una explicación, una reescritura o una crítica abierta sigue necesitando un modelo generativo.
¿Hacer más preguntas cuesta más tiempo?
La documentación de TypeSafe dice que las preguntas se evalúan en paralelo y de forma aislada contra el mismo estado, y que añadir preguntas apenas cambia el tiempo de respuesta.
¿Una coincidencia del 100 por ciento es un resultado de referencia?
No. Es un experimento estrecho sobre cinco consultas meteorológicas reproducidas, publicado por una empresa que hizo una retransmisión en directo con el fabricante dos días después. Trátalo como un primer dato.
Sigue leyendo
Ciyo escribe sobre los modelos que hay detrás de las herramientas creativas y de agentes, y prueba los que puede ejecutar.