AI モデル · 解説
System One モデルとは何か。Jev が実際に行うこと
TypeSafe AI は2026年9月15日に Jev を公開し、新しい種類の第一号だと述べました。「ソフトウェアがそのまま使える、速くて構造化された判断を行うために作られた、新しい種類の最先端モデル」、すなわち System One モデルです。
この一文をいちばん誤解しやすい読み方は、「小さな言語モデル」と受け取ることです。Jev は言語モデルではありません。文章を生成せず、あなたの説明文を書くこともできず、自由な問いに答えることも決してありません。文字列の生成を意図的に捨てており、この模型の面白いところはすべて、その引き換えから生まれています。
新しい種類と、それが捨てたもの
自己回帰型の言語モデルは、直前の語を条件にしながら1語ずつ取り出し、最後に文字列を返します。その文字列に構造があるとしても、それはモデルが真似を覚えた習わしにすぎません。だから、モデルから値を受け取る実運用の仕組みは、どれも最後には解析器と形式の検証と再試行を抱えることになります。
System One モデルは、順番を逆にしてその層を取り除きます。まず起こりうる出力を宣言し、そのうえで構造化された状態と、型のある問いを渡します。返ってくるのは、宣言した型の値です。そこに、起こりうる答え全体にわたる確率と確信度スコアが添えられます。
その代償は全面的です。文章もコードも、開かれた答えもありません。TypeSafe はこれを限界ではなく、設計上の意図的な引き換えだと説明しており、名前もそれを表しています。System One は速く自動的な判断、System Two は熟慮です。Jev はその第一号にすぎません。
| 観点 | 自己回帰型の言語モデル | System One モデル |
|---|---|---|
| 取り出し方 | 直前の語を条件に、1語ずつ | すべての出力を、一度の並列の問い合わせで |
| 出力 | 文字列。構造は真似を覚えた範囲のもの | あらかじめ宣言した、型の保証された構造化された値 |
| 不確かさ | あるとしても、言い回しからにじむ程度 | 答え全体にわたる確率と、確信度スコア |
| 学習 | RLHF。好まれる応答に合わせて最適化 | RLCD。較正された判断に合わせて最適化したとされる |
| 捨てたもの | 原理上は何もなし | 文字列の生成そのもの |
同じ問いに答える2つの道
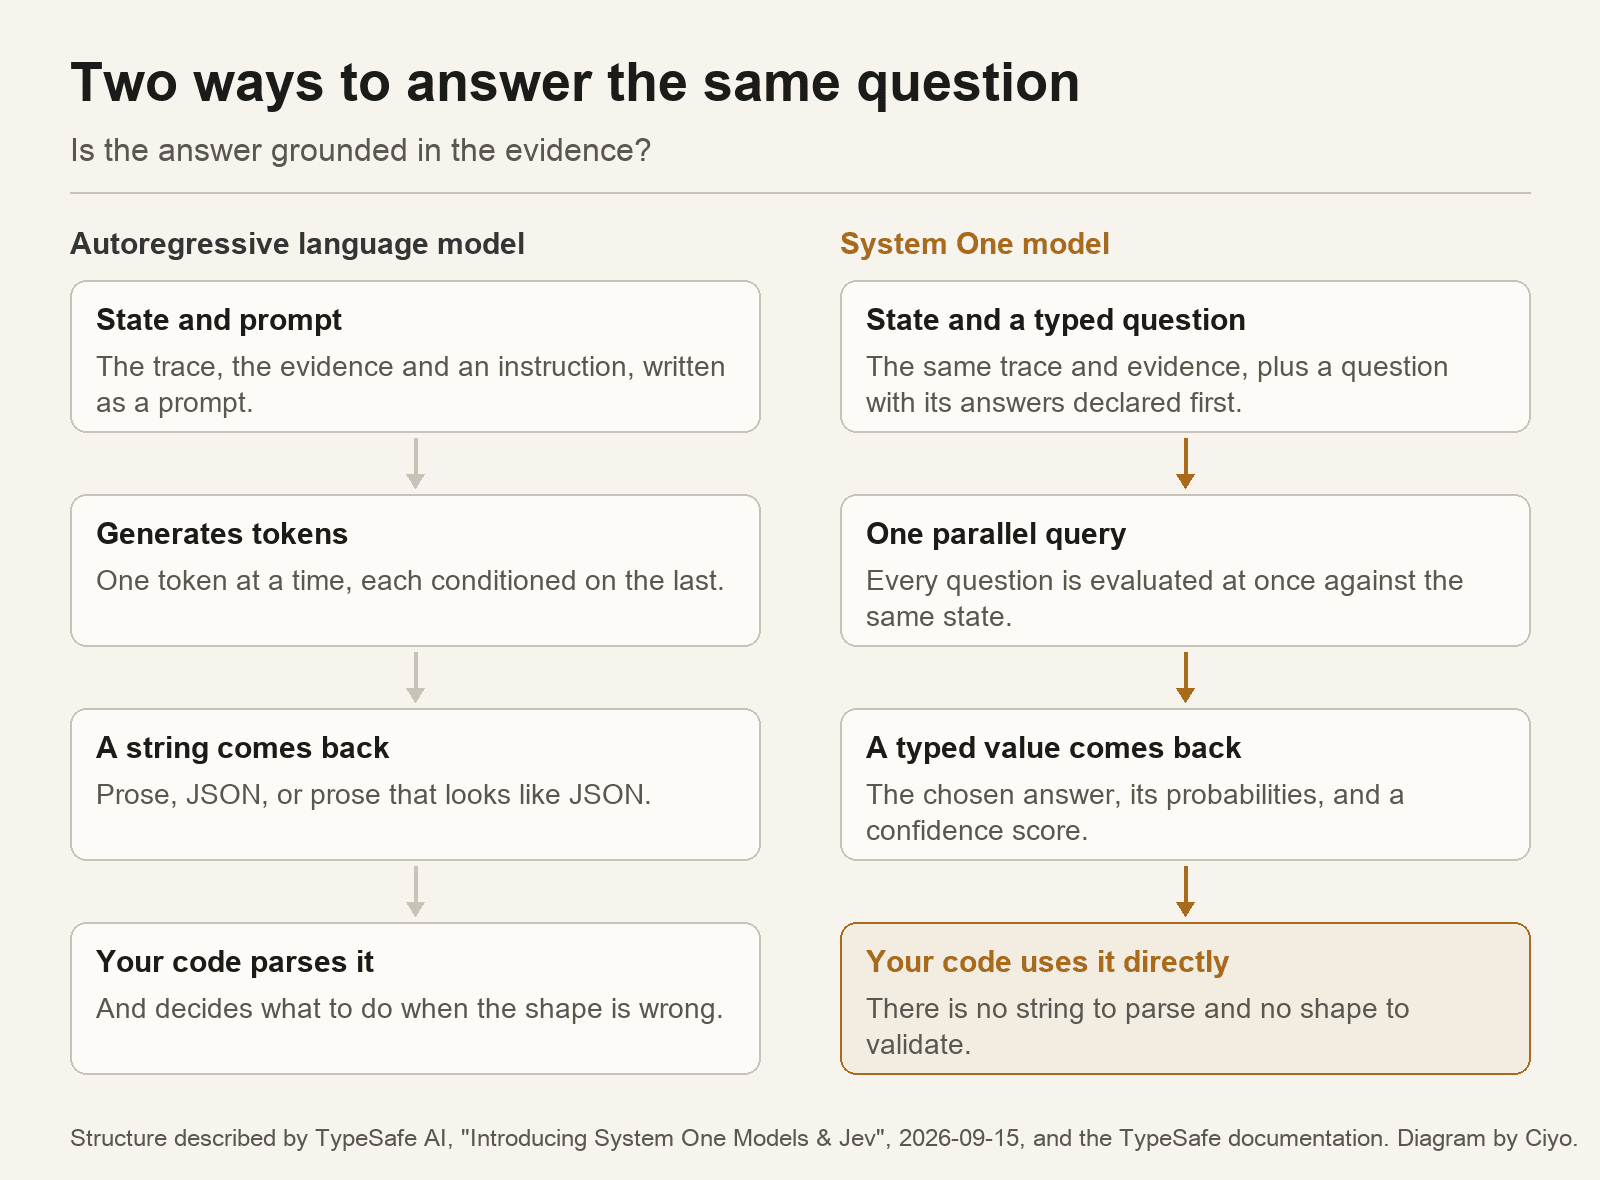
エージェントが絶えず立てる、具体的な問いをひとつ取り上げます。この答えは、取り出した根拠にもとづいているか。どちらの種類のモデルでも答えられます。違うのは道筋で、その道筋こそが話のすべてです。
左の道は見慣れたものです。右の道は文字列を一度も作りません。だから解析するものも、検証するものもなく、コードが待っている項目の代わりにモデルがもっともらしい文を書いてしまう、という種類の失敗も起きません。
細かい問いを立て、コードで組み合わせる
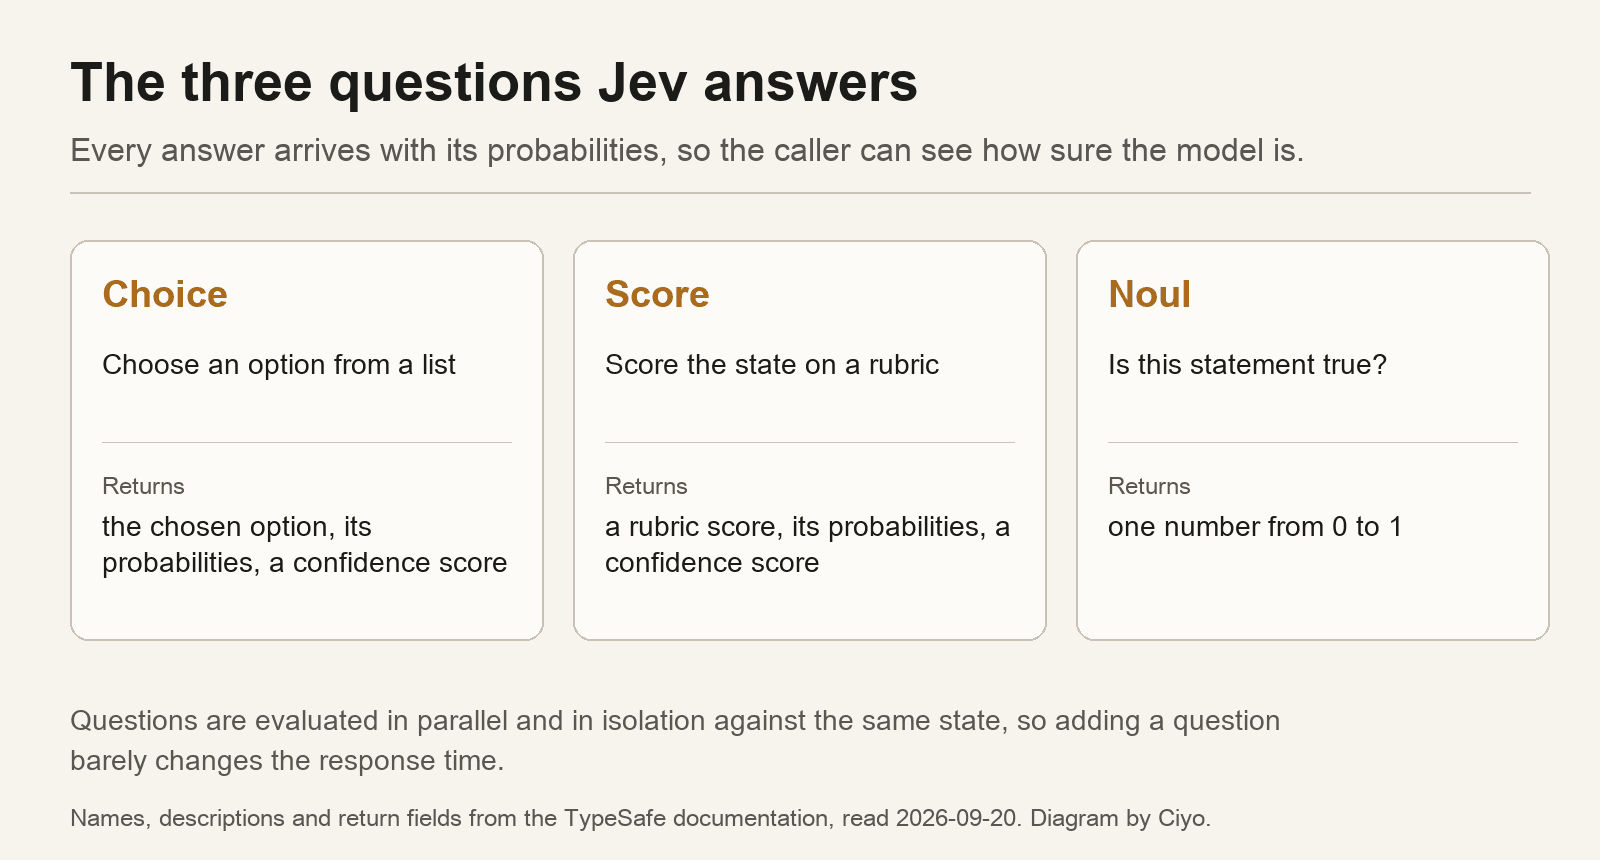
説明書に出てくる基本要素は3つだけです。Choice は一覧から選択肢をひとつ選び、選んだ選択肢と、すべての選択肢にわたる確率と、確信度スコアを返します。Score は評価基準に照らして状態を採点し、選択の代わりに点数を入れた同じ3つの項目を返します。Noul はある記述が真かどうかに答え、0 から 1 の間の数をひとつ返します。
技術者が軽く見がちなのは、組み合わせの決まりのほうです。すべての問いは同じ状態に対して、並列に、互いに独立に、一度で評価されます。ですから1件の記録について12個の問いを立てても、12回の往復にはなりません。説明書にははっきりこう書かれています。問いを増やしても応答時間はほとんど変わらない、と。
これによって、評価はふつうのコードで書くものになります。ひとつの長いプロンプトでいくつもの事柄をまとめて判断させ、JSON で報告させる代わりに、答えを宣言した小さな問いをいくつも立て、その結果を自分の目に見える場所で組み合わせます。
幻覚を起こさないという主張は、聞こえるより狭い
TypeSafe は、System One モデルは「幻覚を起こせない」と述べています。これは真偽についての主張ではなく、型についての主張として読んでください。起こりうる出力とその構造があらかじめ定められているため、モデルは宣言されていない分類も、壊れた構造の値も、存在しない文書について自信たっぷりに語る文も返せません。その種の不具合は、仕組みのうえで消えています。
残るのは、ふつうの間違いです。Choice はあなたの一覧から誤った選択肢を選ぶことがあります。Score は悪い答えを高く採点することがあります。モデルはどれくらい確からしいかを教えてくれますし、TypeSafe はその確率を較正されていて「認識のうえで正直」だと説明しますが、較正された 0.7 でも10回に3回は外れます。
だからこそ確信度の値は、おまけではなく窓口の一部になっています。9月18日の TechCrunch の記事で引用された開発者たちも、まさにその移り変わりを語っていました。数字の解釈はあなたの側に渡され、0.55 のときに何をするかは、モデルではなくあなたの設計の問題になります。
学習のしかたについて、公表されている範囲
TypeSafe はその手法を Reinforcement Learning for Calibrated Decisions、略して RLCD と呼び、対話モデルを形づくってきた RLHF に対置しています。RLHF が人の好む応答に向けて最適化するのに対し、RLCD は意味どおりの確率に向けて最適化するものだと説明されています。
名前と出力の約束ごとを越えると、内部の構造は公開されていません。TechCrunch は、創業者がその点について口を閉ざしたままだと書いており、重みも公開されていません。Jev の内部の仕組みを語る人がいたら、それは論文ではなく API の形からの推測です。
いまどこで動いているか
利用は先行アクセスの順番待ちで、typesafe.ai にコンソールと説明書があります。OpenRouter の TypeSafe の提供者ページには jev-latest と jev-1.13 が 32,000 トークンのコンテキストとともに載っていますが、これらは OpenRouter の公開のモデル一覧には出てきません。つまり開かれた経路ではなく、制限された経路です。
配布についてより示唆的なのは、基盤側の動きです。2026年9月17日、Cloudflare が Jev を自社の AI Gateway で使えるようにしたと発表しました。その説明は、このモデルの言葉づかいそのものです。状態と型のある問いを送り、コードがそのまま使える構造化された答えを受け取る、というものです。この種のモデルが多くの人に届くのは、アプリとしてではなく、すでに動かしている仕組みの中の1回の呼び出しとしてです。
2026-09-17 の投稿です。提供者が自社の連携を告知したもので、使えることの証拠であって、性能の証拠ではありません。
System One モデルについての質問
Jev は小さな言語モデルですか?
いいえ。自己回帰型ではなく、文章も生成しません。構造化された状態に対して型のある問いを評価し、宣言された型の値を、確率と確信度スコアとともに返します。
「幻覚を起こせない」とは、何を指していますか?
出力の形です。宣言していない分類や、壊れた構造の値は返せません。それでも誤った選択肢を選ぶことはあります。だからこそ、どの答えにも確信度の値が付いてきます。
今日から試せますか?
先行アクセスの順番待ち、TypeSafe のコンソール、あるいは Cloudflare の AI Gateway のような連携を通してのみです。重みは公開されておらず、OpenRouter の掲載も公開のモデル API には出てきません。
続けて読む
Ciyo は、制作とエージェントの道具の背後にあるモデルについて書き、動かせるものは試しています。