AI モデル · 数字
Jev の価格と速度の主張を確かめる
どの新製品の発表にも倍率が付きますが、Jev のものは大きいです。「同じ水準の最先端の知能」に対して 40〜200 倍速く、入力は100万トークンあたり $0.042、出力トークンは「FREE (too cheap to meter)(無料。計るには安すぎる)」です。
5日たった時点で、社外からの計測はちょうど1件です。この記事はその2つを並べます。どちらの結果も、発表の投稿から思い描くものとは違います。
TypeSafe が公表した内容
2026年9月15日の発表の投稿では、応答時間の範囲を 70〜500 ミリ秒とし、最先端の言語モデルの 3〜329 秒と比べています。40〜200 倍という数字はここから来ています。さらに、実運用の処理では 193.6 倍速く 444.6 倍安いこと、幻覚が0件、型の誤りも0件だと述べています。
価格の立て方は変わっているので、二度書いておきます。入力は100万ではなく10億単位で計られ、出力は無料です。9月18日の TechCrunch の記事は、それと並べて利用企業の数字も伝えています。Vercel は 5〜18 倍速いと計測し、別の現場は Gemini より 10〜20 倍安いとしています。
これらの数字はすべて、TypeSafe か、その初期の利用者から出ています。だからといって間違いだということにはなりません。ただ、どれも検証されていないということです。
| 主張 | 数字 | 出典 | 独立した検証か |
|---|---|---|---|
| 応答時間 | 70〜500 ミリ秒、対 3〜329 秒 | TypeSafe の発表の投稿 | いいえ |
| 実運用の処理での速さ | 193.6 倍速い | TypeSafe の発表の投稿 | いいえ |
| 実運用の処理での費用 | 444.6 倍安い | TypeSafe の発表の投稿 | いいえ |
| 信頼性 | 幻覚0件、型の誤り0件 | TypeSafe の発表の投稿 | いいえ |
| 価格 | 入力は100万トークンあたり $0.042、出力は無料 | TypeSafe の価格表 | 公表された値で、計測ではない |
| 利用企業での速さ | 5〜18 倍速い | Vercel、TechCrunch 経由 | いいえ。利用企業による報告 |
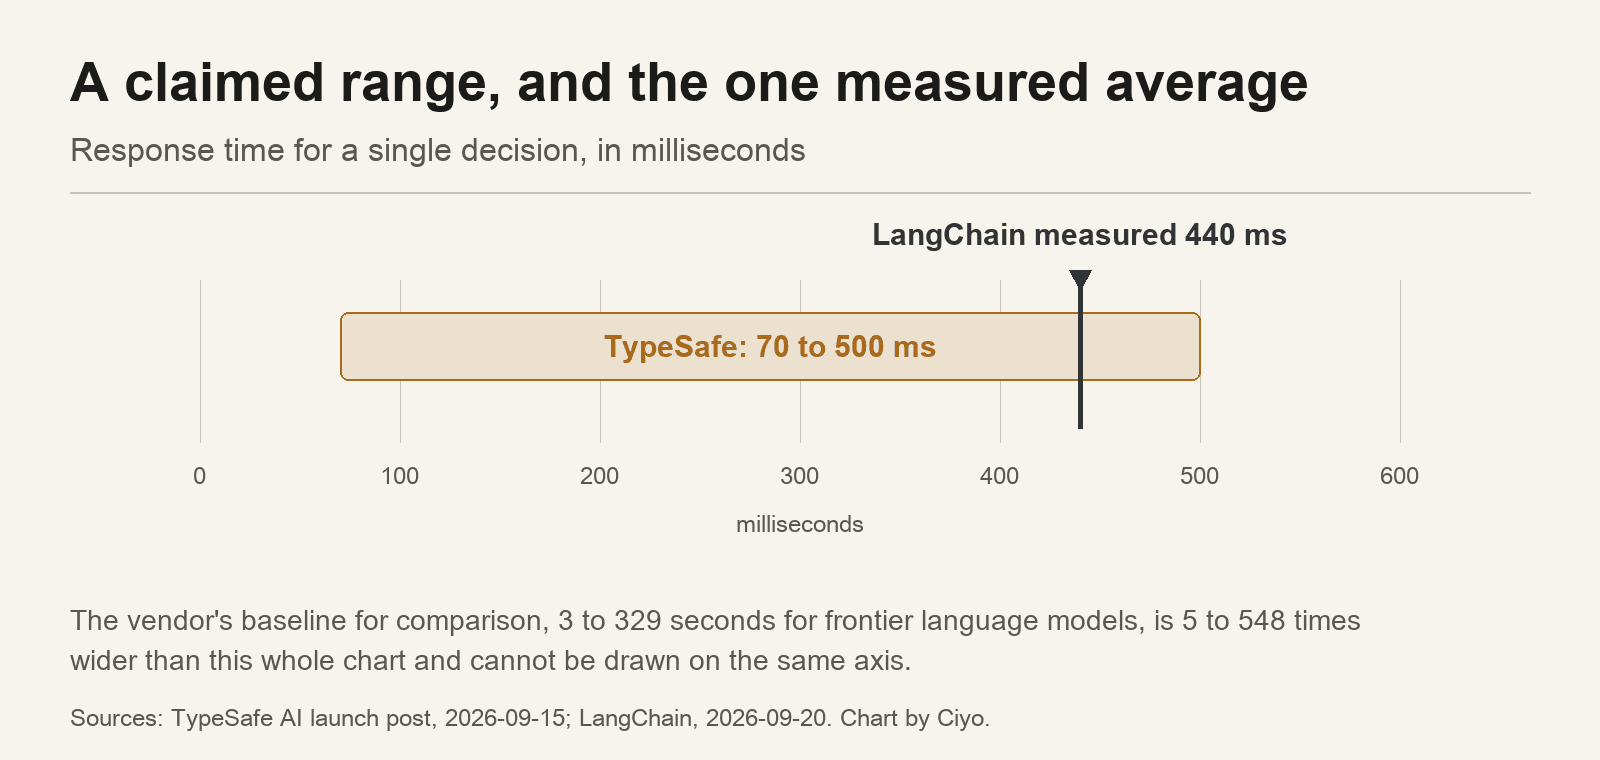
主張された範囲と、1つだけの計測値
9月20日の LangChain の実験は、1回の呼び出しあたり平均 0.44 秒と報告しています。これを発表の投稿の範囲と同じ軸に置くと、範囲の中に入り、しかも遅いほうの端に近くなります。主張された 70〜500 に対して 440 ミリ秒です。
2つは同時に成り立ちます。そこが役に立つ観察です。提供元の範囲は否定されていません。同時に、見出しの倍率も再現されていません。倍率は比であり、効いているのは比べる相手のほうだからです。3秒かかる最先端のモデルと比べれば、440 ミリ秒はおよそ7倍速いのであって、200倍ではありません。
同じ実行にかかった費用
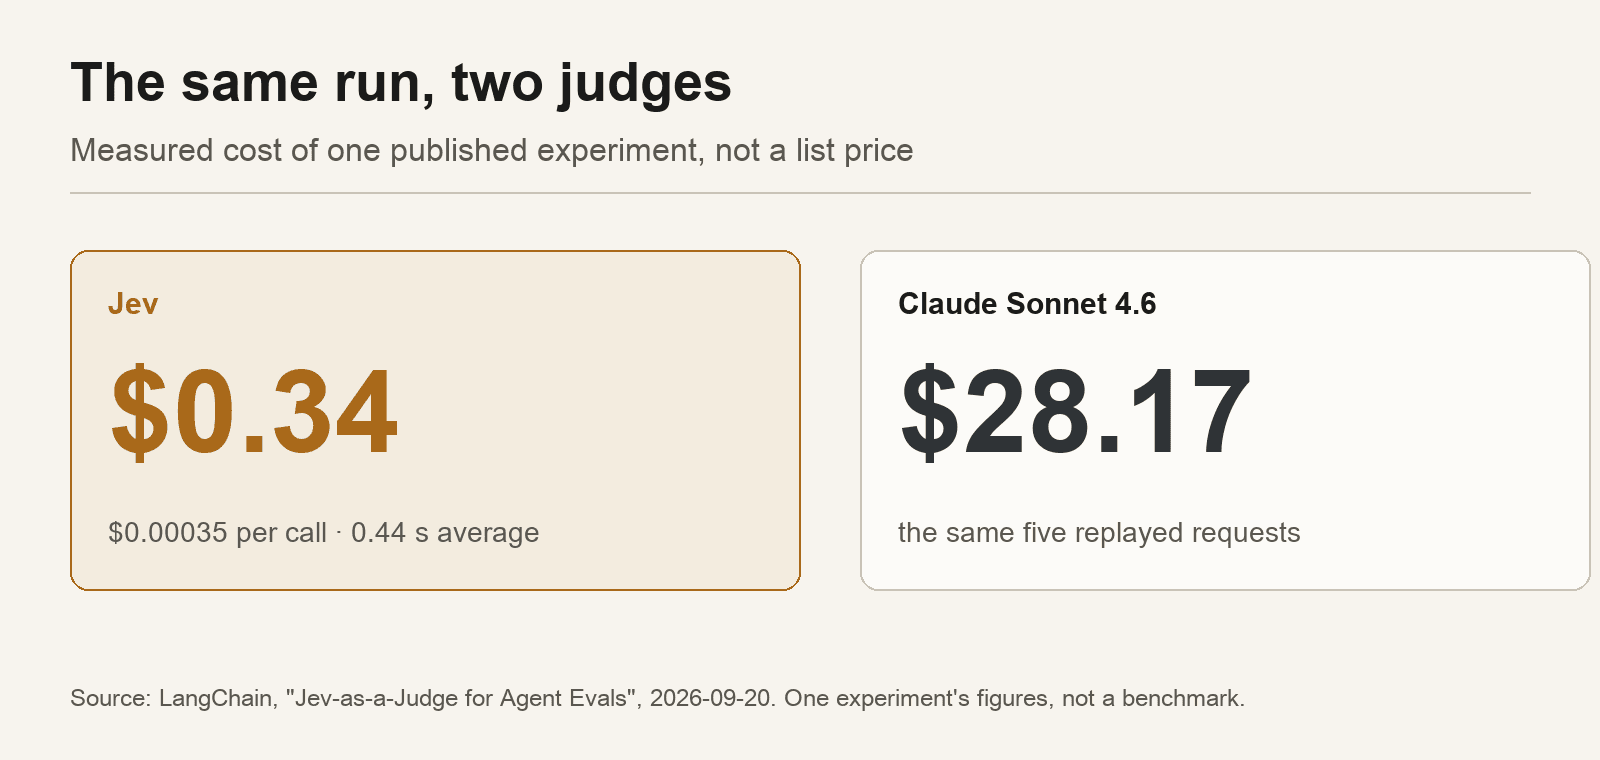
費用の比較のほうが、あいまいさは少ないです。LangChain の実験では、Jev の判定1回が $0.00035 で、判定を繰り返した実行全体で $0.34 でした。同じ実行を Claude Sonnet 4.6 で行うと $28.17 で、差はおよそ 83 倍です。
83 は 444 ではありません。それでも、現場のやり方を変えるには十分です。評価をひととおり回して数十セントなら、網羅と予算のどちらを取るかで悩むのをやめ、標本ではなくすべての記録に判定役を走らせるようになります。
2026-09-20 に Daniel Shea と Seán Roche が公開し、保管庫と固定した版も出しています。LangChain はその2日後に TypeSafe との生配信を行いました。
数字と一緒に注意書きも読む
LangChain は自分たちで限界を書き出しています。読む価値のある試験の証です。この実験は、1つのエージェントで再生した5件の天気の依頼にもとづいています。ばらつきの結果は観察であって、学習の目的がそれを生んだ証拠ではないと述べています。そして、費用が低いと誤りが増幅されうると警告しています。一貫して外れる評価役は、悪い手がかりを大規模に生み出すからです。
さらに、版を固定して保管庫も公開しているので、追試ができます。それがベンチマークと自慢話の違いであり、発表から5日の時点では、本来あるべきよりもまれなことです。
倍率より、出力が無料であることのほうが効く
System One モデルは段落ではなく型のある値を返すので、その出力は仕組みのうえで小さくなります。そこに課金しないのは、値引きというより、課金するものがほとんどないという告白です。意味のある数字は入力の価格のほうで、長い記録はそこに乗ります。
TechCrunch はこれをジェボンズの逆説で説明していますが、そのたとえは評価の場面によく当てはまります。判定が数えるまでもなく安くなると、現場は支出を減らしません。もっと多く、もっと多くの観点で、もっと頻繁に判定します。予算は、評価するかどうかを決めることから、集まった手がかりをどう扱うかを決めることへ移ります。
次の発表をどう確かめるか
数字を広める前に、一次の出典とその日付を探してください。誰が試験を行い、提供元とどんな関係にあるのかを確かめてください。方法を見てください。何回繰り返したのか、何を比べる相手にしたのか、どんな作業でなのか。そのうえで、試験の作業が自分の作業に似ているかを問うてください。天気の答えの採点は得意でも、ほかは何も試されていないということがありえます。
最後に、使えるかどうかを確かめてください。Jev は重みが公開されておらず、先行アクセスの順番待ちの向こうにあり、多くの人には Cloudflare の AI Gateway のような基盤を通して届きます。手を動かせない数字は、雑学です。
数字についての質問
Jev は本当に 40〜200 倍速いのですか?
それは、最先端の言語モデルとの分類の比較についての TypeSafe の数字です。社外で公開された唯一の計測は1回の呼び出しあたり平均 0.44 秒で、主張された 70〜500 ミリ秒の範囲の、遅いほうの端の近くに入ります。
1回の呼び出しはいくらですか?
TypeSafe は入力を100万トークンあたり $0.042 とし、出力は無料としています。LangChain の計測では1回あたり $0.00035 で、実行全体では $0.34 でした。同じ実行は Claude Sonnet 4.6 では $28.17 でした。
きちんとしたベンチマークは行われていますか?
まだです。保管庫と固定した版を公開した狭い実験が1件あるだけで、行ったのは、その2日後に提供元との生配信を主催した会社です。
続けて読む
Ciyo は、制作とエージェントの道具の背後にあるモデルについて書き、動かせるものは試しています。