モデル · System One
床のほうが、問いそのものより高くつきます
どのネットワーク呼び出しにも、処理が始まる前に支払う固定の代金があります。ふつうは無視できるほど小さいものです。ところがミリ秒単位で答えるモデルが相手だと、それは小さくなくなり、請求の大半を占めるようになります。
2026年9月20日 に公開された Jev の事前登録された独立評価は、その床を測り、そのうえで1回の呼び出しを満杯にしたときに何が起きるかを試しています。数字はある特定のシステムの形を支持しており、それは多くの人が最初に作る形ではありません。Ciyo は Jev を実行しません。画像も動画も生成しないからです。ですからこれは製品の案内ではなく、公開された測定値の読み解きです。
何が測られたのか
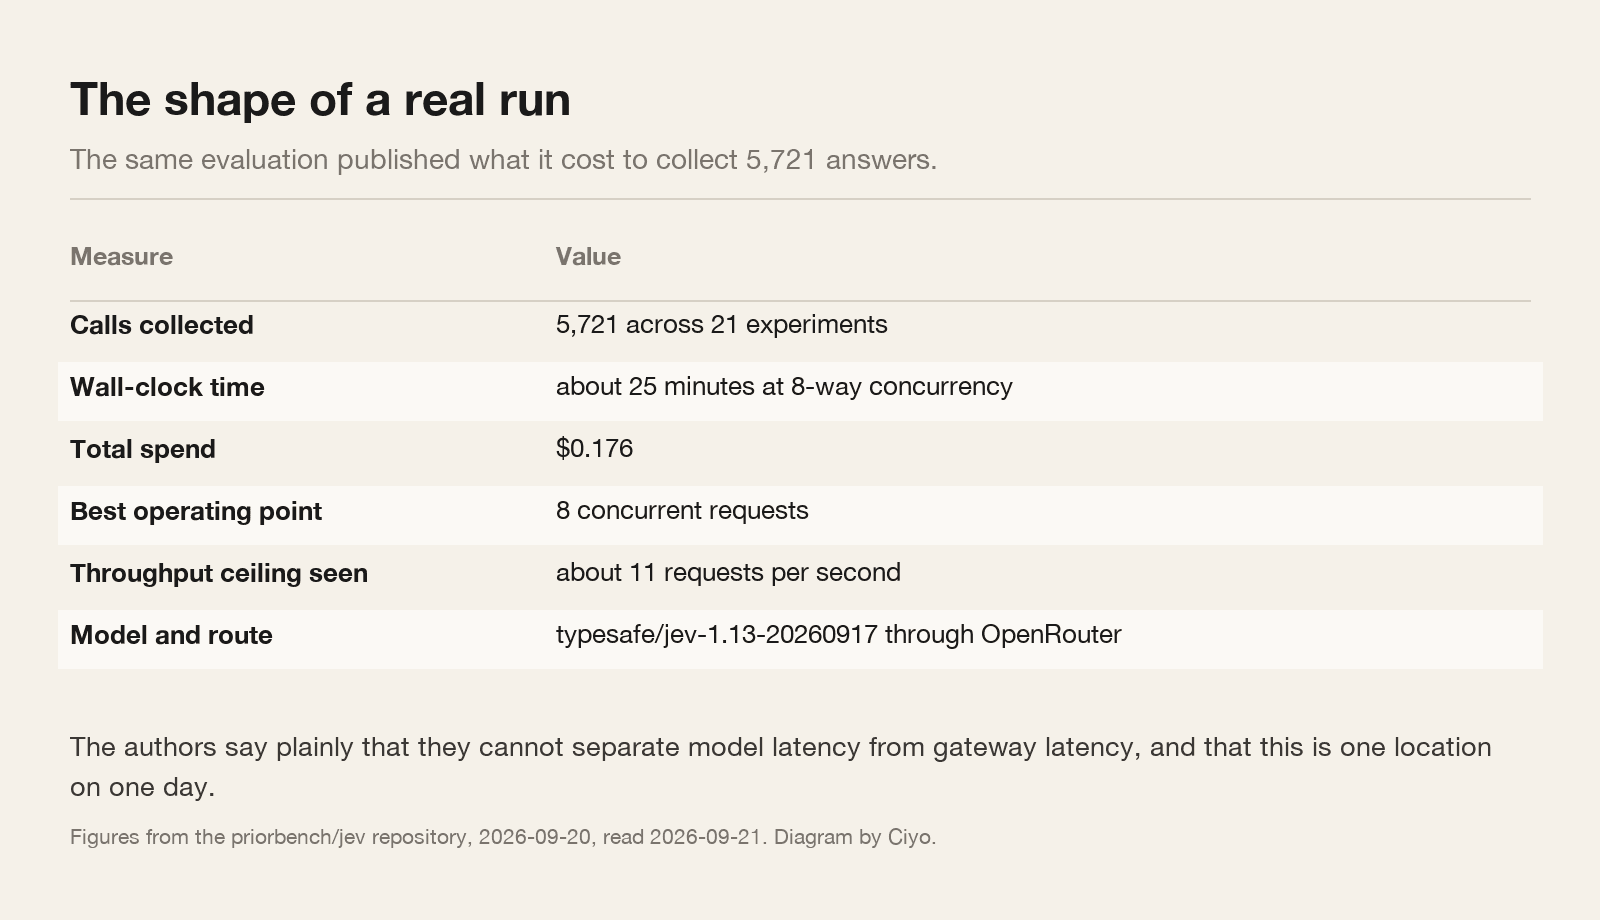
この評価は 21 の実験にわたる 5,721 回の呼び出しを集め、データ収集を始める前に時刻を打った 50 件の予測を伴っていました。実行は `typesafe/jev-1.13-20260917` を OpenRouter 経由で西ヨーロッパから行い、生データも公開されています。
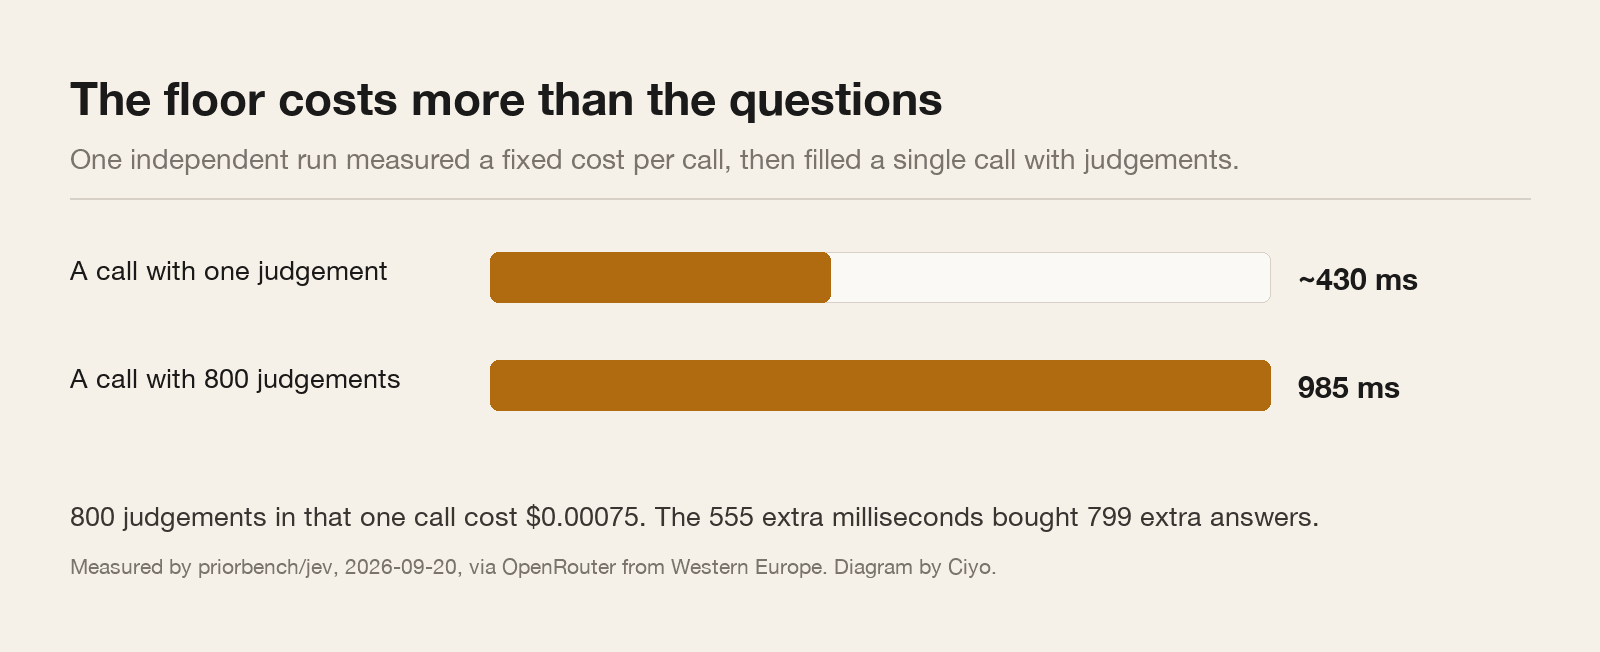
2つの発見が、ほかのすべてを動かします。呼び出しあたり約 430 ミリ秒の固定費があること。そして 800 件の型のついた判定を1回の呼び出しに詰めると、985 ミリ秒で完了し、費用は 0.00075 ドルだったことです。
この2つを並べると、計算は容赦ありません。最初の判定に約 430 ミリ秒かかります。残りの 799 件は合わせて約 555 ミリ秒、つまり1件あたり約 0.7 ミリ秒です。
ここで効いてくる、著者ら自身の断り書き
著者らは、モデルの遅延とゲートウェイの遅延を切り分けられないと明言しています。430 ミリ秒は測定値です。それがルートではなくモデルの性質だという主張のほうは仮説であり、著者らもそう書いています。ネイティブな API を使える人なら、すぐに決着をつけられるはずです。
この断り書きは、設計上の助言を弱めません。床が何でできていようと、呼び出しごとに一度は払うのですから、呼び出しを満杯にすることはどのみち効きます。ただし、他人の数字の上に遅延の見積もりを立てる前に、自分の地域で自分の床を測るべきだということでもあります。
またこれは、ある一日の、ある一か所での、あるモデルバージョンに対する測定です。仕様ではなく、物事のおおよその形として受け取ってください。
この数字が支持する形
state ひとつと質問ひとつを送り、返事を待ってから次を送る、というループは作らないでください。その設計は、ほとんどの時間を、床を何度も払い直すことに使います。
同じ測定から、良い形が2つ導けます。ひとつは質問を広げることです。答えが欲しくなるかもしれない質問を、たぶん捨てることになるものまで含めて、state を一度送るついでにまとめて送ってしまいます。追加の質問はほとんど無料だからです。もうひとつは state をまとめることです。その場のイベントに反応しているのではなく、たまった分を分類しているなら、1分間に多くの呼び出しを投げるのではなく、多くの項目を1回の呼び出しに入れてください。
2つ目の形には、遅延とは別の限界があります。800 件の判定を載せた呼び出しは、800 件分の state を載せることになりますし、答えをすべて元の行に戻せなければなりません。質問の識別子には意味のある名前を付け、対応関係をはっきり持っておいてください。
2026-09-21 の投稿です。メールの振り分けを設計している開発者が、3つの基本要素は並列に使えること、しきい値を付けた Score と Choice は同じタスクでも同じようには振る舞わないこと、そして公開されているパターンは、当て推量のものまで含めて多くの質問を1回の呼び出しで尋ねるほうを好むことを述べています。最後の点は、この記事が遅延のデータから辿り着いた結論と同じです。
並行実行と、それが効かなくなるところ
同じ実行は、呼び出しの中ではなく呼び出しどうしの並列性も見ています。同時リクエスト 8 が最も良い動作点であり、スループットは1秒あたり約 11 リクエストで頭打ちになりました。
これは小さな数字で、ファンアウトするワーカープールを設計する前に知っておく価値があります。同時実行が 8 を超えても、この実行はそれ以上の仕事をしませんでした。ただ待っているリクエストが増えるだけです。5,721 回の呼び出しは、その設定で約 25 分かかり、総額 0.176 ドルでした。
1秒あたり約 11 リクエストを超える処理が要るなら、これらの数字から導かれる答えは、ワーカーを増やすことではありません。呼び出しの数を減らし、一つひとつを満杯にすることです。
実際に書き出せる見積もり
これらの数字の形を取り出して、ベンチマークではなく実際の仕事量に当ててみます。エージェントの実行のすべての段階を評価したいとして、1日あたり 50,000 段階があり、段階ごとに質問が4つあるとしましょう。
段階ごとに1回呼ぶなら、呼び出しは 50,000 回、測定された床と同時実行数のもとで実時間およそ 6 時間、そして大量のスケジューリングが要ります。たとえば 200 段階ずつまとめて呼ぶなら、呼び出しは 250 回です。トークンの費用はどちらでも同じです。送っている state は同じだからです。崩れるのは、床を払うために使っていた時間のほうです。
設計上の教訓はこれに尽きます。この種のモデルでは、問うべきは「1回の呼び出しはどれだけ速いか」ではなく「1回にどれだけ詰められるか」です。
| 設計 | 1日あたりの呼び出し数 | 1日あたりに払う床 |
|---|---|---|
| 段階ごとに1回呼ぶ | 50,000 | 固定費でおよそ 6 時間 |
| 1回の呼び出しに 200 段階をまとめる | 250 | 固定費で 2 分未満 |
| どちらでもトークンは同じ | — | 払っているのは state の分 |
決めてしまう前に測るもの
自分の床を、自分の地域から、自分の経路で測ってください。スクリプト1本と 20 分の作業であり、見積もり全体がこの数字に乗ります。
1回の呼び出しの上限も測ってください。応答時間かエラー率が曲がり始めるまで判定の数を増やし、その手前に留めます。
対応関係も確かめてください。まとめた呼び出しが役に立つのは、すべての答えが正しい行に戻るときだけで、これは願うことではなく、試して確かめるべき種類のバグです。
そして自分の精度を測ってください。判定が間違っているなら、速さには何の意味もありません。速さはこの種のモデルを使う理由であり、自分のラベルとの一致は、使い続けてよい理由です。
スループットについての質問
1回の呼び出しに判定は何件入りますか
ドキュメントはリクエストあたりの質問数の上限を公開していません。ある独立した実行では 800 件を1回の呼び出しに収め、985 ミリ秒、0.00075 ドルで完了しています。
430 ms の床はモデルですか、ネットワークですか
分かりません。著者らは床を測ったうえで、自分たちの経路ではモデルの遅延とゲートウェイの遅延を切り分けられないと明記しています。
同時に何件まで走らせられますか
その実行では、同時リクエスト 8 が最も良い動作点で、スループットは1秒あたり約 11 で頭打ちになりました。ワーカープールの規模を決める前に、自分の数字を測ってください。
まとめるとトークンの費用は変わりますか
いいえ。送った state の分を払います。まとめることで崩れるのは呼び出しごとの固定費であって、トークンではありません。
続きを読む
Ciyo は、クリエイティブツールやエージェントツールの背後にあるモデルについて書き、実行できるものは実際に試しています。