モデル · System One
Jev の信頼度スコアでルーティングして良いか
回答を返す意思決定モデルは役に立ちます。回答に加えて、どれだけ確信しているかを示す信頼できる数値まで返すモデルなら、いつ手を止めて人間に尋ねるかを自分で知っているシステムに組み込めます。
それが較正された信頼度という考え方の約束であり、同時にいちばん検証すべき主張でもあります。現実を追いかけない信頼度は、信頼度がないことよりたちが悪いからです。それはあなたのコードに、進んでよいと告げてしまいます。2 件の独立評価が 2026年9月17日 の週にデータを公開しており、この二つを合わせて読むと、どのベンダーのページよりもうまくこの問いに答えられます。Ciyo は Jev を実行しません。これは公開された証拠の読み解きです。
信頼度は確率ではありません
Choice の回答は二つの異なる数値を伴って返ってきます。この二つを取り違えるのが、最初の間違いです。確率は、あなたが宣言した選択肢全体にわたる分布、つまりモデルの確信がどう散らばっているかを表します。信頼度は、回答そのものについてモデルがどれだけ確信しているかを表す、別のひとつの値です。
TypeSafe 自身のドキュメントも、これを第二の軸として位置づけています。回答が「何を」を教え、信頼度が「そのまま進んでよいか」を教えます。この位置づけこそ、記事を一本割く価値のある理由です。回答が分岐を選び、信頼度が人間に先に見せるかどうかを選ぶ、そういうシステムを組めます。
公開されたパターンは、しきい値を被害の大きさに結びつけます
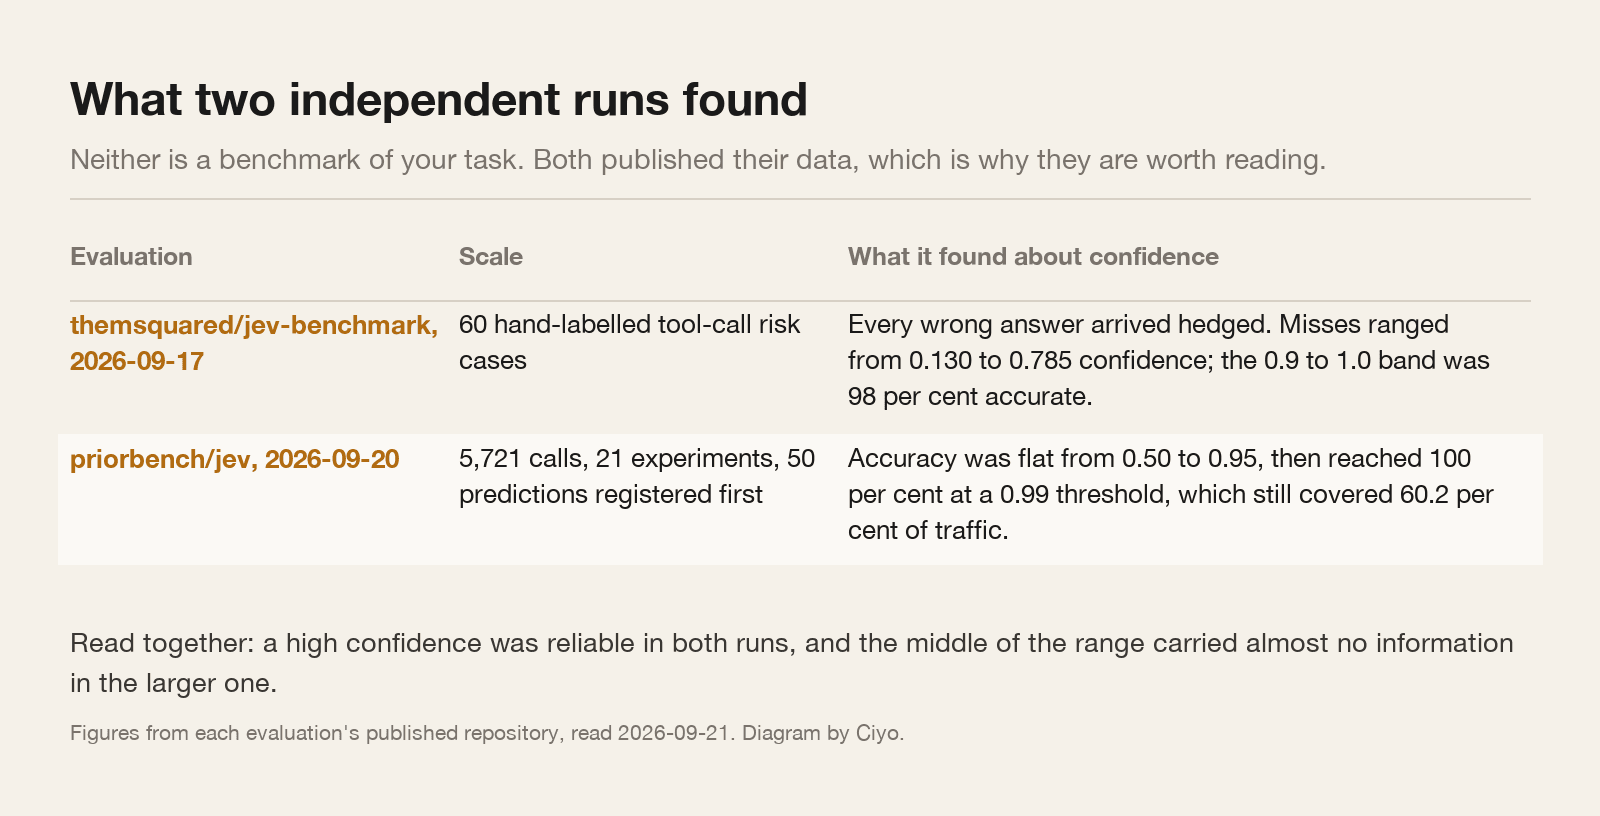
TypeSafe は信頼度によるルーティングのパターンを公開しています。優れているのは、ひとつの数字を示さない点です。間違いの重さに結びついた段階を示します。
0.6 未満なら人間に回します。0.6 以上なら実行します。ただしその行動が安い場合に限ります。高くつく行動や取り返しのつかない行動なら、0.6 から 0.85 のあいだは利用者に確認させ、0.85 以上のときだけ自動で実行します。示されている例では、口座残高の表示は 0.6 で通り、送金の承認は 0.85 に届くまで通りません。
これは、ひとつの共通しきい値を置くより良い出発点です。行動にいくらかかるのかを、こちらに書き出させるからです。多くのチームはこれをやってみて、ひとつの分岐でまるで重さの違う行動をいくつも走らせていたことに気づきます。
2 件の独立評価が測ったもの
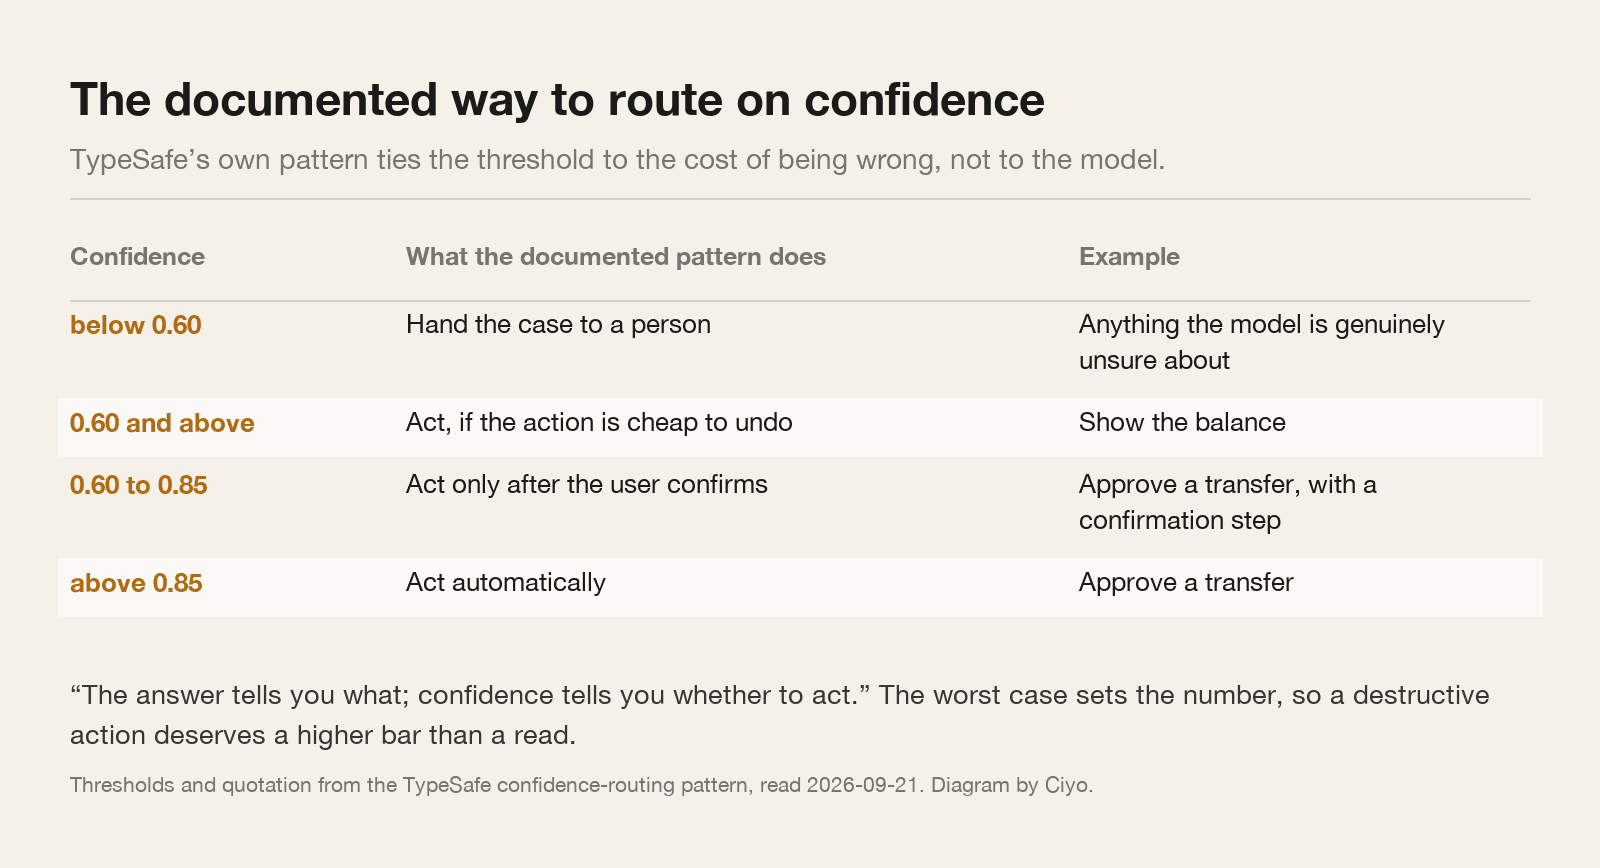
ひとつ目は小規模で、的を絞ったものです。2026年9月17日、再現可能なベンチマークが、手でラベルを付けた 60 件のエージェントのツール呼び出しを 4 つのリスク区分に分類し、明確な場合・曖昧な場合・敵対的な場合に分けました。全体の正解率は 91.7 パーセント、明確な場合は 100 パーセント、曖昧な場合は 71.4 パーセントです。ここで重要な発見は、誤った回答がすべて低めの確信とともに返ってきたことでした。取りこぼしの信頼度は 0.130 から 0.785 のあいだに収まり、モデルが間違っているときに最大の信頼度を返すことはなく、0.9-1.0 の帯は 98 パーセント正確でした。
ふたつ目は大規模で、事前登録済みです。2026年9月20日 に公開されたこの評価は、21 の実験にわたる 5,721 回の呼び出しを対象とし、データを集める前に時刻を打った 50 件の予測を伴っていました。そのうち 26 件が裏づけられ、21 件が否定されました。否定のうち 18 件は、著者が失敗を見込んでいたのに、その失敗が現れなかったためです。較正については、正解率が 0.50 から 0.95 のあいだでほぼ平坦であり、そのうえで 0.99 のしきい値では 100 パーセントに達し、なお 60.2 パーセントのトラフィックを覆っていました。
併せて読むと、「信頼度は使える」よりもずっと精確なことが言えます。高い信頼度はどちらの評価でも信頼できました。一方で、範囲の真ん中は、規模の大きいほうではほとんど情報を持っていませんでした。
それがあなたのしきい値にとって意味すること
正解率が 0.5 から 0.95 で平坦なら、そのタスクでは 0.7 のしきい値も 0.9 のしきい値もほぼ同じものしか買いません。0.9 にして増えた差し戻しは、たいてい人間の時間を無駄にしているだけです。
面白いのは上の端です。0.99 のゲートで、正解率を落とさずにトラフィックの 60 パーセントを自動処理できるというのは、実務として本当に使える動作点です。仕事の 5 分の 3 がそのまま流れ、残りが人間に届きます。これは「下位 5 パーセントを人間に回す」のとは、まったく別のシステム設計です。
ただし、これはある日のあるタスクの話であって、あなたのタスクの話ではありません。判断の根拠にしてよい数値は、あなた自身のラベル付きデータで測ったものだけです。
| 分かったこと | 支持できること | 支持できないこと |
|---|---|---|
| 誤った回答はすべて確信が低かった、n = 60 | そのタスクでは最大信頼度の回答を安全とみなすこと | あなたのタスクで自信満々に外すことは決してないという保証 |
| 0.50 から 0.95 で正解率が平坦 | 中間帯のしきい値はほとんど効かないと疑うこと | 信頼度は 0.99 未満では役に立たないという主張 |
| 0.99 で 100 パーセント、60.2 パーセントを被覆 | ゲートを高く保ったまま被覆率も高く保つ運用を設計すること | 別のタスクや別の分布でも同じ被覆率になること |
自分の曲線を、午後のうちに測る
ラベルを付けたデータが要ります。持っていないなら、どのみち必要だったと気づくのは今このときです。すでにあなたが判断を下した 200 行があれば、十分に面白い結果が出ます。
各行を送り、回答と信頼度を残します。そのうえで信頼度でバケツに分け、バケツごとの正解率を計算してください。その表が、あなたの較正曲線です。その行動のコストに見合う精度が出ている最も低いしきい値を選び、それより下はすべて人間に回してください。
そして質問の文言を変えたら、測り直してください。モデルに与えた仕事が変わったのですから、先ほど測った曲線は古いほうの仕事のものです。
2026-09-21 に投稿され、予測システムを手がける Yarrow の投稿を引用しています。投稿者による較正の定義、つまりモデルが 70 パーセントと言ったなら、その出来事は 70 パーセントの割合で起きるべきだ、というのは標準的なもので、較正曲線を測る価値がある理由そのものです。商用の文脈には留意してください。引用されているアカウントは予測の製品を売っており、自社との重なりを示そうとしています。
この設計が招く失敗
安くて再現できる判定役は、人の振る舞いを変えます。ひとつの判断が 1 セントの端数で済むなら、チームは抽出をやめて全部を評価し始めます。それこそがこの仕組みの狙いです。
同時にそれは、決まった方向に間違える判定役が、これからはどこでも、静かに、最大の信頼度で、すべての行に対して間違え続けるということでもあります。ばらつきが小さいことは、良くなる前にいったん事態を悪くします。繰り返せる間違いは、そのとおり正確に繰り返されるからです。
対策は地味なものです。人がラベルを付けた基準データを持ち続け、質問を変えるたびに一致率を測り直し、判定役が弾いたものだけでなく、通したもののほうも抜き取って読んでください。
信頼度についての質問
信頼度は最大の確率と同じものですか
いいえ。確率は、宣言した選択肢全体にわたる散らばりを表します。信頼度は、モデルがそもそもどれだけ確信しているかという別の値で、公開されているルーティングパターンが使うのはこちらです。
どのしきい値を使えばよいですか
公開されたパターンは、それを行動のコストに結びつけています。0.6 未満は人間へ、0.6 は安い行動に、0.6 から 0.85 は高くつくものなら利用者の確認を挟み、0.85 以上は自動です。そのうえで、自分の曲線を測ってください。
自信満々に間違えた例を見つけた人はいますか
60 件のベンチマークにはありません。そこでは取りこぼしがすべて低い確信で返っており、モデルが最大の信頼度で間違えたことはありませんでした。ある実務者が、判定できない場合に自信のある誤りが出たと報告していますが、データは公開されていません。
Ciyo は信頼度ルーティングを使っていますか
Jev では使っていません。Ciyo は Jev を実行しないからです。ただしこのパターン自体、つまり型のついた判定と、人間に見せるかを決めるしきい値の組み合わせは、レビュー役として働く言語モデルを含め、どの判定役にも当てはまります。
続きを読む
Ciyo は、クリエイティブツールやエージェントツールの背後にあるモデルについて書き、実行できるものは実際に試しています。