モデル · System One
あなたが宣言した選択肢が、モデルのすべてです
言語モデルなら、まずい指示はまずい文章を生み、あなたはそれを目で見て取れます。型のついた意思決定モデルでは、まずい質問は、正しい型の、完璧に整った答えを生みます。そして、おかしいところは何も見えません。
これは、何かに組み込む前に理解しておく価値のある罠です。2026年9月17日 の週に出た2つの証拠、ひとつは事前登録された評価、もうひとつは実務者の実行が、別々の方向から同じ結論を指しています。得られる精度は、質問の書き方そのものの性質だということです。Ciyo は Jev を実行しません。画像も動画も生成せず、どちらのモデルレジストリにも載っていません。
1つの質問か、5つか
今週公開されたもっとも直接的な証拠は、フィッシングの振り分けを実際に走らせた実務者からのものでした。1つの質問として尋ねたとき、このタスクの正解率は 62.6 パーセントでした。5つの別々の質問に分け、同じ state に対して評価し、結果をコードで組み合わせると 95 パーセントになりました。
これは公開データセットのない、本人のラベルによる一度の実行ですから、引用すべき数字というより、分割を試してみる理由と受け取ってください。ただしこれは、提供元自身のドキュメントが勧めている内容、つまり多要素の判定を1つにまとめて聞かず、単一の目的を持つ原子的な質問に分けるという助言と一致します。API の形とも一致しています。API では、1回の呼び出しに含まれる各質問が、同じ state に対して並列に評価されます。
料金の構造のおかげで、この助言は守りやすくなっています。1回の呼び出しで費用の大半を占めるのは、質問への回答ではなく state の送信です。state がいったん回線に乗ってしまえば、5つ尋ねる分の追加はほとんど無視できます。
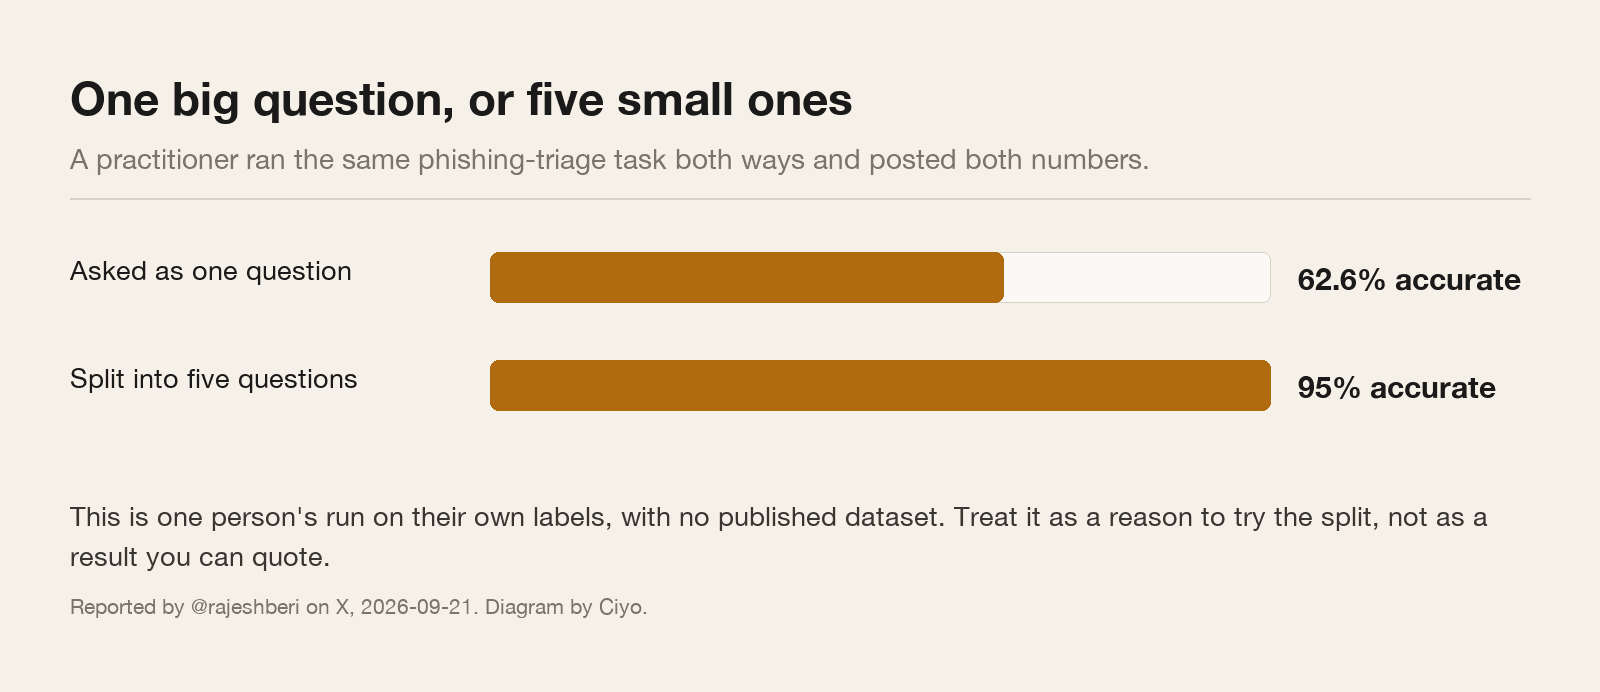
2026-09-21 の投稿です。投稿者は自身のフィッシング振り分けの実行から両方の数字を報告し、答えが本当に知りえない場合には確率が自信のあるまま外れていたと付け加え、まず自分のラベルで影運用してみるという妥当な助言で締めくくっています。データセットは公開されていないため、この数字は投稿者自身のものです。
分けにくい質問を、どう分けるか
「このメールはフィッシングですか」は結論であって、質問ではありません。分割とは、その結論を支える証拠について一度にひとつずつ尋ね、結論そのものはあなたのコードに任せることです。
送信者のドメインは、メッセージが名乗っている組織と一致しているか。メッセージは認証情報か支払いを求めているか。文面に時間的な圧力はあるか。表示されているリンクの文字列は、実際の宛先と一致しているか。この送信者がふだん名前を使う場面で、挨拶が当たり障りのないものになっていないか。
5つの狭い質問、それぞれに固有の信頼度を持つ5つの答え、そして指示文に触れることなく読み、試し、変えられる、あなたのコードの中のルール。この最後の部分こそ本当の収穫です。組み合わせの論理が、ふつうのソフトウェアになります。
questions: {
  "sender_mismatch": { "type": "noul", "instructions": "送信者のドメインが、メッセージの名乗る組織と一致しない。" },
  "asks_for_secret": { "type": "noul", "instructions": "メッセージが読者にパスワード、コード、または支払いを求めている。" },
  "time_pressure":   { "type": "noul", "instructions": "メッセージが読者に急いで行動するよう迫っている。" },
  "link_mismatch":   { "type": "noul", "instructions": "表示されているリンク文字列が、リンクの実際の宛先と異なる。" },
  "risk":            { "type": "score", "instructions": "このメッセージを受信箱に届けることは、どれだけ危険か。",
                        "criteria": ["無害", "疑わしい", "おそらくフィッシング", "明らかに悪意がある"] }
}
選択肢の名前はラベルであり、定義は基準のほうです
Choice は選択肢名から説明への `criteria` マップを取り、Score はレベルの説明を順に並べた配列を取ります。これらの文字列は、同僚に向けた覚え書きではありません。モデルが持っている唯一の定義です。
「billing(請求)」と書いても、ほとんど何も伝わりません。「送信者が、身に覚えのない請求、見覚えのない料金、返金、あるいは支払い方法の変更について問い合わせている」と書けば、何を探せばよいかが伝わります。後者の書き方には、何も自動化しないうちに同僚と議論できるという利点もあります。意見の食い違いがいちばん安く済むのは、その段階です。
基準は、初日の新しい担当者に渡す指示のつもりで書いてください。何がここに入るのか、似ているけれど別の場所に入るものは何か、そしてどちらでもないときはどうするのか。
モデルが返せない答え
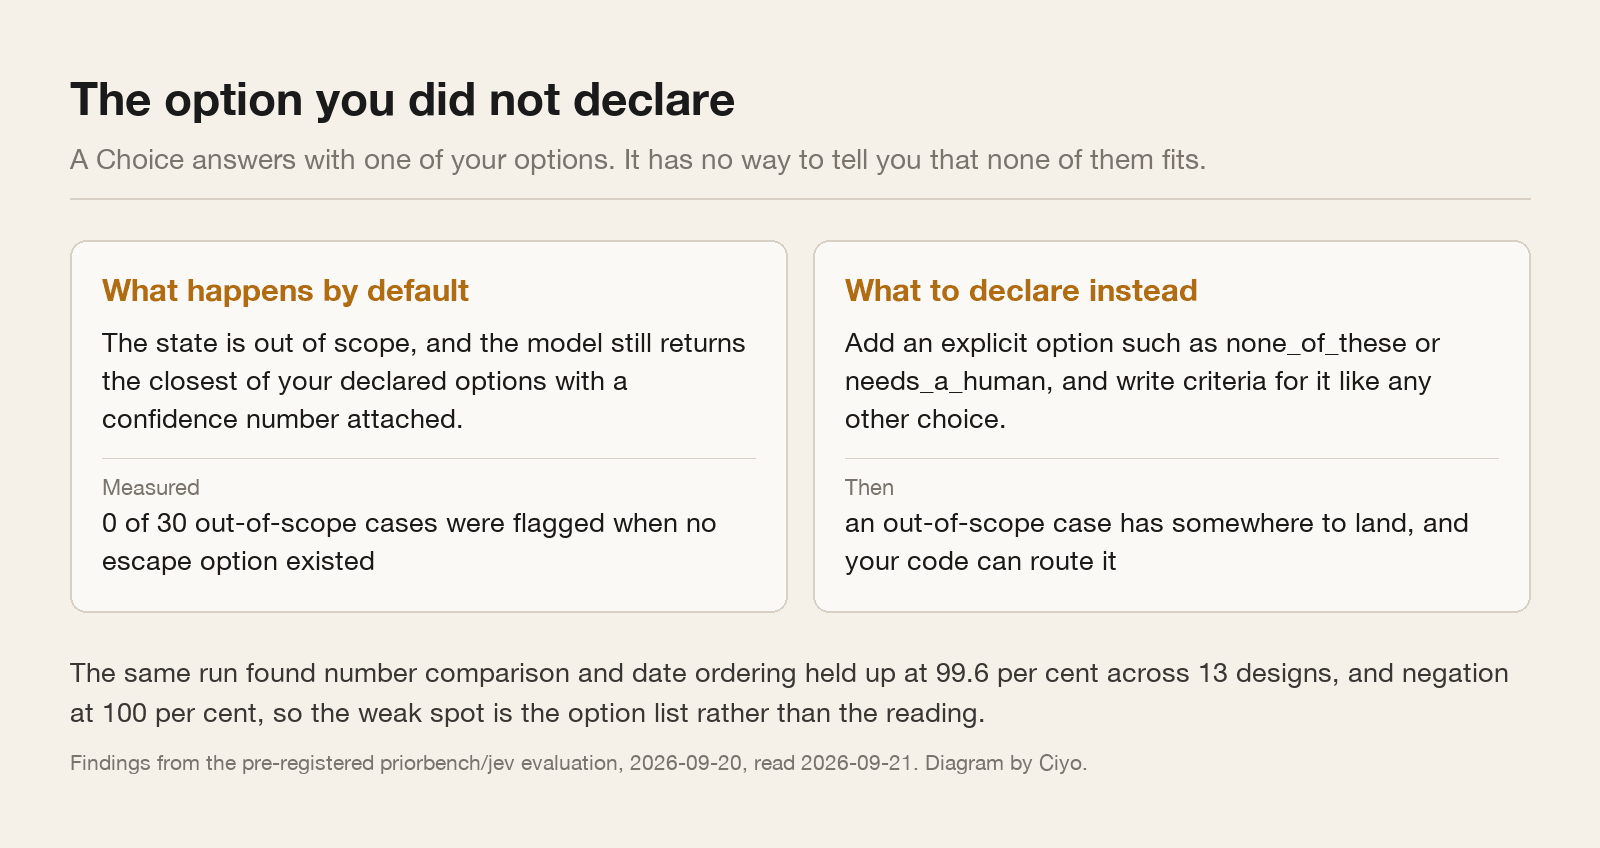
ここからが、設計を変えるほうの鋭い発見です。2026年9月20日 に公開された事前登録評価で、著者らは、state が宣言された選択肢の外に出たことをモデルが知らせるかどうかを調べました。抜け道の選択肢を用意しなかった 30 件の範囲外ケースのうち、知らせは1件もありませんでした。
これは欠陥ではありません。型システムが宣伝どおりに動いているということです。取りうる答えをあなたが宣言し、宣言された型の値が返ってきた、それだけのことです。ただしそれは、範囲外の入力が大きな音を立てて失敗しないことを意味します。最も近い選択肢と、それに付いた信頼度とともに、静かに成功してしまいます。
直し方は、質問設計の一行です。抜け道の選択肢を自分で宣言してください。`none_of_these`、`needs_a_human`、`not_applicable` といったものです。そして本物の選択肢と同じだけ丁寧に、その基準も書いてください。あとはコードで振り分けます。
同じ評価が、得意だと確かめたこと
もう半分も伝える価値があります。この種のモデルについての通説は、安心させる方向にも、不安にさせる方向にも、しばしば外れているからです。
同じ実行では、数値の比較と日付の順序が 13 種類の異なる質問設計を通じて 99.6 パーセントで保たれ、否定はテストされたケースの 100 パーセントで正しく扱われました。3 日前に公開された実務者向けのガイドは、否定が誤動作しうること、そしてモデルが計算と日付に弱いことを警告していました。より大規模な事前登録の実行は、それを再現しませんでした。
これは 2026年9月 のこの話題全体について、よい戒めになります。公開から一週間も経っていないモデルについて、自信に満ちた助言が数多く出回っています。手法とリポジトリの付いた証拠のほうを選んでください。
| 主張 | 出典 | 事前登録の実行で分かったこと |
|---|---|---|
| 計算と日付の扱いが苦手 | 実務者向けガイド、2026-09-17 | 数値比較と日付順序は 13 の設計を通じて 99.6 パーセントで保たれた |
| 否定が誤動作することがある | 同じガイド | 否定はテストされたケースの 100 パーセントで正しく扱われた |
| 文脈の劣化。無関係な state が混ざると精度が落ちる | 同じガイド | ここでは否定されていない。自分の state で試す価値がある |
| 指示を文字どおりに読む | 同じガイド | 範囲外の発見と整合する。書いたとおりの質問に答える |
質問を本番に出す前の確認
その質問は原子的ですか。文の中に「および」や「〜でない限り」が入っていれば、おそらく2つの質問です。
選択肢は、抜け道も含めて網羅されていますか。ありそうな入力に行き先がなければ、それはどこか間違った場所に落ちます。
選択肢ごとに基準がありますか。選択肢の名前はラベルにすぎず、定義は基準のほうで、モデルが持っているのはあなたが書いたものだけです。
評価軸は順に並んでいますか。Score は、続けて読んで意味の通る 2 から 10 段階を想定しており、返るスコアはその途中にも落ちます。
自分のラベルで測りましたか。この記事の数字はすべて、他人のタスクから出たものです。
質問設計についての質問
なぜ質問を分けたほうが良いのですか
各質問は同じ state に対して独立に評価されるので、狭い質問は狭いタスクになります。そして組み合わせの論理はあなたのコードに置かれ、そこで試せるようになります。ある実務者の実行では、分割後に自分のラベルで 62.6 から 95 パーセントへ上がりました。
質問を増やすと費用も増えますか
ごくわずかです。費用の大半を占めるのは送信する state で、質問はそれに対して並列に評価されます。
どの選択肢にも当てはまらない入力はどうなりますか
それでも最も近い選択肢が返ってきます。事前登録された評価では、抜け道の選択肢を宣言していなかったとき、範囲外の 30 ケースのうち 0 件しか知らせられませんでした。ひとつ宣言しておいてください。
日付と否定が苦手なのですか
実務者向けガイドは 2026年9月17日 にそう述べていました。その 3 日後に行われた、より大規模な事前登録の実行では、数値と日付の順序で 99.6 パーセント、否定で 100 パーセントが測られています。どちらを信じるにせよ、自分のデータで試してください。
続きを読む
Ciyo は、クリエイティブツールやエージェントツールの背後にあるモデルについて書き、実行できるものは実際に試しています。