AI 模型 · 數字
檢驗 Jev 的價格與速度說法
每一次發表都會帶著一個倍數登場,而 Jev 的倍數很大:「在同等的前沿智慧水準下」快 40 到 200 倍、輸入每百萬 token $0.042,以及輸出 token「FREE (too cheap to meter)」(免費,便宜到不值得計費)。
五天之後,公司之外只有一份量測。這篇文章把兩者並排放在一起,而兩邊的結果,都不是一則發表推文會讓你預期的樣子。
TypeSafe 公布了什麼
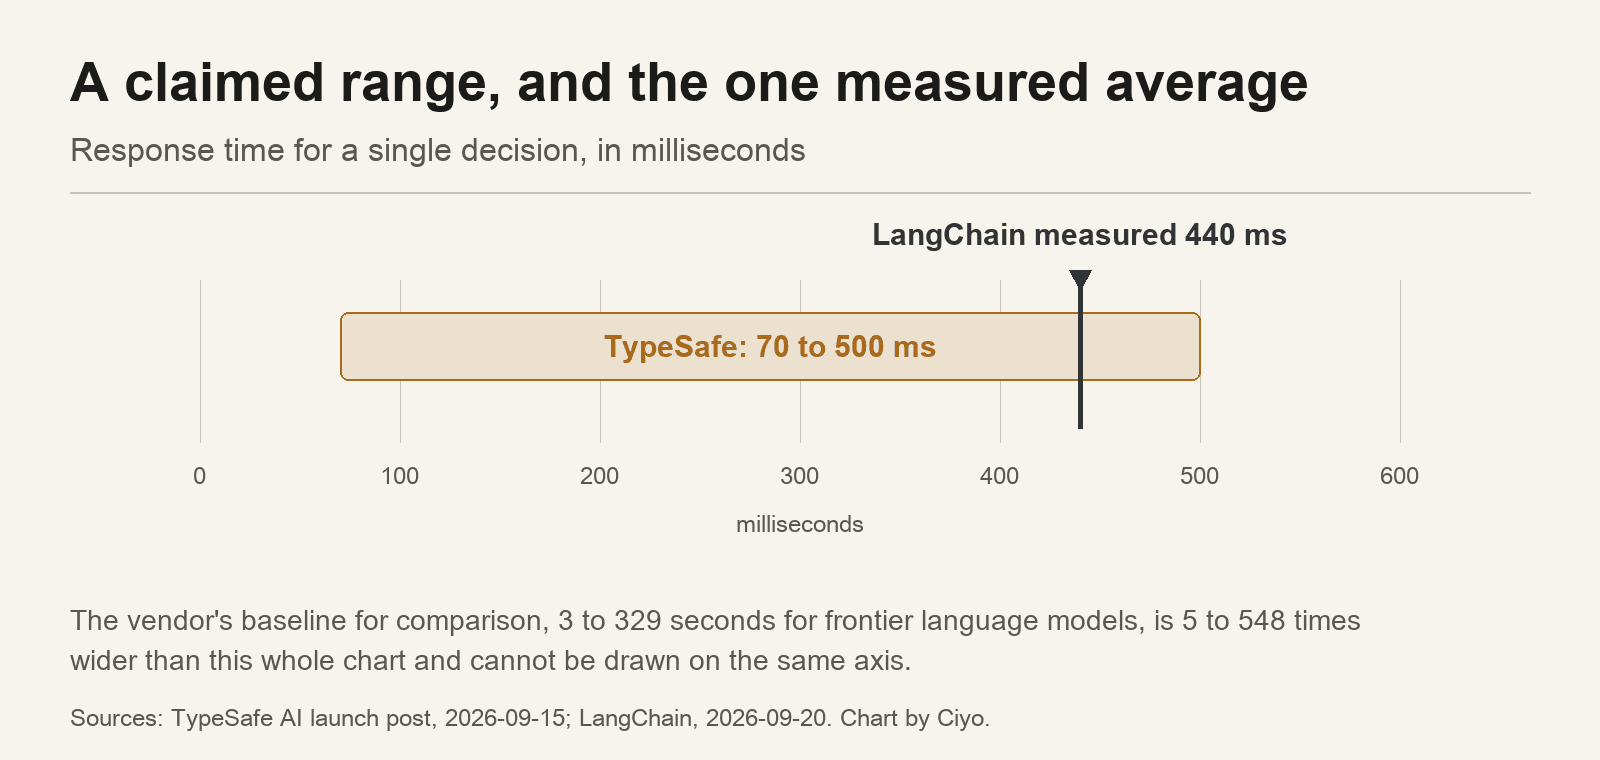
2026 年 9 月 15 日的發表文章給出的延遲區間是 70 到 500 毫秒,對比前沿語言模型的 3 到 329 秒,快 40 到 200 倍的說法就是這樣來的。文章還加上:在正式工作流程上快 193.6 倍、便宜 444.6 倍,以及零幻覺、零型別錯誤。
價格特殊到值得講兩次:輸入是以十億為單位計價而不是百萬,而輸出免費。TechCrunch 在 9 月 18 日的報導中,同時列出了客戶端的數字——Vercel 量到快 5 到 18 倍,另一個團隊則是比 Gemini 便宜 10 到 20 倍。
上面每一個數字,都來自 TypeSafe 或它的早期使用者。這不代表其中任何一個是錯的,但確實代表它們全都未經查證。
| 說法 | 數字 | 來源 | 是否獨立? |
|---|---|---|---|
| 延遲 | 70 到 500 毫秒,對比 3 到 329 秒 | TypeSafe 發表文章 | 否 |
| 正式工作流程的速度 | 快 193.6 倍 | TypeSafe 發表文章 | 否 |
| 正式工作流程的成本 | 便宜 444.6 倍 | TypeSafe 發表文章 | 否 |
| 可靠度 | 零幻覺、零型別錯誤 | TypeSafe 發表文章 | 否 |
| 價格 | 每百萬輸入 token $0.042,輸出免費 | TypeSafe 價格頁 | 屬於公告,不是量測 |
| 客戶量到的速度 | 快 5 到 18 倍 | Vercel,經 TechCrunch 轉述 | 否,由客戶自行回報 |
一個宣稱的區間,和唯一一個量到的平均值
LangChain 在 9 月 20 日的實驗回報每次呼叫平均 0.44 秒。把它放到和發表文章同一條軸上,它落在區間之內,靠近慢的那一端:440 毫秒對上宣稱的 70 到 500。
兩件事同時成立,而這正是有用的觀察。供應商的區間沒有被推翻,但那個頭條倍數也沒有被重現,因為倍數是一個比值,真正決定它的是基準。對上一個要花三秒的前沿模型,440 毫秒大約是快七倍,不是兩百倍。
同一次執行花了多少
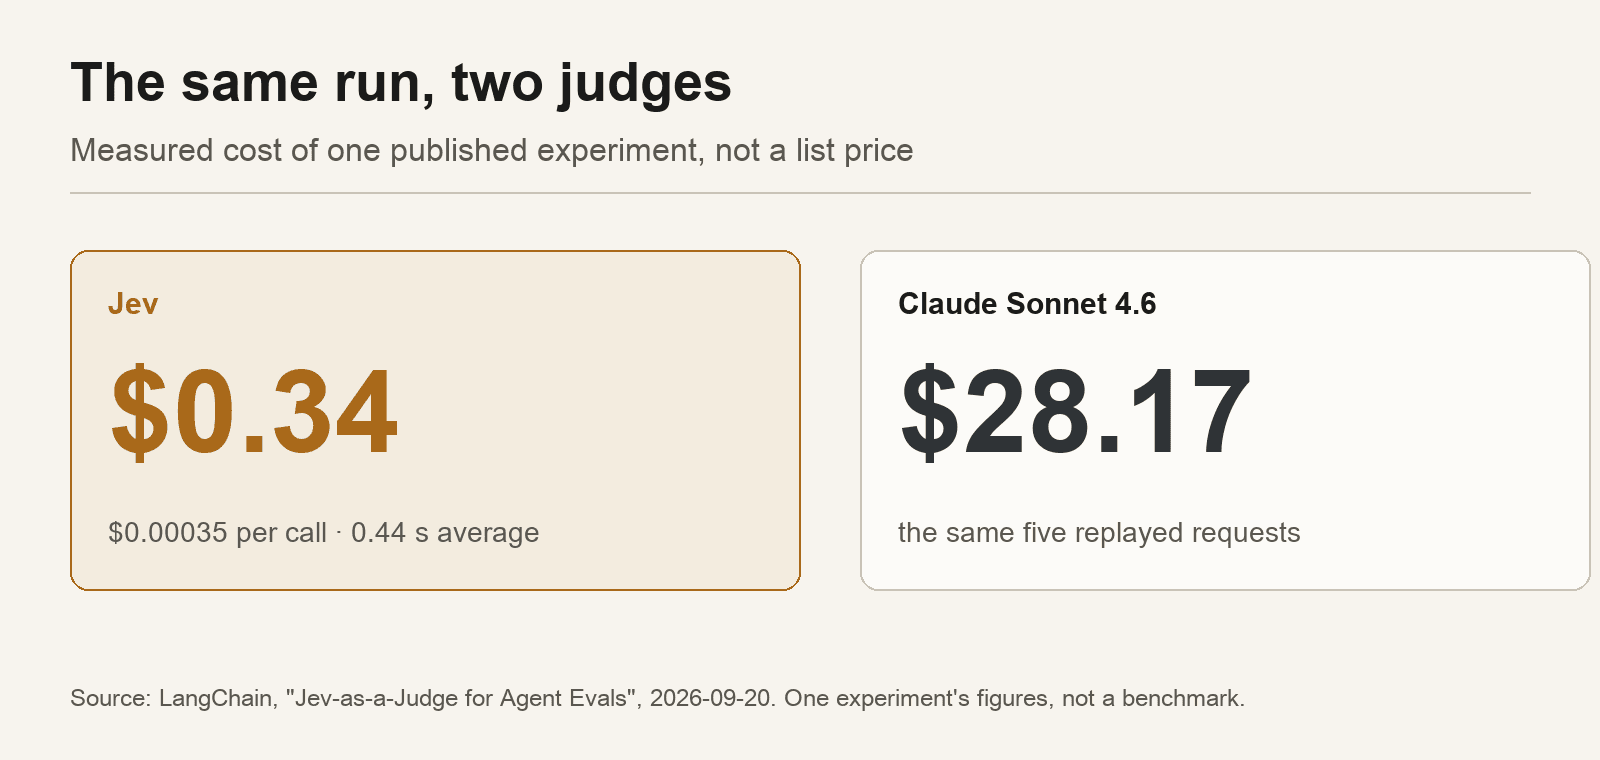
成本的比較比較沒有模糊空間。在 LangChain 的實驗中,一次 Jev 判定花費 $0.00035,整輪重複判定合計 $0.34。同一輪改用 Claude Sonnet 4.6 則是 $28.17,差距大約 83 倍。
八十三不是四百四十四。但它也已經足以改變一個團隊的做法:當一輪評估只要三分之一美元,你就不必在覆蓋率和預算之間二選一,可以把評審跑在每一筆追蹤紀錄上,而不是只跑抽樣。
由 Daniel Shea 和 Seán Roche 於 2026-09-20 發表,附有公開的程式碼倉庫和釘住的版本。LangChain 在兩天後和 TypeSafe 一起辦了直播。
把保留事項和數字一起讀
LangChain 自己把限制寫了下來,這是一份值得讀的測試的標記。這項實驗建立在五個天氣請求上,透過一個代理程式重播。變異的結果被描述為觀察性的,而不是訓練目標造成的證據。他們也警告低成本會放大錯誤,因為一個持續判斷錯誤的評估器,會以規模產生糟糕的回饋。
他們還釘住了版本並公開程式碼倉庫,所以這次執行可以被重跑。那就是基準測試和吹噓之間的差別,而在一次發表的五天之後,這種做法比應該有的還要稀少。
為什麼免費的輸出 token 比那個倍數更重要
System One 模型回傳的是有型別的值,不是一整段文字,所以它的輸出從架構上就很小。不對它收費與其說是折扣,不如說是承認幾乎沒有東西可以收。真正有意義的數字是輸入價格,因為一份長長的追蹤紀錄就落在那裡。
TechCrunch 搬出傑文斯悖論(Jevons paradox)來形容接下來會發生的事,而這個類比正好貼合評估這件事:當一次判定便宜到不值得計算,團隊不會少花錢,而是判定得更多、面向更多、更頻繁。預算從「要不要評估」轉移到「這麼多回饋要怎麼處理」。
下一次發表該怎麼查證
在轉述一個數字之前,先找到原始來源和它的日期。問是誰做的測試,以及他們和供應商是什麼關係。找出方法:重複了幾次、對照哪個基準、在什麼任務上。接著問測試裡的任務,像不像你真正在跑的任務,因為一個模型可以很擅長為天氣答案評分,卻在其他所有事情上都未經測試。
最後,查可取用性。Jev 沒有公開權重,躲在早期使用候補名單後面,而且多半是透過 Cloudflare AI Gateway 這類基礎設施抵達使用者手上。一個你無法據以行動的數字,只是冷知識。
關於這些數字的問題
Jev 真的快 40 到 200 倍嗎?
那是 TypeSafe 針對分類任務、對比前沿語言模型給出的數字。公司之外唯一公開的量測是每次呼叫平均 0.44 秒,落在宣稱的 70 到 500 毫秒區間之內,靠近慢的那一端。
一次呼叫要多少錢?
TypeSafe 列出每百萬輸入 token $0.042,輸出免費。LangChain 量到每次呼叫 $0.00035,整輪執行 $0.34,而同一輪用 Claude Sonnet 4.6 要 $28.17。
有人好好做過基準測試嗎?
還沒有。目前只有一項窄幅實驗,附有公開的程式碼倉庫和釘住的版本,而執行它的公司在兩天後和供應商一起辦了直播。
繼續閱讀
Ciyo 書寫創意與代理工具背後的模型,並實測那些自己跑得動的。