AI 模型 · 深入解說
System One 模型:Jev 實際上在做什麼
TypeSafe AI 在 2026 年 9 月 15 日發表 Jev,並稱它是一個新類別的第一個成員:System One 模型,「一個全新的前沿模型類別,專門用來做出軟體可以直接使用的快速結構化決策」。
最容易誤讀這句話的方式,是把它聽成「比較小的語言模型」。Jev 不是語言模型。它不生成文字,寫不出你的文案,也永遠不會回答開放式問題。它是刻意放棄字串生成的,而它所有有趣的地方都源自這個取捨。
一個新類別,以及它放棄了什麼
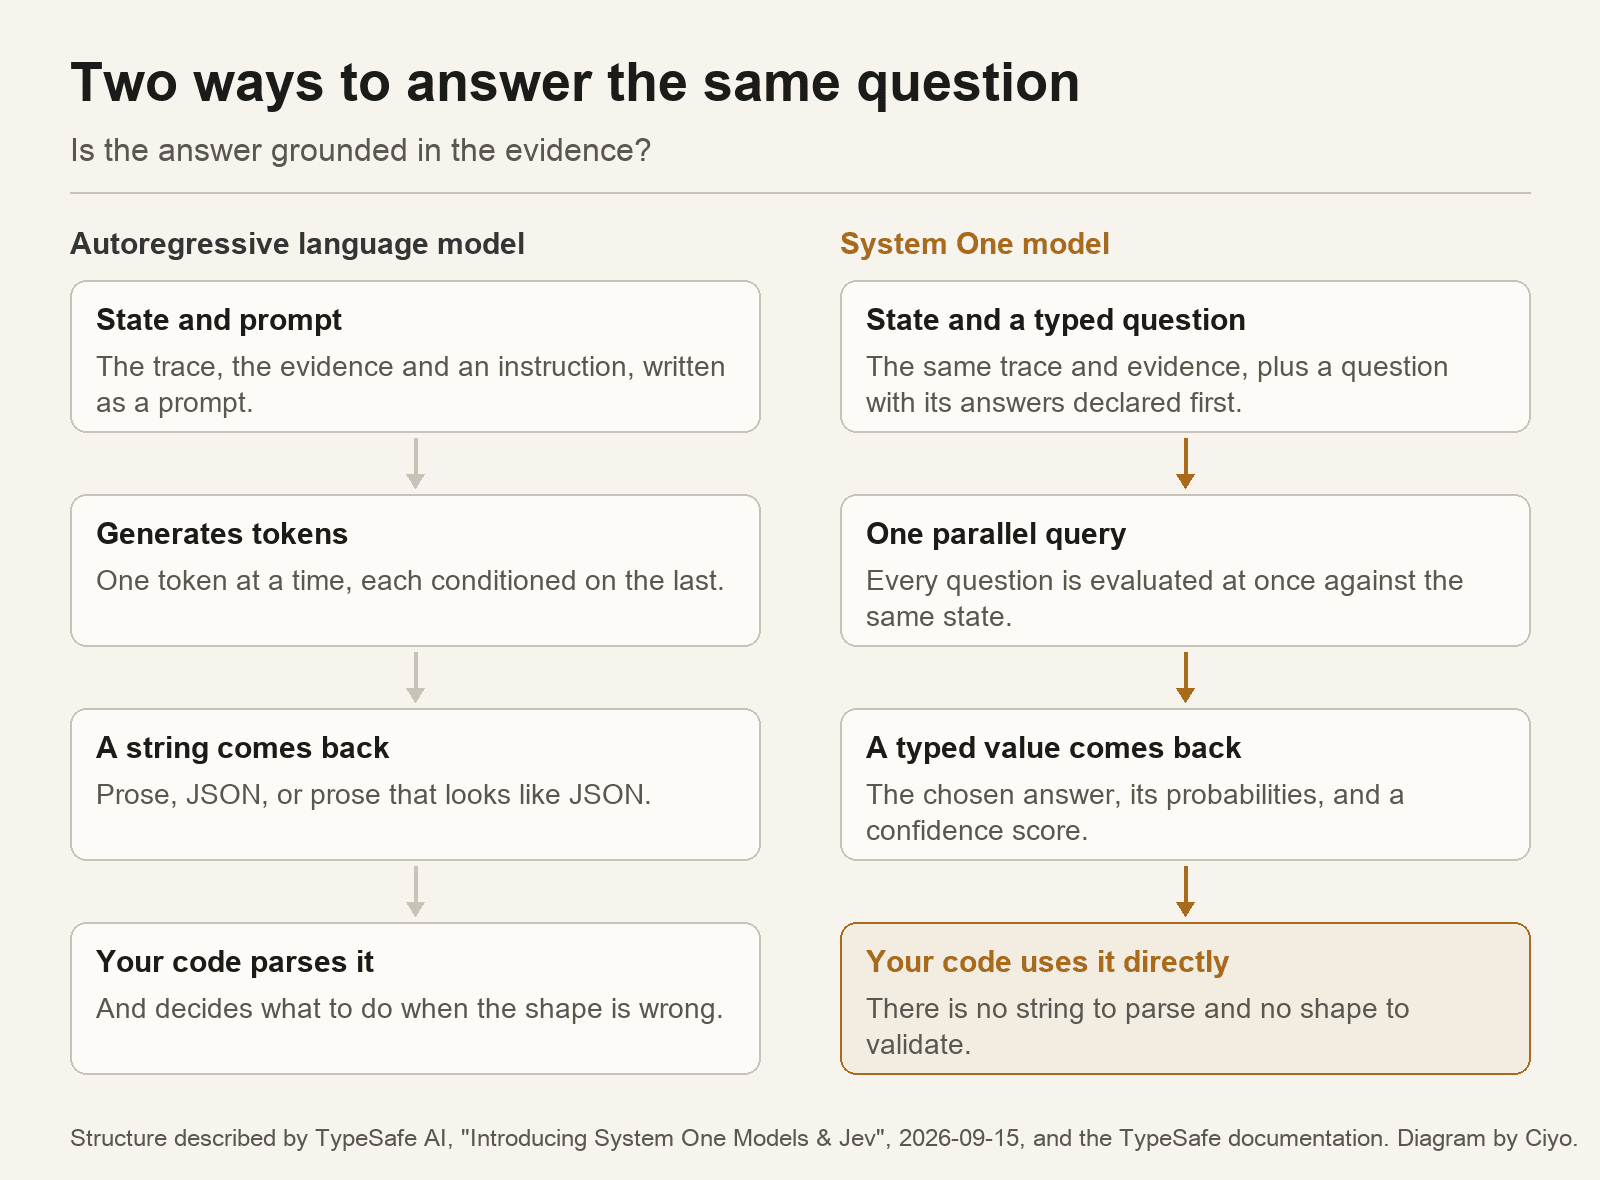
自迴歸語言模型一次取樣一個 token,每一個都以前一個為條件,最後交給你一個字串。那個字串具備的任何結構,都是模型學會模仿的慣例,所以每一個需要從模型取得值的正式系統,最後都會多出一個解析器、一個結構驗證器和一套重試機制。
System One 模型把順序倒過來,藉此拿掉那一層。你先宣告可能的輸出,再給模型一個結構化的狀態和一個有型別的問題。回來的是你宣告的那個型別的值,並附上各個可能答案的機率和一個信心分數。
代價是徹底的:沒有散文、沒有程式碼、沒有開放式回覆。TypeSafe 把它定位成刻意的架構取捨而不是限制,名字本身也說明了這一點。System One 是快速、自動的判斷;System Two 是深思熟慮。Jev 只是第一個。
| 項目 | 自迴歸語言模型 | System One 模型 |
|---|---|---|
| 取樣 | 一次一個 token,每一個以前一個為條件 | 所有輸出在單一次平行查詢中產生 |
| 輸出 | 一個字串,帶著它學會模仿的那種結構 | 一個型別安全的結構化值,事先宣告 |
| 不確定性 | 頂多從措辭中暗示 | 各個答案的機率,外加一個信心分數 |
| 訓練 | RLHF,針對人偏好的回覆最佳化 | RLCD,據稱針對校準過的決策最佳化 |
| 放棄了什麼 | 原則上沒有 | 完全放棄字串生成 |
回答同一個問題的兩條路
拿一個代理程式時時刻刻都在問的具體問題來看:這個答案是否有它取回的證據支撐?兩種模型都能回答。它們走的是不同的路,而路線本身就是全部的重點。
左邊那條路大家都熟。右邊那條路從頭到尾不產生字串,所以沒有東西要解析、沒有東西要驗證,也不會出現那一類失敗:模型寫出一句完全合理的句子,取代了你的程式所期待的那個欄位。
原子化的問題,由程式碼組合
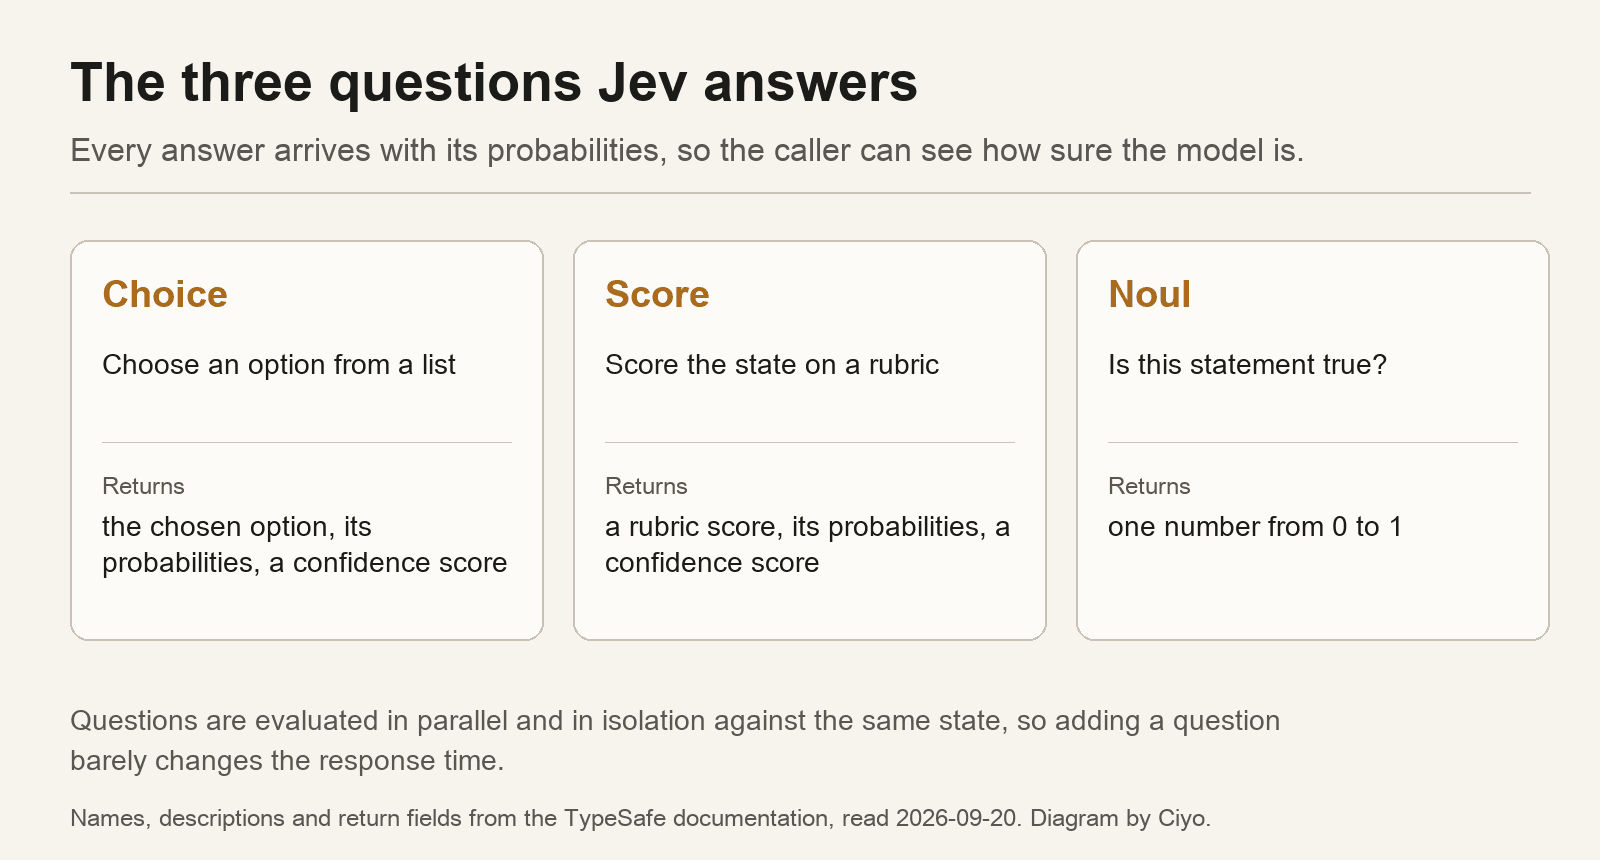
文件只開放三個原語,沒有其他。Choice 從一份清單中挑出一個選項,回傳被選中的選項、全部選項的機率,以及一個信心分數。Score 依評分準則為狀態評分,回傳相同的三個欄位,只是把選項換成分數。Noul 回答某個陳述是否為真,回傳一個介於 0 和 1 之間的數字。
工程師最容易低估的是組合規則。每一個問題都針對同一個狀態,平行而且彼此獨立地一次評估完成,所以針對一次追蹤紀錄問十二個問題,並不等於十二趟往返。文件講得很直白:增加問題幾乎不會改變回應時間。
這讓評估變成你用普通程式碼就能寫出來的東西。不必寫一則又長又要模型同時權衡好幾件事、再用 JSON 回報的提示詞,而是問好幾個答案已宣告的小問題,然後自己把結果組合起來,在你看得見的地方。
為什麼「不會產生幻覺」的說法比聽起來窄
TypeSafe 說 System One 模型「不會產生幻覺」。請把它讀成關於型別的主張,而不是關於真實的主張。因為可能的輸出和它們的結構都事先定義好了,模型不可能回傳你沒有宣告的類別、格式錯誤的物件,或是一句自信滿滿卻在講不存在文件的句子。那一類臭蟲從架構上就消失了。
剩下的是普通的錯。Choice 可能從你的清單中挑錯選項。Score 可能給一個爛答案高分。模型會告訴你它有多確定,TypeSafe 也把那些機率形容為校準過的、「在認知上誠實的」,但校準過的 0.7 仍然有十次錯三次。
這就是為什麼信心值是介面的一部分,而不是附贈品。TechCrunch 在 9 月 18 日的報導中引述的開發者,描述的正是這個轉變:那個數字歸你詮釋,而在 0.55 的時候要怎麼辦,現在是你的設計問題,不是模型的問題。
它是怎麼訓練的,就目前公開的部分而言
TypeSafe 把自己的方法命名為 Reinforcement Learning for Calibrated Decisions,簡稱 RLCD,並拿它和形塑聊天模型的 RLHF 對照。RLHF 針對人類偏好的回覆最佳化,而 RLCD 據稱是針對「說出口就算數」的機率最佳化。
除了名稱和輸出契約之外,架構並未公開。TechCrunch 指出創辦人對此守口如瓶,模型也沒有公開權重。任何人告訴你 Jev 內部是怎麼運作的,都是從它的 API 形狀推論,而不是從論文得知。
它今天在哪裡跑
取用方式是早期使用候補名單,typesafe.ai 上有主控台和文件。OpenRouter 的 TypeSafe 供應商頁面列出 jev-latest 和 jev-1.13,脈絡為 32,000 個 token,但那些項目並未出現在 OpenRouter 的公開模型清單中,所以這條路是受限的,不是開放的。
更值得注意的發布消息在基礎設施這一側。2026 年 9 月 17 日,Cloudflare 宣布 Jev 已在其 AI Gateway 上線,用的正是這個模型自己的詞彙:送出狀態和有型別的問題,取得你的程式可以直接使用的結構化答案。這類模型多半就是這樣抵達大多數人手上的——不是作為一個應用程式,而是作為你早就在跑的某個東西裡面的一次呼叫。
發表於 2026-09-17。一家供應商宣布自己的整合:這是可取用性的證據,不是效能的證據。
關於 System One 模型的問題
Jev 是小型語言模型嗎?
不是。它不是自迴歸的,也不生成任何文字。它針對結構化的狀態評估一個有型別的問題,回傳宣告型別的值,並附上機率和信心分數。
「不會產生幻覺」實際上涵蓋什麼?
涵蓋輸出的形狀。模型不可能回傳你沒有宣告的類別或格式錯誤的物件。它仍然可能挑錯選項,所以每一個答案都會附上信心值。
我今天可以試用嗎?
只能透過早期使用候補名單、TypeSafe 主控台,或像 Cloudflare AI Gateway 這樣的整合。它沒有公開權重,而 OpenRouter 的列表也不在它的公開模型 API 中。
繼續閱讀
Ciyo 書寫創意與代理工具背後的模型,並實測那些自己跑得動的。