模型 · System One
地板比問題更貴
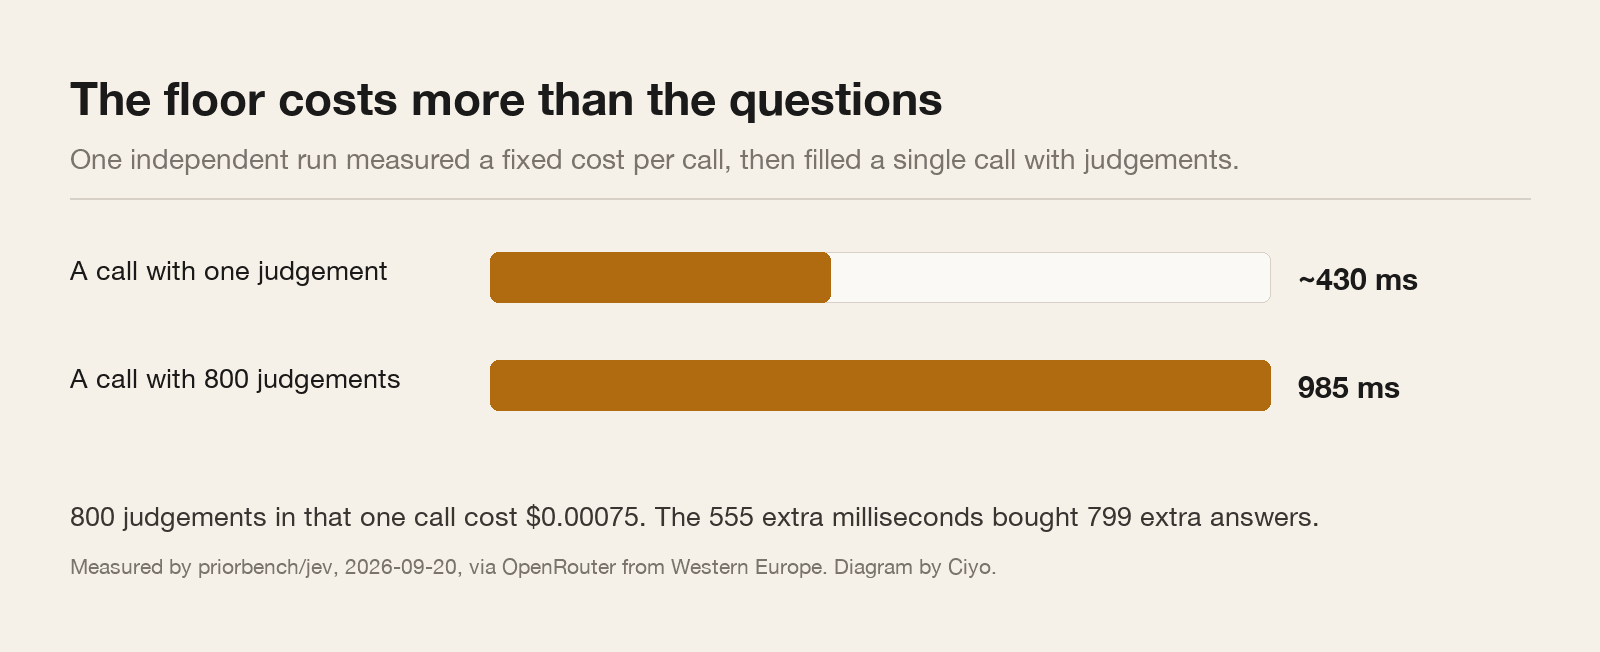
每次網路呼叫都有一個在任何工作發生之前就要支付的固定價格。通常它小到可以忽略。但當一個模型在幾十毫秒內就能回答時,它不再小,而變成了帳單的大部分。
一項於2026年9月20日發布的、預先註冊的 Jev 獨立評測,測量了這塊地板,然後測試了填滿一次呼叫時會發生什麼。這些數字支持一種特定的系統形態,而那不是多數人最先建構的形態。Ciyo 不執行 Jev——它不產生影像,也不產生影片——所以這是一篇對公開測量的解讀,而非產品說明。
測量了什麼
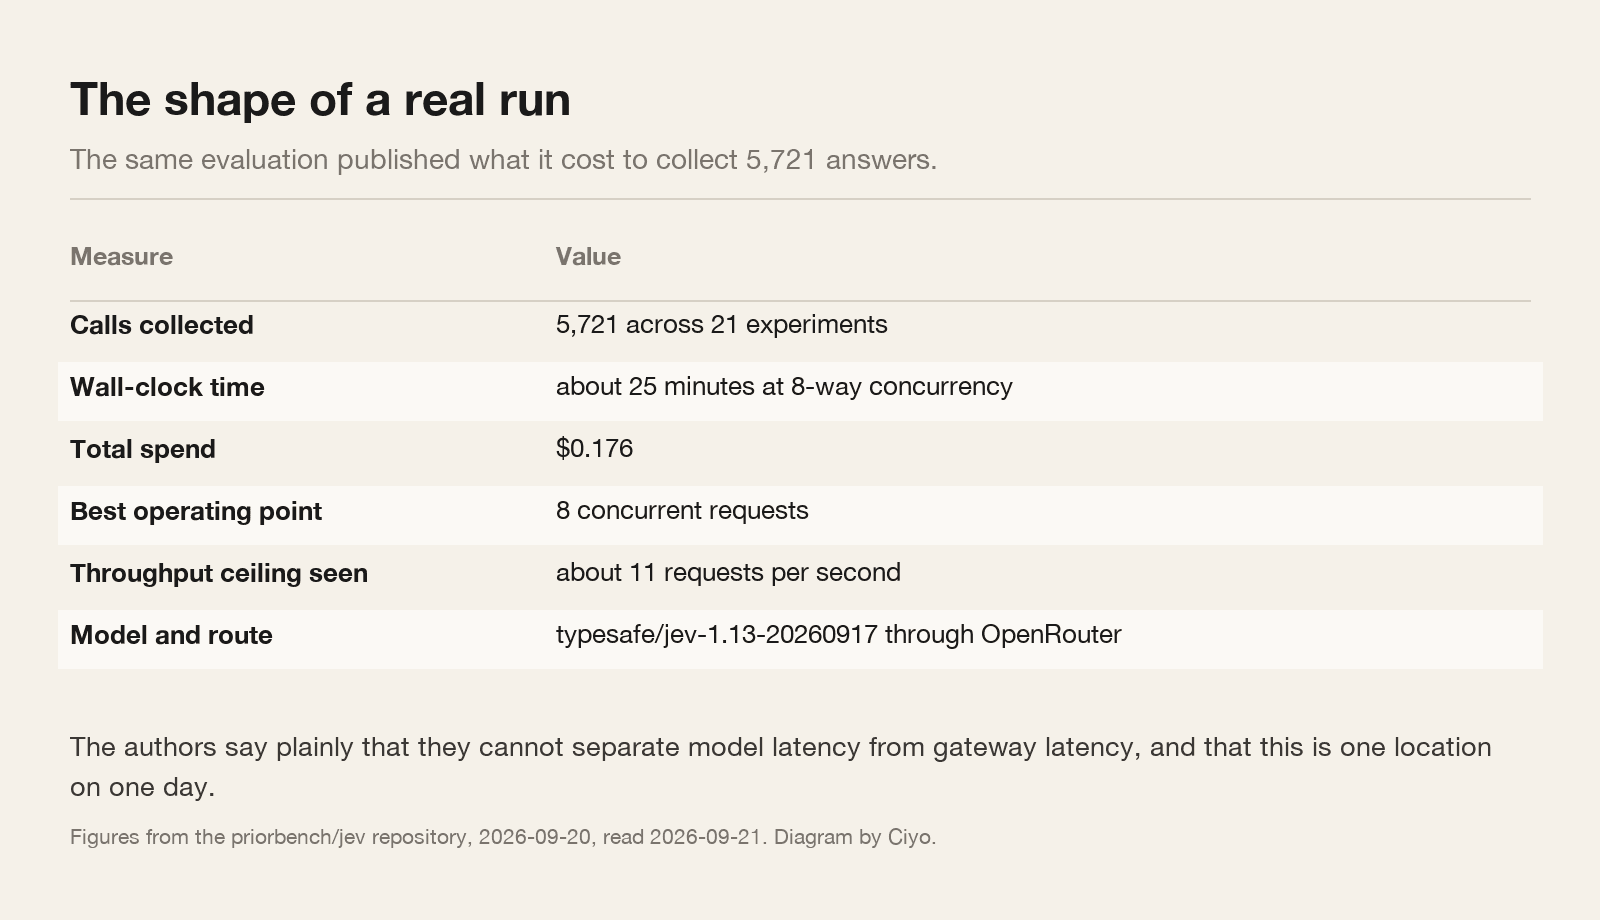
該評測在 21 項實驗中收集了 5,721 次呼叫,並在資料收集開始前對 50 個預測打了時間戳記。它透過 OpenRouter 從西歐執行了 `typesafe/jev-1.13-20260917`,並公開了原始資料。
兩個發現驅動了其餘一切。每次呼叫有約 430 毫秒的固定成本。把 800 個型別化判定放進一次呼叫,在 985 毫秒內完成,成本為 0.00075 美元。
把這兩點合起來,算術就很刺眼。第一個判定花費約 430 毫秒。其後 799 個合計花費約 555 毫秒,也就是每個約 0.7 毫秒。
作者自己的保留意見,而這很關鍵
他們明說,無法把模型延遲從閘道延遲中分離出來。430 毫秒是測量值;而「它是模型的屬性而非路由的屬性」這一說法只是假設,他們也這麼說。任何擁有原生 API 存取權限的人都能很快判定。
這個保留意見並不會削弱設計建議。無論地板由什麼構成,你每次呼叫只付一次,所以填滿呼叫在兩種情況下都是那個槓桿。但它確實意味著,在拿別人的數字搭建延遲預算之前,你應該從自己的地域測量自己的地板。
它也只是一個地點、一天、針對一個模型版本。把它當作事物的形態,而非一份規格。
這支持什麼
不要建構那種發送一個 state 和一個問題、等待、再發送下一個的迴圈。那種設計幾乎把所有時間都花在反覆支付地板上。
從同一測量中得出兩種更好的形態。把問題攤開:把 state 發一次,帶上你可能想要答案的每一個問題,包括你很可能會丟棄的那些,因為邊際問題近乎免費。再把狀態批次處理:如果你是在分類積壓工作而非回應即時事件,就把許多條目放進一次呼叫,而不是在一分鐘內發起許多次呼叫。
第二種形態有一個與延遲無關的限度:一次攜帶 800 個判定的呼叫,攜帶的是 800 個判定份量的 state,而你必須能把每個答案歸因回它的那一行。讓你的問題標識有意義,讓你的對應顯式。
發布於 2026-09-21。一位正在做郵件分流設計的開發者指出,這些原語可以平行使用,帶門檻的 Score 和 Choice 在同一任務上表現並不一致,而且文件化的模式傾向於在一次呼叫裡問很多問題——甚至是猜測性的那些。最後這一點,正是本文從延遲資料得出的相同結論。
並發,以及它在何處不再有幫助
同一執行考察的是呼叫之間的平行,而非呼叫之內。它發現 8 個並發請求是最佳工作點,吞吐量在約 11 個請求每秒時飽和。
這是個很小的數字,在你設計扇出工作池之前值得知道。超過 8 個在途請求後,執行沒有完成更多工作;只是有了更多排隊的請求。那 5,721 次呼叫在該設定下花了約 25 分鐘,總成本 0.176 美元。
如果你需要的不只是約 11 個請求每秒,這些數字給出的答案不是更多的工作執行緒,而是更少、更滿的呼叫。
一份你真正能寫下來的預算
取這些數字的形狀,把它用到真實工作負載上,而不是用到基準測試上。假設你想評估每一次智慧代理執行的每一步,而你每天有 50,000 步,每步四個問題。
若每步一次呼叫,那就是 50,000 次呼叫,在測得的地板和並發下約 6 小時的掛鐘時間,以及大量排程。若每批比如說 200 步一批地批次呼叫,則是 250 次呼叫。權杖成本兩種方式相同,因為你發送的是同一個 state;崩塌掉的是支付地板所花的時間。
這就是整個設計教訓。對這類模型,你該問的問題不是「一次呼叫有多快」,而是「我一次能塞進多少」。
| 設計 | 每天呼叫次數 | 每天支付的地板 |
|---|---|---|
| 每步一次呼叫 | 50,000 | 約 6 小時的固定成本 |
| 每次呼叫批次 200 步 | 250 | 低於 2 分鐘的固定成本 |
| 兩種方式權杖相同 | — | 你付錢買的是 state |
在承諾前該測量什麼
你的地板,來自你的地域,走你的路由。它是一段腳本和 20 分鐘,它是你預算所依賴的那個數字。
你每次呼叫的天花板。把判定數往上推,直到回應時間或錯誤率拐彎,然後待在它下面。
你的歸因。批次呼叫只有在每個答案都能回到正確的那一行時才有用,而那是一類值得寫測試、而不是靠碰運氣的缺陷。
還有你自己的準確率,因為如果判定錯了,速度就毫無意義。速度是用這類模型的原因;與你自己標籤的一致,是留住它的原因。
吞吐量的問題
一次呼叫能塞進多少判定
文件沒有公布每次請求的提問上限。一次獨立執行把 800 個放進一次呼叫,在 985 毫秒內完成,花費 0.00075 美元。
430 毫秒的地板是模型還是網路
未知。作者們測量了地板,並明確說他們無法在自己的路由上把模型延遲與閘道延遲分離開。
我一次能跑多少個請求
在那次執行中,8 個並發請求是最佳工作點,吞吐量在約 11 個每秒時飽和。在給工作池定規模前,先測你自己的。
批次處理會改變權杖成本嗎
不會。你為發送的 state 付費。批次處理壓扁的是每次呼叫的固定成本,不是權杖。
繼續閱讀
Ciyo 撰寫關於創意與智慧代理工具背後的模型,並測試那些它能執行的模型。