模型 · System One
你能按 Jev 的置信度分數來路由嗎?
一個會給出答案的決策模型很有用。一個在給出答案之外,還附帶一個可信數字說明它有多確定答案的模型,可以被接入一個知道何時停下、去問人的系統。
這正是一個經過校準的信度的值的全部承諾,也是最需要查核的宣稱,因為一個不反映現實的信度數字比根本沒有數字更糟:它會讓你的程式碼繼續往下走。兩項獨立評測在 2026年9月17日 那一周公開了資料,兩者合起來比任何廠商頁面都更好地回答了這個問題。Ciyo 不執行 Jev;這是一次對已發布證據的解讀。
信度不是機率
Choice 的回答會帶著兩個不同的數字回來,把兩者混為一談是第一個錯誤。機率描述的是你聲明的各個選項之間的分布:模型信念是如何鋪開的。信度的值是另一個獨立的純量,描述模型對答案本身有多確定。
TypeSafe 自己的文件把它框定為第二根軸:答案告訴你的是什麼,信度告訴你是否該行動。正是這個框架讓它能單獨成篇。你可以搭一個系統,讓答案選分支,讓信度決定人是否先看一眼。
文件化的模式將門檻與出錯代價掛鉤
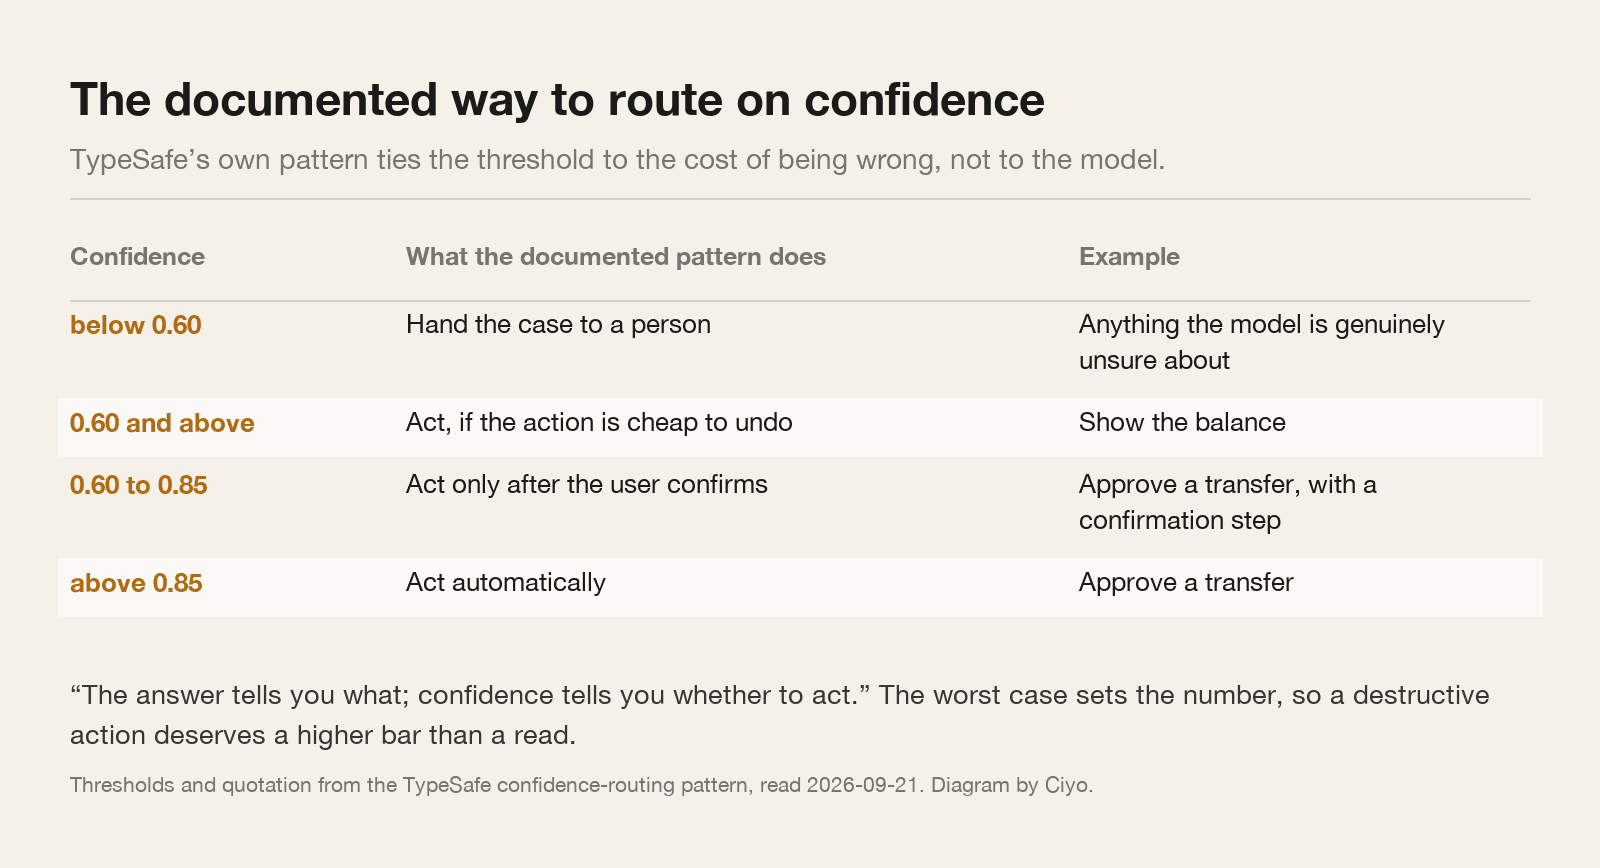
TypeSafe 發布了一個信度路由模式,它的有用之處是不給單一數字,而是給一把梯子,這把梯子與你出錯有多糟綁定。
低於 0.6,交給人處理。高於 0.6,就行動——但僅當行動很廉價時。對於昂貴或不可逆的行動,要在 0.6 到 0.85 之間請使用者確認,只有在 0.85 以上才自動執行。在它的工作示例裡,顯示帳戶餘額在 0.6 就通過,而批准一筆轉帳要等到 0.85 才通過。
這比任何單一全域門檻都更好的預設,因為它逼你把行動的成本寫下來。多數團隊這樣做時會發現,自己一直在用同一個分支跑好幾種差別很大的行動。
兩次獨立運行測了什麼
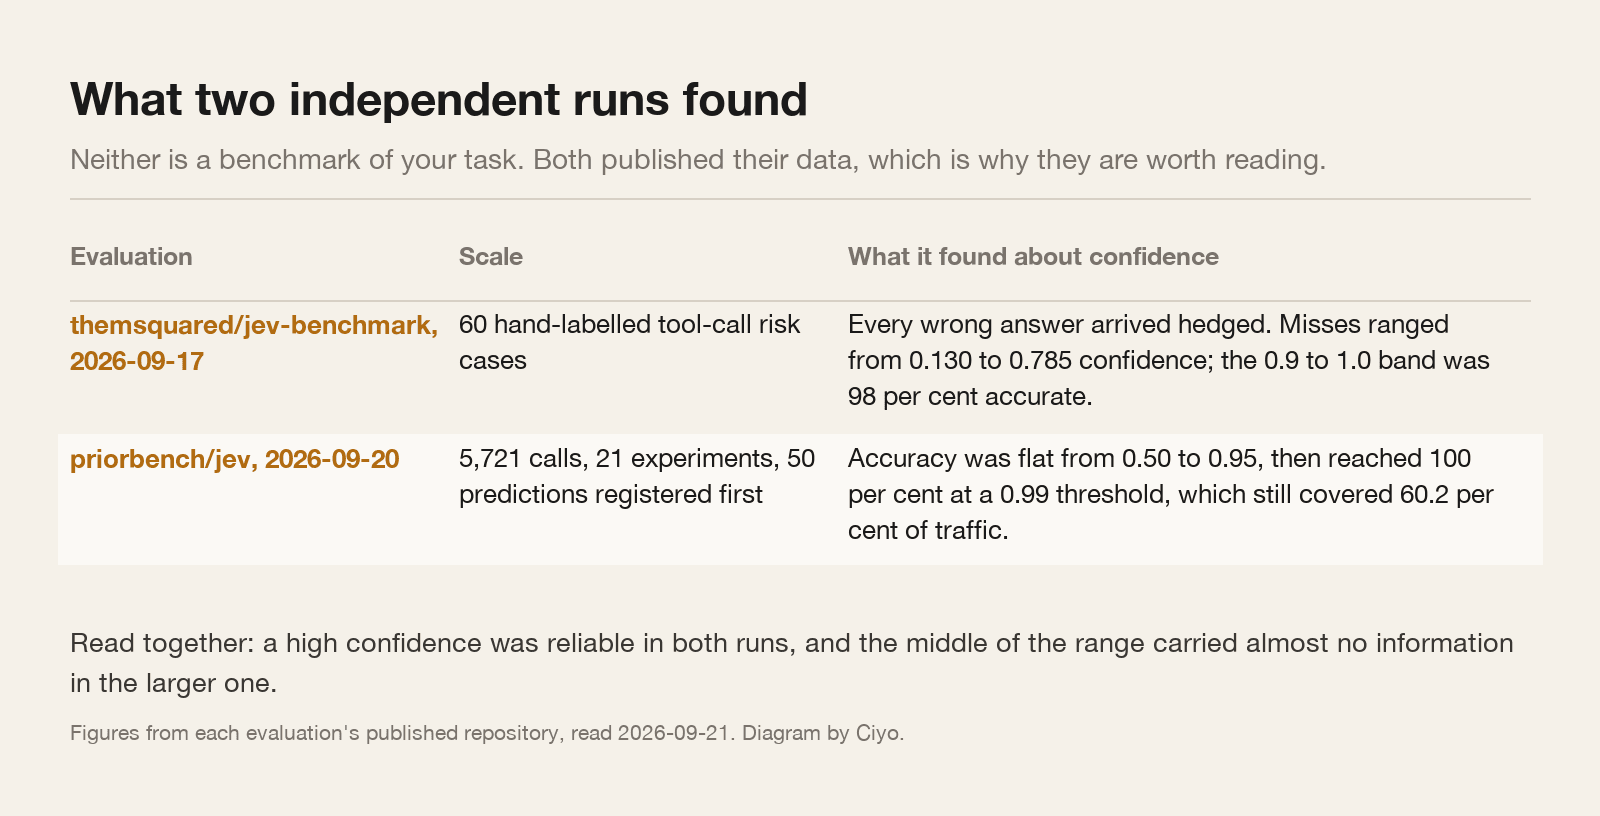
第一次小而尖銳。2026年9月17日,一個可復現的基準測試把 60 條手工標註的 Agent 工具呼叫分成四類風險,分佈在清晰、模糊和對抗性的情況之間。整體準確率為 91.7 百分比——清晰情況 100 百分比,模糊情況 71.4 百分比。這裡要緊的發現是:每個錯誤答案都帶著保留地到來。漏判的信度介於 0.130 和 0.785 之間,模型在錯誤時從不回傳最大信度,而 0.9-1.0 這一帶準確率有 98 百分比。
第二次更大且預先註冊。2026年9月20日,一項評測發布了跨 21 個實驗的 5,721 次呼叫,其中有 50 條預測在任何資料收集前就打上了時間戳。在這些預測中,26 條被確認,21 條被證偽,其中 18 條是因為作者預期會失敗卻沒有出現失敗。在校準上它發現準確率在 0.50 到 0.95 之間基本持平,隨後在 0.99 的門檻處達到 100 百分比,而這一門檻仍覆蓋了 60.2 百分比的流量。
合起來讀,它們說的比「信度挺好」更精確。高信度在兩者中都可靠。區間的中段在那次較大的評測裡幾乎沒帶資訊。
這對你的門檻意味著什麼
如果準確率從 0.5 到 0.95 都是平的,那麼 0.7 的門檻和 0.9 的門檻在那項任務上買到的東西大致相同,而在 0.9 處多出的拒絕大多是浪費的人力時間。
有趣的區間是頂端。一個 0.99 的閘門仍能在完全準確率下自動處理 60 百分比的流量,這是真正有用的運行點:五分之三的工作原樣跑完,其餘交到人手上。這與「把最低的 5 百分比路由給人」是不同的系統設計。
但這是某一天的項任務,而且不是你的。該據以行動的數字,是你在自己標註的集合上測出來的那個。
| 發現了什麼 | 它支援什麼 | 它不支援什麼 |
|---|---|---|
| 每個錯誤答案都帶保留,n = 60 | 在該任務上把最大信度的答案當作安全 | 保證它在你的任務上絕不會自信地失敗 |
| 準確率從 0.50 到 0.95 持平 | 懷疑中段的門檻買不到什麼 | 宣稱信度在 0.99 以下毫無用處 |
| 在 0.99 處 100 百分比,覆蓋 60.2 百分比 | 設計高閘門、高覆蓋的升級策略 | 不同任務或分佈上的同樣覆蓋 |
一個下午測出你自己的曲線
你需要一個標註集合,如果沒有,此刻你就會發現自己反正早就需要它了。你已判定過的 200 行就足以有意思。
把每一行發過去,保留答案和信度,再按信度分桶,算每個桶的準確率。那張表就是你的校準曲線。挑一個準確率足夠匹配該行動成本的、最低的門檻,把低於它的一切路由給人。
然後在你改了問題措辭時重跑,因為你改動了模型的任務,而你測出的曲線屬於舊的那個。
2026-09-21 發布,引用預測系統公司 Yarrow 的一條貼文。發帖人對校準的定義——模型說 70 百分比時,事件就應當以 70 百分比的機率發生——是標準定義,也正是校準曲線值得測量的原因。注意商業語境:被引的帳號販售預測產品,並在拿自己作類比。
這個設計招來的失敗
一個廉價、可復現的裁判會改變行為。當一次決定只花一美分的零頭時,團隊會停止抽樣、開始評估一切,而這正是它的意義所在。
它也意味著,一個在穩定方向上出錯的裁判,現在在任何地方都靜悄悄地、以最大信度、在每一行上出錯。低變異在變好之前先變糟,因為一個可復現的錯誤會被精確重複。
緩解辦法毫不光鮮:保留一個人工標註的標準答案集,問題一變就重新測一致率,並且去讀裁判批准過的樣本,而不只是它拒絕過的。
信度的問題
信度和最高機率是一回事嗎?
不是。機率描述的是你聲明的各選項之間的鋪開程度。信度是另一個關於模型究竟有多確定的值,而且正是文件化路由模式所用的那個。
我該用哪個門檻?
公開的模式把它和行動的成本綁在一起:低於 0.6 交給人,0.6 用於廉價行動,0.6 到 0.85 用於昂貴行動需使用者確認,0.85 以上自動。然後測你自己的曲線。
有人發現它自信地錯了嗎?
在那 60 條的基準測試裡沒有——每條漏判都帶保留,模型從不在最大信度下答錯。一位從業者報告過在不可知情況上自信地給錯機率,但沒有公開資料。
Ciyo 用信度路由嗎?
不用在 Jev 上,因為 Ciyo 不執行它。這個模式本身——一個類型化判斷加一個決定人是否查看的門檻——適用於任何評測者,包括充當審查者的語言模型。
繼續閱讀
Ciyo 寫的是創意與 Agent 工具背後的模型,並測試那些它能執行的模型。