模型 · System One
你的第一次 Jev 调用,逐项拆解
TypeSafe AI 于 2026年9月20日 取消等候名单,向所有人开放 Jev。文档也随之公开,这意味着有趣的问题不再是你能否试用,而是这次调用究竟长什么样。
这是一次调用漫游:你发送什么、返回什么,以及在据此搭建系统前值得了解的已发布限制。Ciyo 不运行 Jev —— 它不生成图像也不生成视频,也没有出现在我们的任何一个模型注册表中 —— 所以这里绝不是产品发布。它只是关心创意与 Agent 工具内核的人,对新近公开的 API 的一次解读。
一次调用就是一个 POST
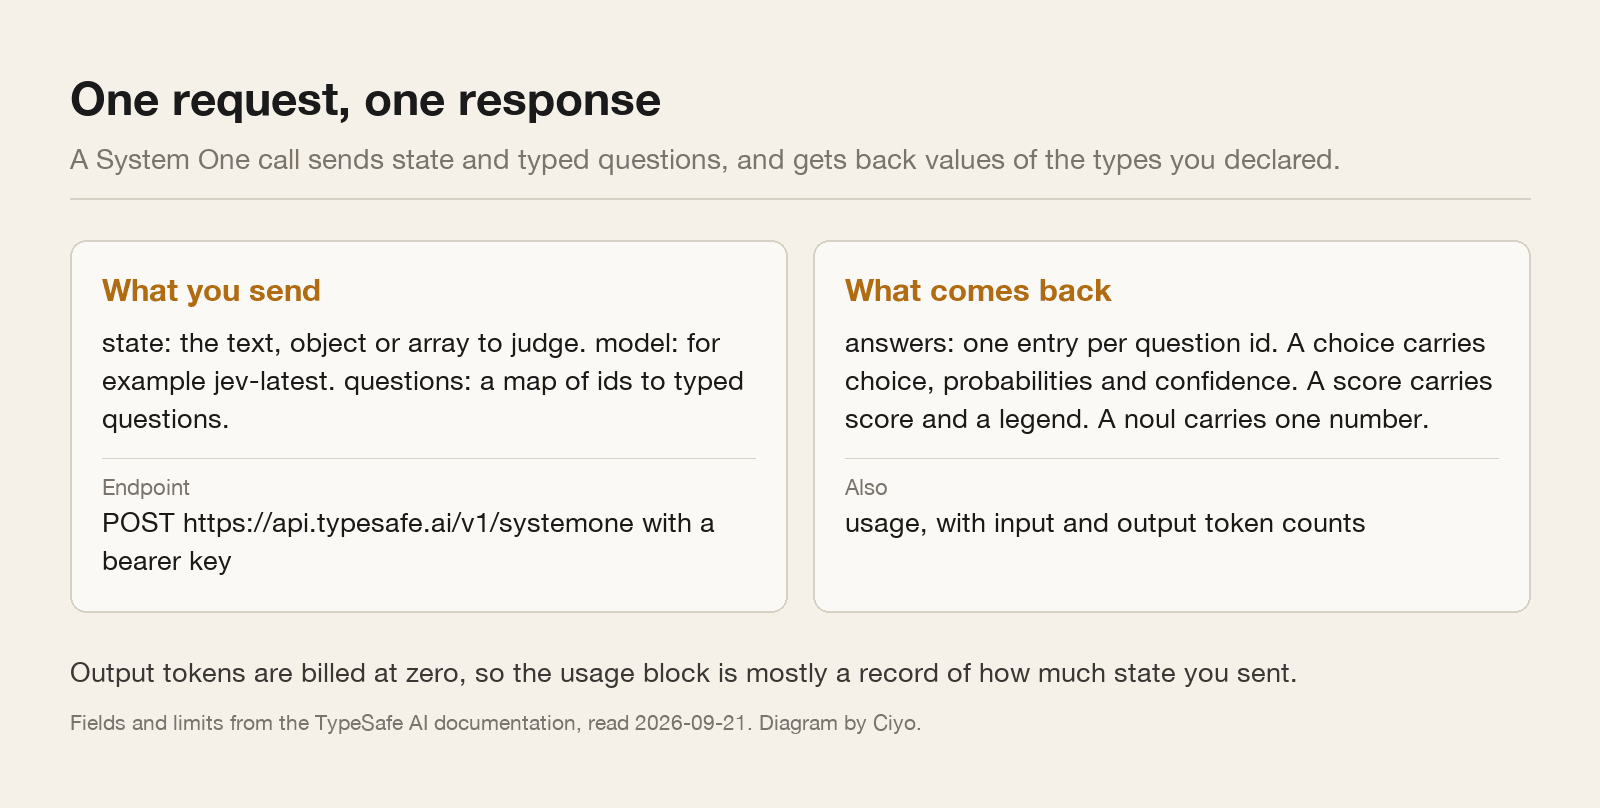
所有请求都发往同一个端点:`POST https://api.typesafe.ai/v1/systemone`,在 Authorization 头里放 bearer 密钥,请求体里放 JSON。
请求体有三个必填字段。`state` 是被判定的对象 —— 字符串、JSON 对象或文本值数组。`model` 指定模型,例如 `jev-latest`。`questions` 是从你自己的问题 id 到类型化问题的映射。
响应与之对应。`answers` 是以相同问题 id 为键的映射,`usage` 报告输入和输出的 token 数。由于输出 token 按零计费,这个 usage 块基本只是记录了你发送了多少 state。
三种问题类型,以及如何区分
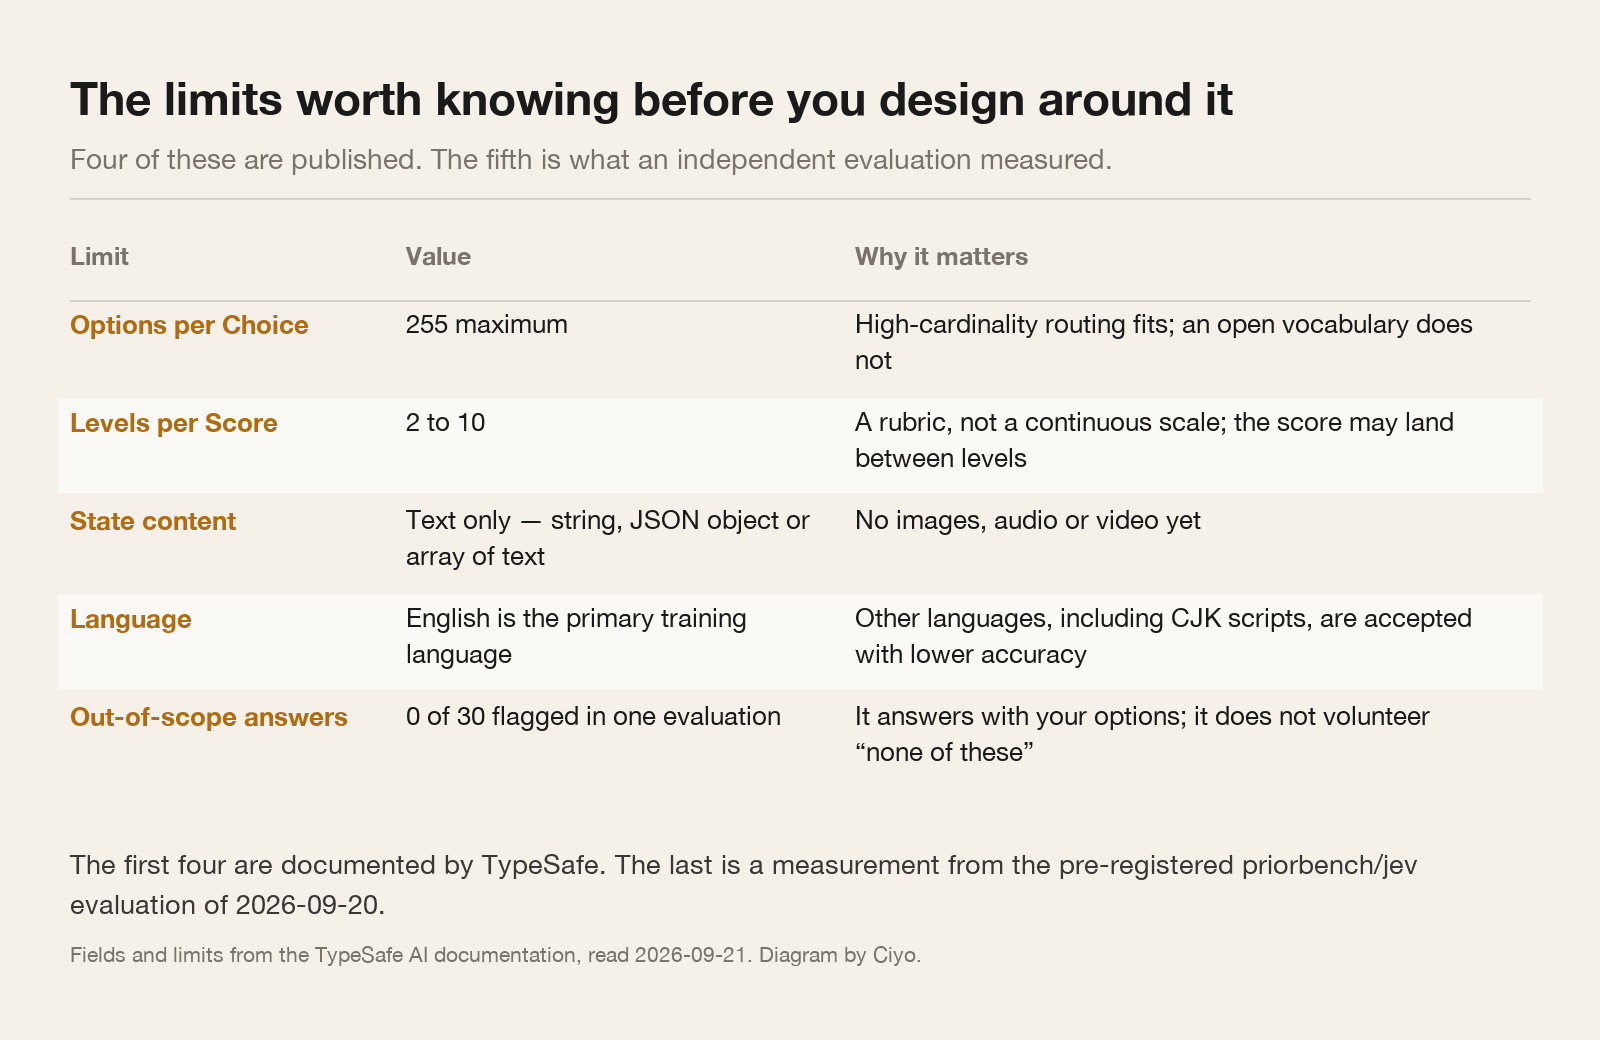
Choice 从你声明的列表里选一个选项。你提供 `instructions` 和一个从选项名到其描述的 `criteria` 映射,文档标注选项上限为 255。它返回选中的选项、每个选项的概率,以及置信度的值。
Score 把 state 放到一个由数组提供的、2 到 10 级的评分量表上。它返回一个可能落在级别之间的分数、各概率、图例和置信度的值。
Noul 回答一句真假陈述,返回 0 到 1 之间的单个数字。可选的 `criteria` 让你描述真和假分别长什么样。它最便宜、最随手,也最被人滥用。
Choice 与 Score 的实用差别在文档里并不明显,在敲定前值得用同一个 state 把两者都跑一遍 —— 你自己代码里的分数加一个阈值,和显式选项之间的选择,并不是同一个决策,即便大多数时候它们给出同一答案。
2026-09-20 由 TypeSafe AI(该模型的厂商)发布,指向 console.typesafe.ai。正是这条公告把早期访问的等候名单变成了开放注册,也是本文能描述你今天就能发出的调用的原因。
每个问题都针对同一个 state 判定
正是这个设计理念让 API 的形变得合理。你发送一次 state,映射里的每个问题都针对它并行且隔离地被评估。问题之间看不到彼此的答案。
这带来两个后果。加一个问题很便宜,因为一次调用的成本主导项是发送 state 而非回答。而串联要你自己做:如果问题二只在问题一说“是”时才该运行,那段逻辑写在你拿到的答案之上、你的代码里。
设计时需要绕开的限制
其中四条由 TypeSafe 发布。第五条来自一项独立评测,也是生产环境里最可能咬你一口的那条。
值得做的一次首次调用
别从你真正想自动化的决定开始。从你已经手工打过标签的决定开始,因为第一天里唯一有趣的数字,是你自己标签的一致率。
取你判定过的 50 行,每行作为 state 发送,并问那个你已经回答过的问题。为每个答案保留置信度的值。这样你就有了自己数据的一致率和校准曲线,比任何已发布的基准测试都更有价值。
POST https://api.typesafe.ai/v1/systemone
Authorization: Bearer $TYPESAFE_API_KEY

{
  "model": "jev-latest",
  "state": { "subject": "...", "body": "...", "sender": "..." },
  "questions": {
    "urgent": { "type": "noul", "instructions": "这条消息今天需要回复。" },
    "topic": { "type": "choice", "instructions": "它应该进入哪个队列?",
      "criteria": { "billing": "...", "bug": "...", "none_of_these": "以上都不适用。" } }
  }
}
它做不到的事
它什么也不写。没有摘要,没有改写过的句子,没有代码,没有替代文本,没有图像。如果你要的输出是散文,那用错工具了,普通语言模型才对。
它只接受文本。文档说 state 必须是字符串、JSON 对象或文本值数组,而图像、音频和视频暂不支持。
它在英语上最强。文档说英语是主要训练语言,包括 CJK 文字在内的其他语言以较低准确率被接受 —— 如果你的支持队列不是英语,这就很要紧。
而且它不会告诉你没有任何选项合适。那个选项要你自己声明。
首次调用的问题
我还需要等候名单的邀请吗?
不需要。TypeSafe 于 2026年9月20日 宣布,Jev 已取消等候名单、向所有人开放,通过 console.typesafe.ai 使用。
我该从哪种问题类型开始?
Noul,用于你已经手工打过标签的决定。它只返回一个数字,让第一次一致检查打分变得微不足道。
一次调用能放多少个问题?
文档没有公布上限。但它确实说问题是针对同一个 state 并行评估的,并且有一次独立运行在单次调用里放了 800 个判定。
Ciyo 能用 Jev 吗?
不能。Jev 不生成图像也不生成视频,也没有出现在 Ciyo 的任何一个模型注册表中。我们写它,是因为它是 Agent 工具背后的机制之一,而不是因为我们在运行它。
继续阅读
Ciyo 写的是创意与 Agent 工具背后的模型,并测试那些它能运行的模型。