模型 · System One
你能按 Jev 的置信度分数来路由吗?
一个会给出答案的决策模型很有用。一个在给出答案之外,还附带一个可信数字说明它有多确定答案的模型,可以被接入一个知道何时停下、去问人的系统。
这正是一个经过校准的置信度的值的全部承诺,也是最需要核查的宣称,因为一个不反映现实的置信度数字比根本没有数字更糟:它会让你的代码继续往下走。两项独立评测在 2026年9月17日 那一周公开了数据,两者合起来比任何厂商页面都更好地回答了这个问题。Ciyo 不运行 Jev;这是一次对已发布证据的解读。
置信度不是概率
Choice 的回答会带着两个不同的数字回来,把两者混为一谈是第一个错误。概率描述的是你声明的各个选项之间的分布:模型信念是如何铺开的。置信度的值是另一个独立的标量,描述模型对答案本身有多确定。
TypeSafe 自己的文档把它框定为第二根轴:答案告诉你是什么,置信度告诉你是否该行动。正是这个框架让它能单独成篇。你可以搭一个系统,让答案选分支,让置信度决定人是否先看一眼。
文档化的模式将阈值与出错代价挂钩
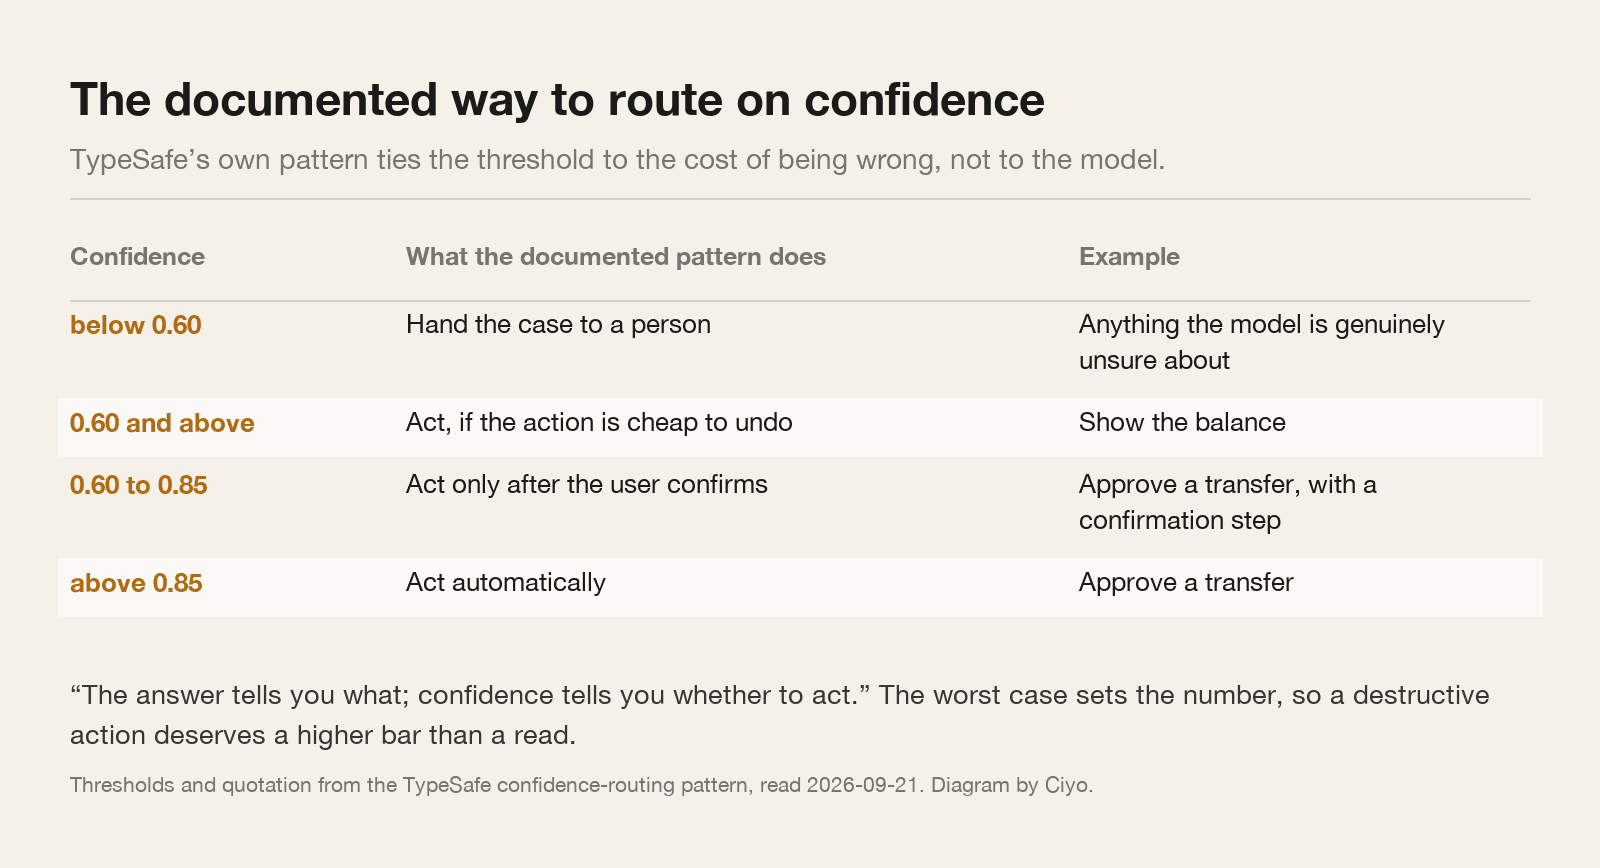
TypeSafe 发布了一个置信度路由模式,它的有用之处是不给单一数字,而是给一把梯子,这把梯子与你出错有多糟绑定。
低于 0.6,交给人处理。高于 0.6,就行动——但仅当行动很廉价时。对于昂贵或不可逆的行动,要在 0.6 到 0.85 之间请用户确认,只有在 0.85 以上才自动执行。在它的工作示例中,显示账户余额在 0.6 就通过,而批准一笔转账要等到 0.85 才通过。
这比任何单一全局阈值都更好的默认,因为它逼你把行动的成本写下来。多数团队这样做时会发现,自己一直在用同一个分支跑好几种差别很大的行动。
两次独立运行测了什么
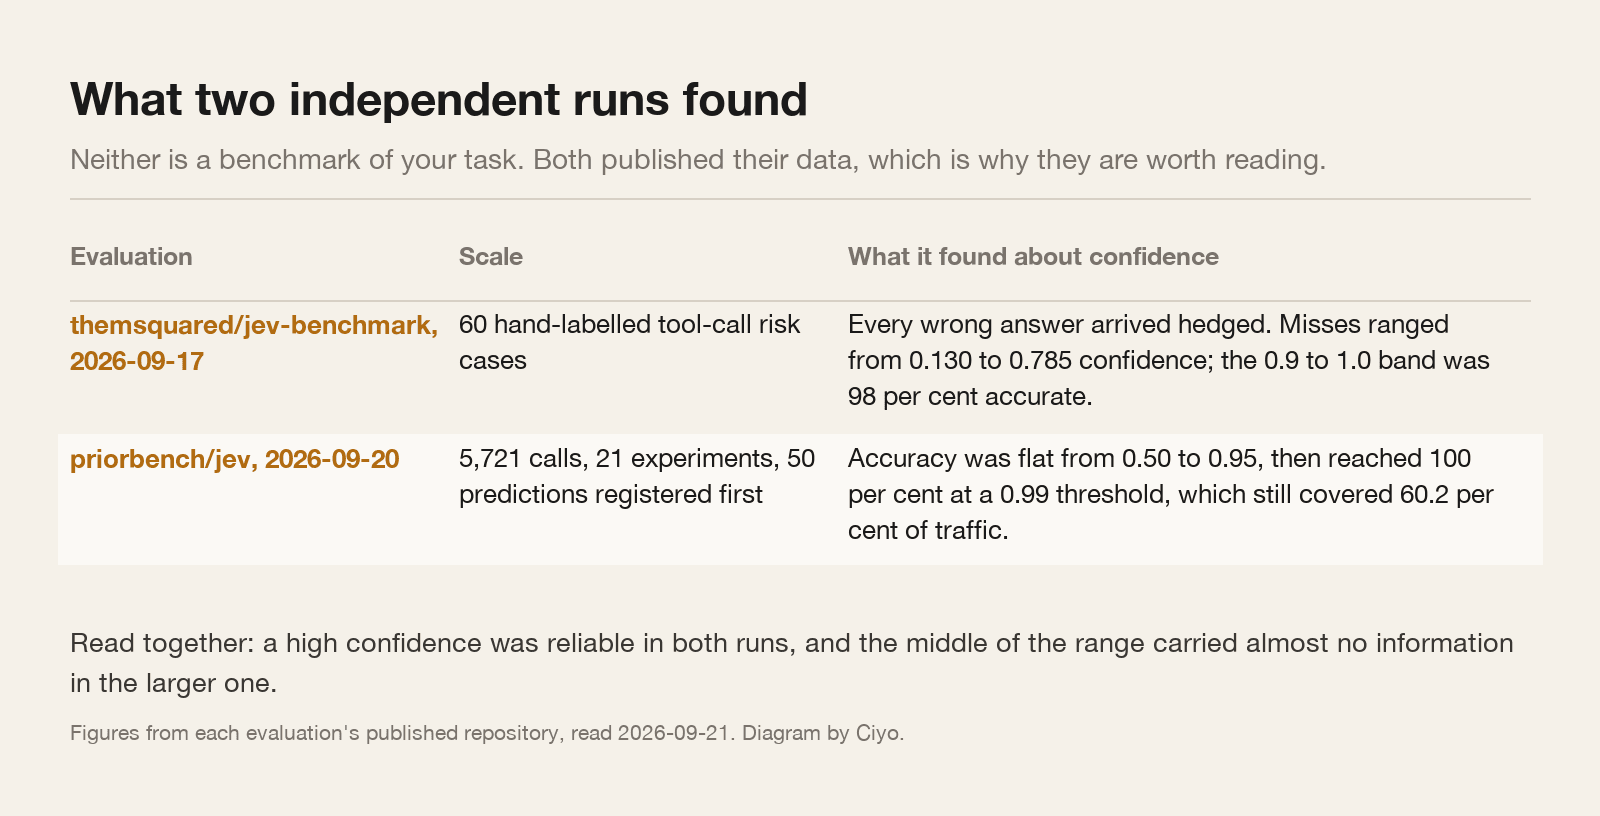
第一次小而尖锐。2026年9月17日,一个可复现的基准测试把 60 条手工标注的 Agent 工具调用分成四类风险,分布在清晰、模糊和对抗性的情况之间。整体准确率为 91.7 百分比——清晰情况 100 百分比,模糊情况 71.4 百分比。这里要紧的发现是:每个错误答案都带着保留地到来。漏判的置信度介于 0.130 和 0.785 之间,模型在错误时从不返回最大置信度,而 0.9-1.0 这一带准确率有 98 百分比。
第二次更大且预先注册。2026年9月20日,一项评测发布了跨 21 个实验的 5,721 次调用,其中有 50 条预测在任何数据收集前就打上了时间戳。在这些预测中,26 条被确认,21 条被证伪,其中 18 条是因为作者预期会失败却没有出现失败。在校准上它发现准确率在 0.50 到 0.95 之间基本持平,随后在 0.99 的阈值处达到 100 百分比,而这一阈值仍覆盖了 60.2 百分比的流量。
合起来读,它们说的比“置信度挺好”更精确。高置信度在两者中都可靠。区间的中段在那次较大的评测里几乎没带信息。
这对你的阈值意味着什么
如果准确率从 0.5 到 0.95 都是平的,那么 0.7 的阈值和 0.9 的阈值在那项任务上买到的东西大致相同,而在 0.9 处多出的拒绝大多是浪费的人力时间。
有趣的区间是顶端。一个 0.99 的闸门仍能在完全准确率下自动处理 60 百分比的流量,这是真正有用的运行点:五分之三的工作原样跑完,其余交到人手里。这与“把最低的 5 百分比路由给人”是不同的系统设计。
但这是某一天的一项任务,而且不是你的。该据以行动的数字,是你在自己标注的集合上测出来的那个。
| 发现了什么 | 它支持什么 | 它不支持什么 |
|---|---|---|
| 每个错误答案都带保留,n = 60 | 在该任务上把最大置信度的答案当作安全 | 保证它在你的任务上绝不会自信地失败 |
| 准确率从 0.50 到 0.95 持平 | 怀疑中段的阈值买不到什么 | 宣称置信度在 0.99 以下毫无用处 |
| 在 0.99 处 100 百分比,覆盖 60.2 百分比 | 设计高闸门、高覆盖的升级策略 | 不同任务或分布上的同样覆盖 |
一个下午测出你自己的曲线
你需要一个标注集合,如果没有,此刻你就会发现自己反正早就需要它了。你已判定过的 200 行就足以有意思。
把每一行发过去,保留答案和置信度,再按置信度分桶,算每个桶的准确率。那张表就是你的校准曲线。挑一个准确率足够匹配该行动成本的、最低的阈值,把低于它的一切路由给人。
然后在你改了问题措辞时重跑,因为你改动了模型的任务,而你测出的曲线属于旧的那个。
2026-09-21 发布,引用预测系统公司 Yarrow 的一条帖子。发帖人对校准的定义——模型说 70 百分比时,事件就应当以 70 百分比的概率发生——是标准定义,也正是校准曲线值得测量的原因。注意商业语境:被引的账号售卖预测产品,并在拿自己作类比。
这个设计招来的失败
一个廉价、可复现的裁判会改变行为。当一次决定只花一美分的零头时,团队会停止抽样、开始评估一切,而这正是它的意义所在。
它也意味着,一个在稳定方向上出错的裁判,现在在任何地方都静悄悄地、以最大置信度、在每一行上出错。低方差在变好之前先变糟,因为一个可复现的错误会被精确重复。
缓解办法毫不光鲜:保留一个人工标注的标准答案集,问题一变就重新测一致率,并且去读裁判批准过的样本,而不只是它拒绝过的。
置信度的问题
置信度和最高概率是一回事吗?
不是。概率描述的是你声明的各选项之间的铺开程度。置信度是另一个关于模型究竟有多确定的值,而且正是文档化路由模式所用的那个。
我该用哪个阈值?
公开的模式把它和行动的成本绑在一起:低于 0.6 交给人,0.6 用于廉价行动,0.6 到 0.85 用于昂贵行动需用户确认,0.85 以上自动。然后测你自己的曲线。
有人发现它自信地错了吗?
在那 60 条的基准测试里没有——每条漏判都带保留,模型从不在最大置信度下答错。一位从业者报告过在不可知情况上自信地给错概率,但没有公开数据。
Ciyo 用置信度路由吗?
不用在 Jev 上,因为 Ciyo 不运行它。这个模式本身——一个类型化判断加一个决定人是否查看的阈值——适用于任何评测者,包括充当审查者的语言模型。
继续阅读
Ciyo 写的是创意与 Agent 工具背后的模型,并测试那些它能运行的模型。