模型 · System One
你声明的选项就是整个模型
用语言模型,糟糕的提示会生成糟糕的句子,你看得出来。用类型化的决策模型,糟糕的问题会生成一个类型完全正确、格式完美的答案,而你根本看不出任何毛病。
这正是值得在把模型接入任何系统之前先理解的陷阱。来自2026年9月17日那一周的两项证据——一项是预先注册的评价,一项是实践者的运行——从不同方向指向同一个结论:你得到的准确率,很大程度上取决于你如何写这些问题。Ciyo 不运行 Jev;它不生成图像,也不生成视频,且不在我们的任何一个模型注册表中。
一个问题,还是五个
本周发布的最直接证据来自一位运行钓鱼邮件分流的实践者。作为一个单一问题提问时,这项任务得了 62.6%。拆成五个独立问题,针对同一 state 评估并在代码中合并后,得了 95%。
这只是某人用自己的标签、在没有公开数据集情况下的运行,所以它是一个尝试拆分的理由,而不是一个可以引用的数字。但它与厂商自己的文档建议一致——分解成原子化的单一目的问题,而不是在一个问题里做多因素判断——也与 API 的形态一致:在一次调用中,每个问题都针对同一 state 并行评估。
经济账让这条建议很容易遵循。一次调用中占主导的成本是发送 state,而不是回答问题。只要 state 上了线路,问五个几乎免费。
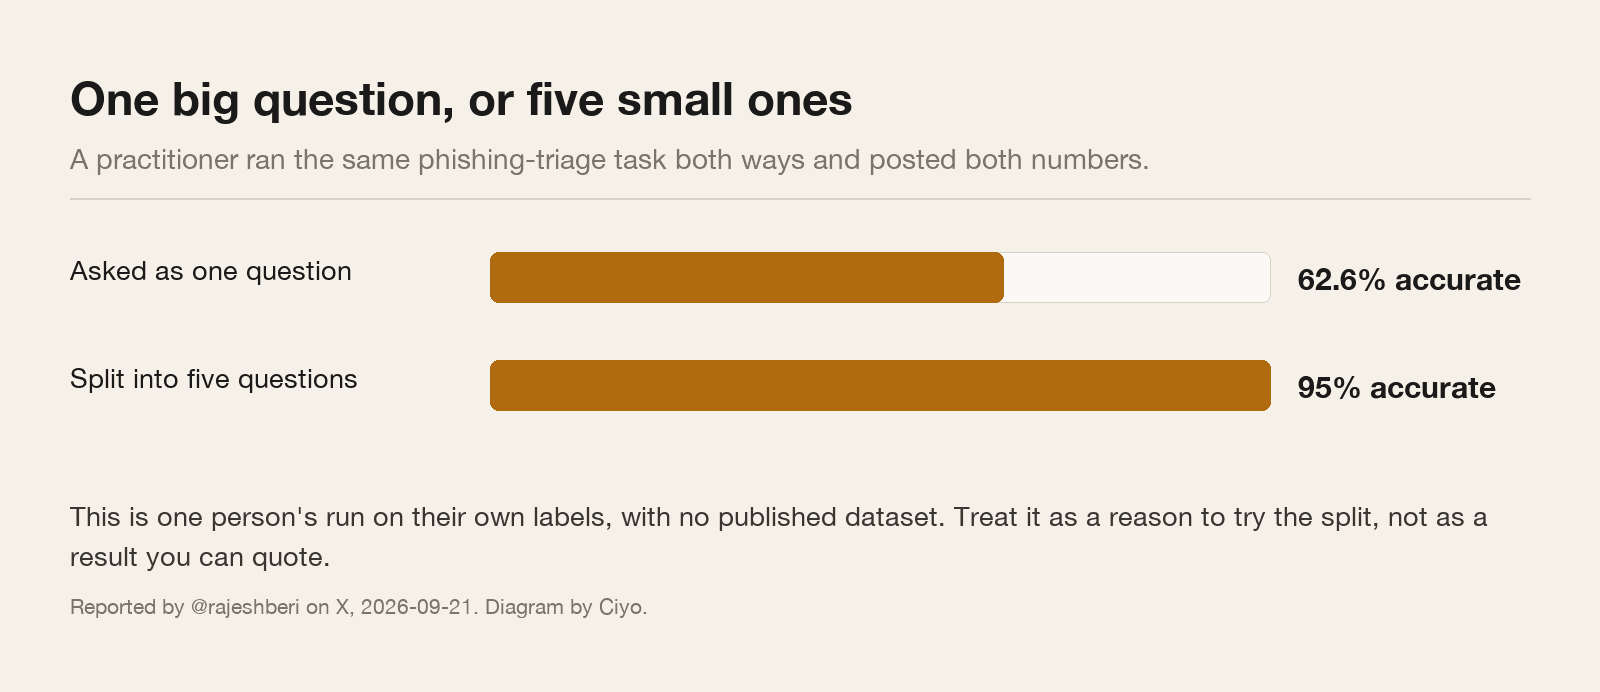
发布于 2026-09-21。发布者从自己的钓鱼分流运行中报告了这两个数字,并补充说在答案确实无法确知的地方,概率表现得自信却错误,最后给出正确建议:先在你自己的标签上做影子测试。由于未发布数据集,这些数字属于发布者本人。
如何拆分一个抗拒拆分的问题
「这封邮件是钓鱼企图吗」是结论,不是问题。拆分的方法是去问能使之成立的证据,一次一条,然后把下结论的事交给你自己的代码。
发件人域名是否与它声称所属的组织匹配?消息是否在索要凭证或付款?措辞里是否有时间压力?可见的链接文字是否与它们实际指向的地方一致?在这个发件人通常使用名字的地方,问候语是否泛泛?
五个窄问题,五个各自带置信度的值的答案,以及你代码中一条可以读取、测试和修改而无需触碰提示的规则。最后这部分才是真正的奖赏:合并逻辑变成了普通的软件。
questions: {
  "sender_mismatch": { "type": "noul", "instructions": "发件人域名与消息声称所属的组织不匹配。" },
  "asks_for_secret": { "type": "noul", "instructions": "消息向读者索要密码、验证码或付款。" },
  "time_pressure":   { "type": "noul", "instructions": "消息迫使读者迅速行动。" },
  "link_mismatch":   { "type": "noul", "instructions": "可见的链接文字与其实际指向的位置不同。" },
  "risk":            { "type": "score", "instructions": "把这封消息投递到收件箱有多危险?",
                        "criteria": ["无害", "可疑", "疑似钓鱼", "明显恶意"] }
}
选项名是一个标签;标准才是定义
Choice 接受一个从选项名到描述的 `criteria` 映射,Score 接受一个有序的级别描述数组。这些字符串不是写给你同事的文档。它们是模型唯一拥有的定义。
「billing(账单)」几乎什么也没告诉它。「发件人在询问一张发票、一笔他不认得的收费、一笔退款,或者更改付款方式」才告诉它要找什么。这第二个版本也是你在任何东西自动化之前可以和同事争论的版本,而那正是分歧代价最低的时刻。
写标准就像给入职第一天的新人写操作指引:什么归这里,什么看起来相似却归别处,以及当两者都不是时该怎么办。
它给不了你的那个答案
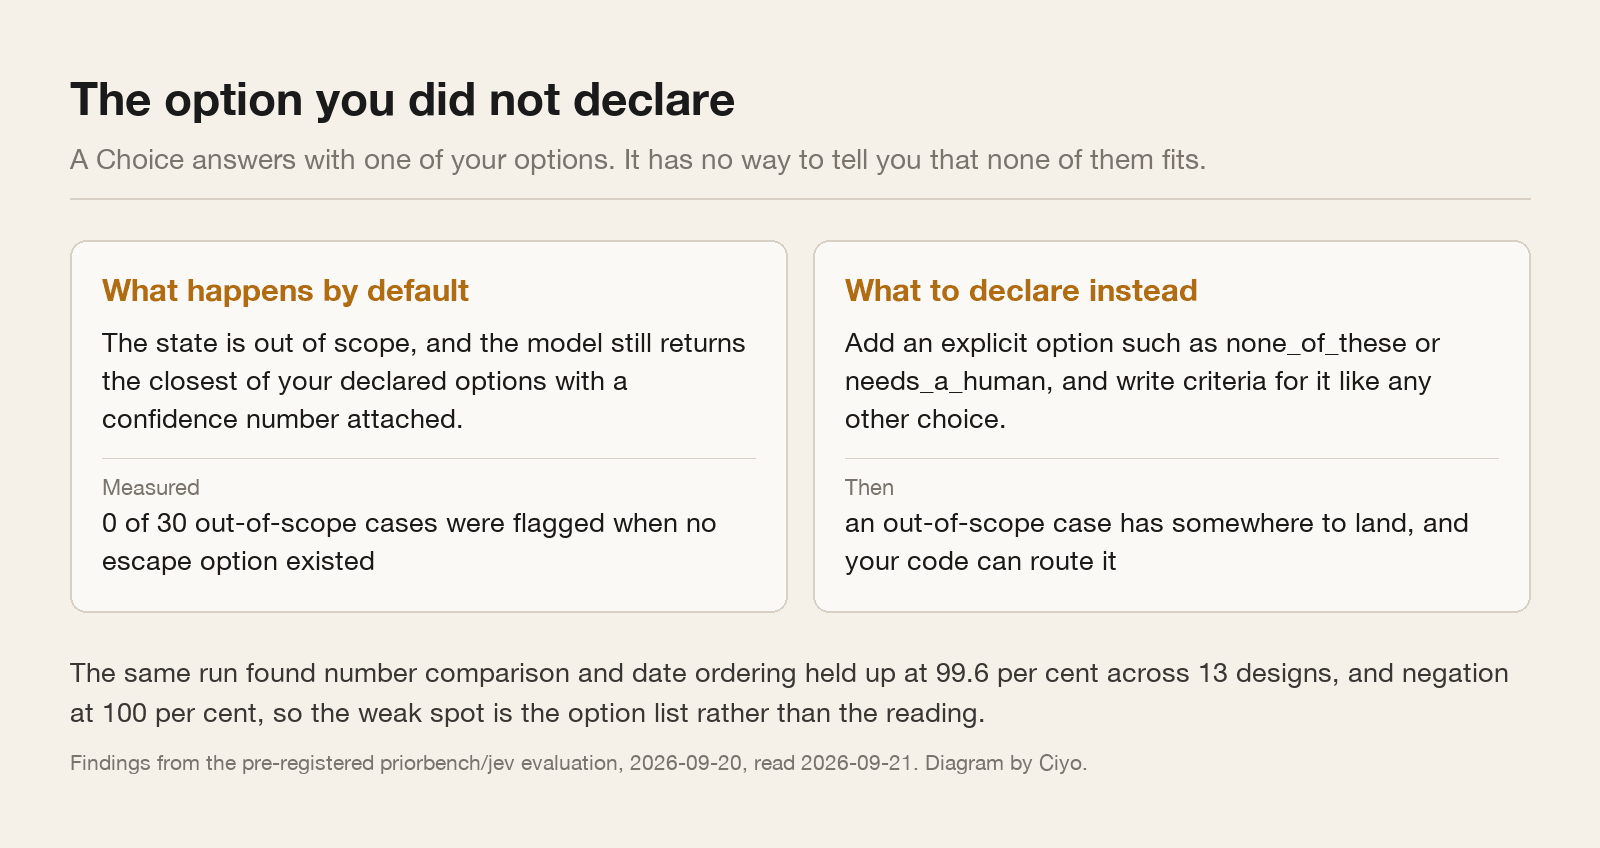
现在说一个更尖锐、也会改变设计的发现。在2026年9月20日发布的预先注册评价中,作者们测试了模型是否会示意某个 state 落到了声明选项之外。在30个不存在逃生选项的越界案例里,它没有标记其中任何一个。
那不是缺陷。那是类型系统正按宣传的那样运作:你声明了可能的答案,于是就返回了一个声明类型的值。但这意味着一个越界的输入不会响亮地失败。它安静地成功,附带最接近的选项和一个置信度的值。
修复只需一行问题设计。你自己声明逃生选项——`none_of_these`、`needs_a_human`、`not_applicable`——并像对待真正选项一样仔细地为它写标准。然后在代码里路由它。
同一项评价发现它擅长什么
值得把另一半也报告出来,因为围绕这些模型的民间说法,往往在令人安心的方向上错,在悲观的方向上也错。
同一项运行发现,数字比较和日期排序在13种不同的问题设计间保持在 99.6%,否定在 100% 的被测案例中都被正确处理。三天前发布的一份实践者指南曾警告说否定可能失灵,且模型不擅长算术和日期。那次更大规模、预先注册的运行没有重现这一点。
这对于2026年9月整个这个话题是个有用的提醒:围绕一个公开还不到一周的模型,大量言之凿凿的建议正在流传。优先选择附带方法和代码仓库的证据。
| 主张 | 来源 | 预先注册的运行发现了什么 |
|---|---|---|
| 不擅长算术和日期计算 | 一份实践者指南,2026-09-17 | 数字比较和日期排序在13种设计中保持在 99.6% |
| 否定可能失灵 | 同一份指南 | 否定在被测案例的 100% 中被正确处理 |
| 上下文腐化:准确率随无关 state 而下降 | 同一份指南 | 此处未被反驳;值得在你自己的 state 上测试 |
| 逐字读取指令 | 同一份指南 | 与越界发现一致:它回答的是你写下的那个问题 |
问题上线生产前的检查清单
它是否原子化?如果句子里含有「和」或「除非」,它很可能是两个问题。
选项是否详尽,包括一个逃生出口?如果一个看似合理的输入无处落脚,它会落到错误的地方。
每个选项都有标准吗?选项名是个标签;标准才是定义,而模型只拥有你写下的东西。
评分量表有序吗?Score 期望两到十个在序列中有意义的级别,而返回的评分可以落在它们之间。
你是否针对自己的标签测量过它?本文中的每个数字都来自别人的任务。
关于问题设计的问题
为什么拆分问题更好
每个问题都针对同一 state 孤立评估,所以窄问题就是窄任务。合并逻辑于是住在你的代码里,可被测试。一位实践者的运行在拆分后,于自己的标签上从 62.6% 提升到 95%。
多问问题会更贵吗
贵得极少。占主导的成本是你发送的 state;问题针对它并行评估。
如果一个输入不符合我的任何选项,会怎样
它无论如何都会得到最接近的选项。一项预先注册的评价发现,在未声明逃生选项时,30 个越界案例中有 0 个被标记。声明一个。
它在日期和否定上很弱吗
一份实践者指南在 2026年9月17日 这么说。三天后更大规模的预先注册运行测得,数字与日期排序为 99.6%,否定为 100%。与其相信任一方,不如在你自己的数据上测试。
继续阅读
Ciyo 撰写关于创意与智能体工具背后的模型,并测试那些它能运行的模型。