Modelos · System One
El suelo cuesta más que las preguntas
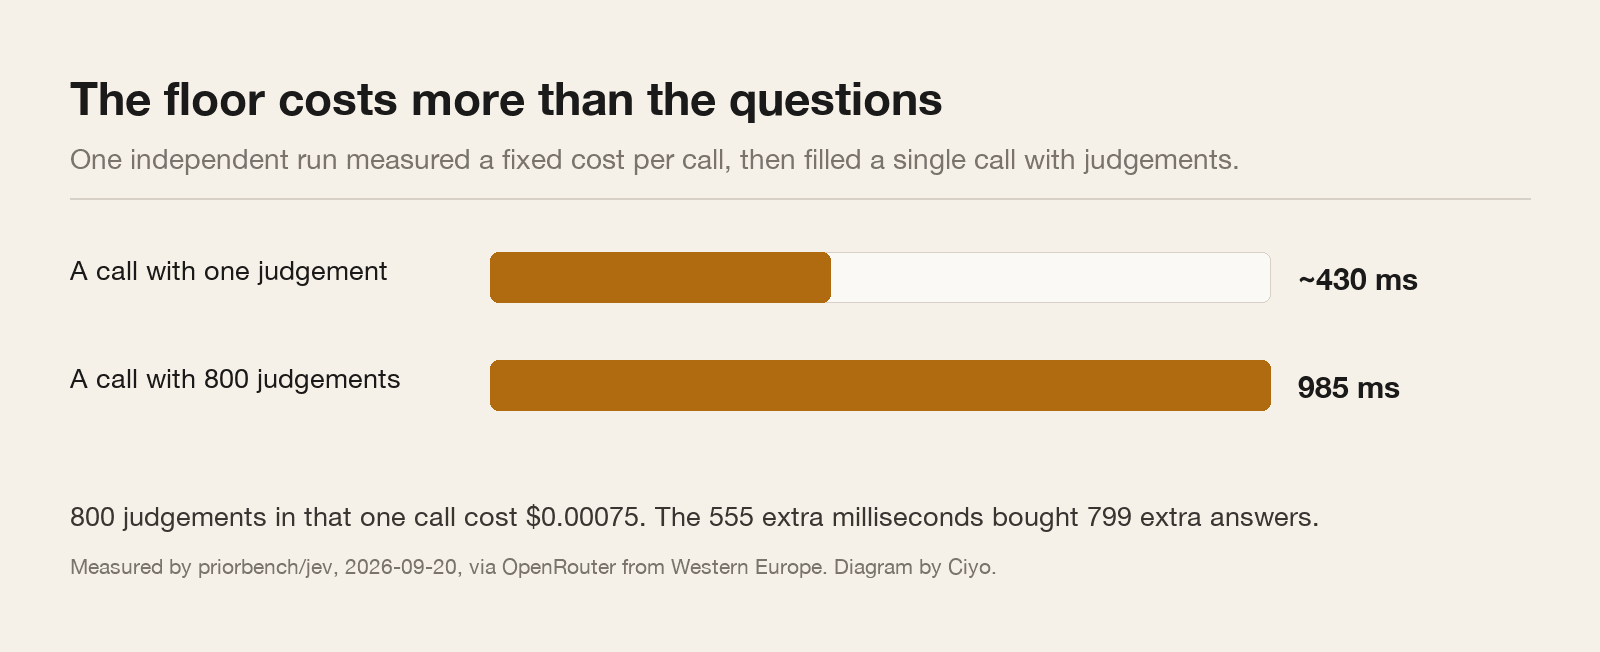
Toda llamada de red tiene un precio fijo que pagas antes de que ocurra cualquier trabajo. Por lo general es lo bastante pequeño para ignorarlo. Con un modelo que responde en decenas de milisegundos, deja de ser pequeño y empieza a ser la mayor parte de la factura.
Una evaluación independiente preregistrada de Jev, publicada el 20 de septiembre de 2026, midió ese suelo y luego probó qué pasa cuando llenas una sola llamada. Los números abogan por una forma específica de sistema, y no es la forma que la mayoría construye primero. Ciyo no ejecuta Jev — no genera imagen ni vídeo — así que esto es una lectura de mediciones publicadas, no una nota de producto.
Qué se midió
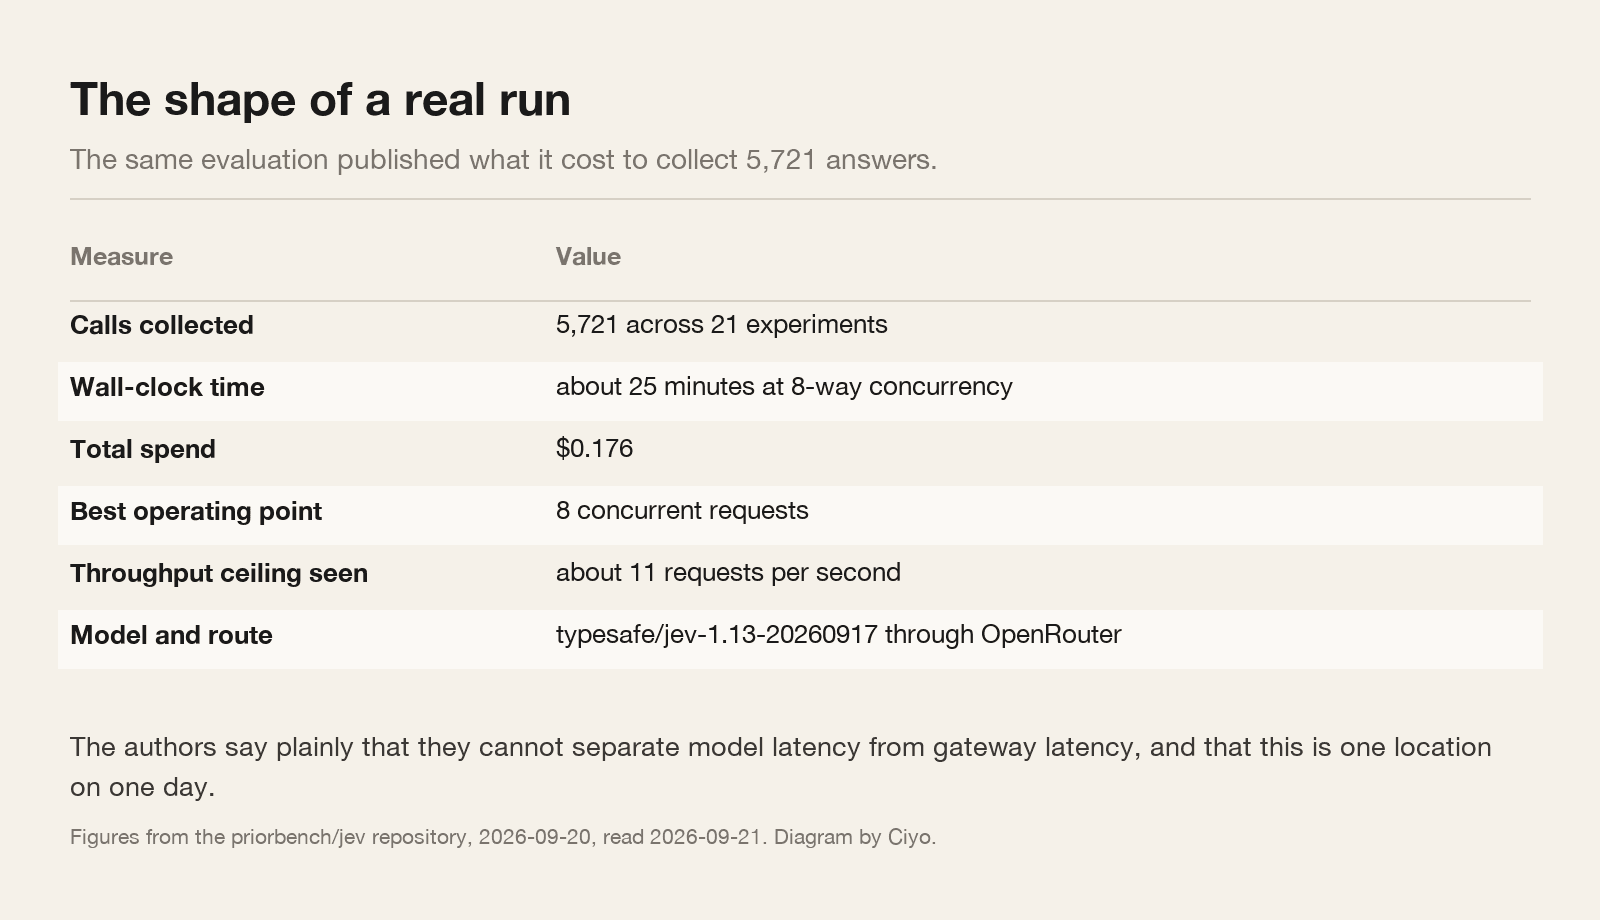
La evaluación recopiló 5,721 llamadas a lo largo de 21 experimentos, con 50 predicciones con marca de tiempo antes de que comenzara la recolección de datos. Ejecutó `typesafe/jev-1.13-20260917` a través de OpenRouter desde Europa occidental, y publicó sus datos en bruto.
Dos hallazgos impulsan todo lo demás. Hay un costo fijo de aproximadamente 430 milisegundos por llamada. Y 800 juicios tipados colocados en una sola llamada se completaron en 985 milisegundos, a un costo de 0.00075 dólares.
Júntalos y la aritmética es tajante. El primer juicio cuesta unos 430 milisegundos. Los 799 siguientes costaron unos 555 milisegundos entre todos, es decir, aproximadamente 0.7 milisegundos cada uno.
La propia salvedad de los autores, que importa aquí
Dicen claramente que no pueden separar la latencia del modelo de la latencia de la pasarela. Los 430 milisegundos están medidos; la afirmación de que es una propiedad del modelo y no de la ruta es una hipótesis, y lo dicen así. Cualquiera con acceso nativo a la API puede resolverlo rápidamente.
Esa salvedad no debilita el consejo de diseño. De lo que esté hecho el suelo, lo pagas una vez por llamada, así que llenar la llamada es la palanca de cualquier forma. Sí significa que deberías medir tu propio suelo desde tu propia región antes de construir un presupuesto de latencia sobre el número de otro.
También es una ubicación en un día, contra una versión del modelo. Trátalo como la forma de la cosa, no como una especificación.
A qué aboga esto
No construyas el bucle que envía un state y una pregunta, espera, y luego envía el siguiente. Ese diseño pasa casi todo su tiempo pagando el suelo una y otra vez.
De la misma medición se desprenden dos formas mejores. Despliega las preguntas: envía el state una vez con cada pregunta que quieras responder, incluidas las que probablemente descartarás, porque la pregunta marginal es casi gratis. Y agrupa los estados: si estás clasificando un retraso en lugar de reaccionar a un evento en vivo, pon muchos elementos en una llamada en lugar de muchas llamadas en un minuto.
La segunda forma tiene un límite que no es de latencia: una llamada que lleva 800 juicios lleva el equivalente a 800 juicios de state, y tienes que poder atribuir cada respuesta a su fila. Mantén tus ids de pregunta significativos y tu mapeo explícito.
Publicado 2026-09-21. Un desarrollador que trabaja en un diseño de triaje de correo señala que las primitivas se pueden usar en paralelo, que Score con umbrales y Choice no se comportan de manera idéntica en la misma tarea, y que los patrones documentados favorecen preguntar muchas preguntas — incluso las especulativas — en una sola llamada. Ese último punto es la misma conclusión a la que llega este artículo desde los datos de latencia.
Concurrencia, y dónde deja de ayudar
La misma ejecución miró el paralelismo entre llamadas en lugar de dentro de ellas. Encontró que 8 solicitudes concurrentes era el mejor punto de operación y que el rendimiento se saturaba en torno a 11 solicitudes por segundo.
Ese es un número pequeño, y vale la pena saberlo antes de diseñar un grupo de trabajadores de despliegue. Más allá de 8 en vuelo, la ejecución no hizo más trabajo; simplemente tuvo más solicitudes en espera. Las 5,721 llamadas tomaron unos 25 minutos en esa configuración, y costaron 0.176 dólares en total.
Si necesitas más de unas 11 solicitudes por segundo de esto, la respuesta de estos números no son más trabajadores. Son menos llamadas, más llenas.
Un presupuesto que realmente puedes anotar
Toma la forma de estos números y aplícala a una carga de trabajo real en lugar de a un benchmark. Digamos que quieres evaluar cada paso de cada ejecución de agente, y tienes 50,000 pasos al día con cuatro preguntas por paso.
Como una llamada por paso, eso son 50,000 llamadas, unas 6 horas de tiempo de reloj a la latencia y concurrencia medidas, y mucho agendamiento. Como llamadas agrupadas de, digamos, 200 pasos cada una, son 250 llamadas. El costo de tokens es el mismo de cualquier forma, porque envías el mismo state; lo que colapsa es el tiempo gastado en pagar el suelo.
Esa es toda la lección de diseño. Con esta clase de modelo, la pregunta que deberías hacer no es «qué tan rápida es una llamada» sino «cuánto puedo meter en una».
| Diseño | Llamadas por día | Suelo pagado por día |
|---|---|---|
| Una llamada por paso | 50,000 | unos 6 horas de costo fijo |
| 200 pasos agrupados por llamada | 250 | menos de 2 minutos de costo fijo |
| Los mismos tokens de cualquier forma | — | el state es lo que pagas |
Qué medir antes de comprometerte
Tu suelo, desde tu región, en tu ruta. Es un script y 20 minutos, y es el número en el que descansa tu presupuesto.
Tu techo por llamada. Sube el conteo de juicios hasta que se tuerza el tiempo de respuesta o la tasa de error, y quédate por debajo.
Tu atribución. Una llamada agrupada solo es útil si cada respuesta encuentra su camino de vuelta a la fila correcta, y esa es una clase de bug que merece una prueba en lugar de una esperanza.
Y tu propia precisión, porque nada de la velocidad importa si los juicios están mal. La velocidad es la razón para usar un modelo así; el acuerdo con tus propias etiquetas es la razón para mantenerlo.
Preguntas de rendimiento
¿Cuántos juicios caben en una llamada?
La documentación no publica tope de preguntas por solicitud. Una ejecución independiente colocó 800 en una sola llamada, que se completó en 985 milisegundos por 0.00075 dólares.
¿El suelo de 430 ms es del modelo o de la red?
Desconocido. Los autores midieron el suelo y dicen explícitamente que no pueden separar la latencia del modelo de la latencia de la pasarela en su ruta.
¿Cuántas solicitudes puedo ejecutar a la vez?
En esa ejecución, 8 solicitudes concurrentes era el mejor punto de operación y el rendimiento se saturó cerca de 11 por segundo. Mide el tuyo antes de dimensionar un grupo de trabajadores.
¿Cambia el agrupamiento el costo de tokens?
No. Pagas por el state que envías. El agrupamiento colapsa el costo fijo por llamada, no los tokens.
Sigue leyendo
Ciyo escribe sobre los modelos detrás de las herramientas creativas y de agentes, y prueba los que puede ejecutar.