Modelos de IA · Números
Las promesas de precio y velocidad de Jev, comprobadas
Todo lanzamiento llega con un multiplicador, y los de Jev son grandes: de 40 a 200 veces más rápido “con los mismos niveles de inteligencia de frontera”, entrada a $0.042 por millón de tokens y tokens de salida «FREE (too cheap to meter)» («GRATIS, demasiado barato para medirlo»).
Cinco días después hay exactamente una medición hecha fuera de la empresa. Este artículo pone las dos cosas una al lado de la otra, y ninguno de los dos resultados es el que esperarías por un hilo de lanzamiento.
Lo que publicó TypeSafe
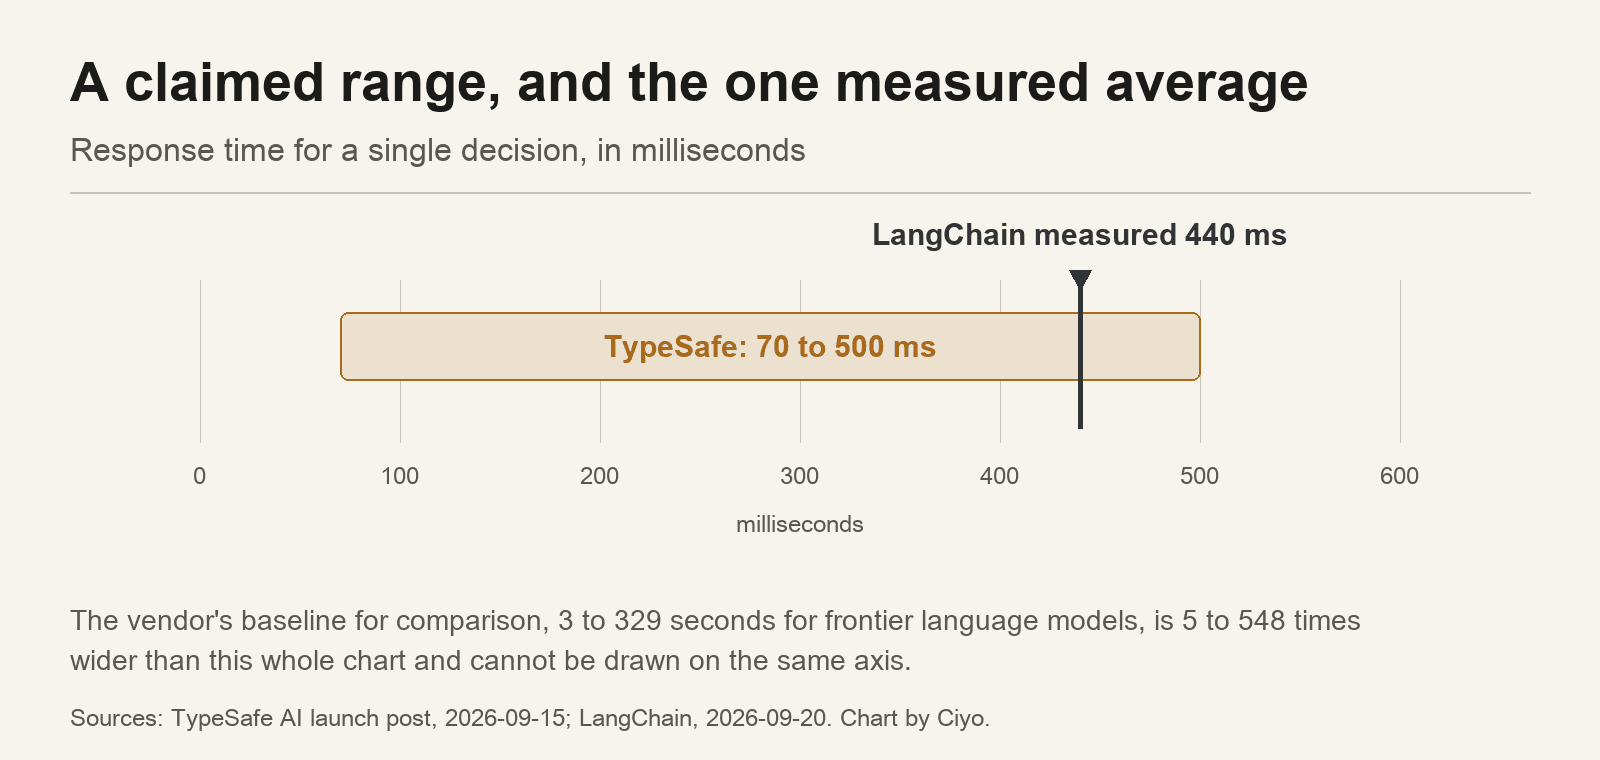
El anuncio de lanzamiento del 15 de septiembre de 2026 da un rango de latencia de 70 a 500 milisegundos frente a 3 a 329 segundos de los modelos de lenguaje de frontera, y de ahí sale la cifra de 40 a 200 veces. Añade 193.6 veces más rápido y 444.6 veces más barato en flujos de trabajo de producción, y cero alucinaciones con cero errores de tipo.
El precio es lo bastante inusual para decirlo dos veces: la entrada se mide por mil millones en lugar de por millón, y la salida es gratis. La cobertura de TechCrunch del 18 de septiembre recogió además cifras de clientes: Vercel medía de 5 a 18 veces más rápido y otro equipo, de 10 a 20 veces más barato que Gemini.
Todos esos números vienen de TypeSafe o de sus primeros clientes. Eso no hace que ninguno sea falso. Hace que todos estén sin verificar.
| Afirmación | Cifra | Fuente | ¿Independiente? |
|---|---|---|---|
| Latencia | De 70 a 500 ms, frente a 3 a 329 s | Anuncio de lanzamiento de TypeSafe | No |
| Velocidad en flujos de producción | 193.6 veces más rápido | Anuncio de lanzamiento de TypeSafe | No |
| Coste en flujos de producción | 444.6 veces más barato | Anuncio de lanzamiento de TypeSafe | No |
| Fiabilidad | Cero alucinaciones, cero errores de tipo | Anuncio de lanzamiento de TypeSafe | No |
| Precio | $0.042 por millón de tokens de entrada, salida gratis | Precios de TypeSafe | Publicado, no medido |
| Velocidad según un cliente | De 5 a 18 veces más rápido | Vercel, vía TechCrunch | No, lo informa el cliente |
Un rango prometido y la única media medida
El experimento de LangChain del 20 de septiembre informa de una media de 0.44 segundos por llamada. Ponla en el mismo eje que el rango del anuncio de lanzamiento y cae dentro, cerca del extremo lento: 440 milisegundos frente a un rango prometido de 70 a 500.
Las dos cosas son ciertas a la vez, y esa es la observación útil. El rango del fabricante no queda desmentido. El multiplicador del titular tampoco queda reproducido, porque un multiplicador es un cociente y el trabajo lo hace la referencia. Frente a un modelo de frontera que tarda tres segundos, 440 milisegundos es unas siete veces más rápido, no doscientas.
Lo que costó la misma ejecución
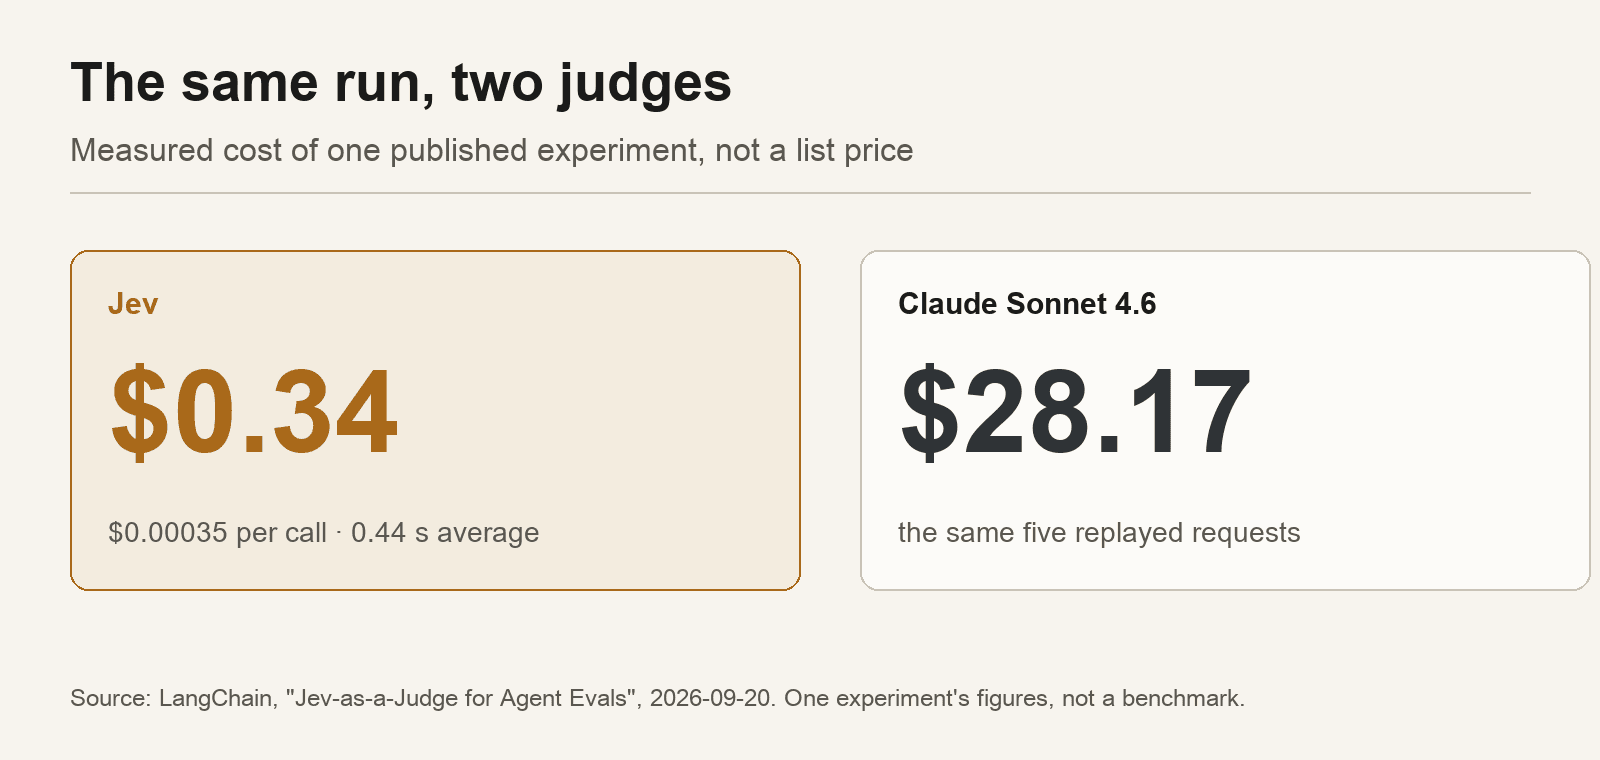
La comparación de coste es menos ambigua. En el experimento de LangChain, un juicio de Jev costó $0.00035 y la ejecución completa de juicios repetidos llegó a $0.34. La misma ejecución con Claude Sonnet 4.6 llegó a $28.17, una diferencia de unas 83 veces.
Ochenta y tres no es cuatrocientos cuarenta y cuatro. Pero es más que suficiente para cambiar lo que hace un equipo: a un tercio de dólar por pasada de evaluación, dejas de elegir entre cobertura y presupuesto y empiezas a ejecutar el juez sobre todas las trazas en lugar de sobre una muestra.
Publicado el 2026-09-20 por Daniel Shea y Seán Roche, con un repositorio público y versiones fijadas. LangChain hizo una retransmisión en directo con TypeSafe dos días después.
Lee las advertencias junto con los números
LangChain anotó sus propias limitaciones, que es la señal de una prueba que merece la pena leer. El experimento está construido sobre cinco consultas meteorológicas reproducidas en un único agente. El resultado de varianza se describe como observacional, no como prueba de que lo causara el objetivo de entrenamiento. Y avisan de que un coste bajo puede amplificar los errores, porque un evaluador consistentemente equivocado produce retroalimentación mala a escala.
También fijaron las versiones y publicaron el repositorio, así que la ejecución se puede repetir. Esa es la diferencia entre una prueba de referencia y una fanfarronada, y es más rara de lo que debería cinco días después de un lanzamiento.
Por qué los tokens de salida gratis importan más que el multiplicador
Un modelo System One devuelve un valor tipado, no un párrafo, así que su salida es minúscula por construcción. No cobrar nada por ella es menos un descuento que admitir que casi no hay nada que cobrar. El número que importa es el precio de la entrada, que es donde cae una traza larga.
TechCrunch recurrió a la paradoja de Jevons para describir lo que viene después, y la analogía encaja exactamente con el caso de la evaluación: cuando un juicio se vuelve tan barato que deja de contarse, los equipos no gastan menos. Juzgan mucho más, en más dimensiones y más a menudo. El presupuesto pasa de decidir si evaluar a decidir qué hacer con toda esa retroalimentación.
Cómo comprobar el próximo lanzamiento
Busca la fuente primaria y su fecha antes de repetir un número. Pregunta quién hizo la prueba y qué relación tiene con el fabricante. Busca el método: cuántas repeticiones, contra qué referencia y en qué tarea. Después pregúntate si la tarea de la prueba se parece a la que ejecutas tú, porque un modelo puede ser excelente puntuando respuestas meteorológicas y no estar probado en todo lo demás.
Por último, comprueba la disponibilidad. Jev no tiene pesos abiertos, está detrás de una lista de espera de acceso anticipado y llega a la mayoría de la gente a través de infraestructura como el AI Gateway de Cloudflare. Un número sobre el que no puedes actuar es trivia.
Preguntas sobre los números
¿Jev es de verdad de 40 a 200 veces más rápido?
Esa es la cifra de TypeSafe para clasificación frente a modelos de lenguaje de frontera. La única medición publicada fuera de la empresa es una media de 0.44 segundos por llamada, que cae dentro del rango prometido de 70 a 500 milisegundos, cerca de su extremo lento.
¿Cuánto cuesta una llamada?
TypeSafe indica $0.042 por millón de tokens de entrada con la salida gratis. LangChain midió $0.00035 por llamada y $0.34 por una ejecución que costó $28.17 con Claude Sonnet 4.6.
¿Alguien lo ha evaluado a fondo?
Todavía no. Hay un experimento estrecho con un repositorio publicado y versiones fijadas, hecho por una empresa que organizó una retransmisión en directo con el fabricante dos días después.
Sigue leyendo
Ciyo escribe sobre los modelos que hay detrás de las herramientas creativas y de agentes, y prueba los que puede ejecutar.