模型 · System One
地板比问题更贵
每次网络调用都有一个在任何工作发生之前就要支付的固定价格。通常它小到可以忽略。但当一个模型在几十毫秒内就能回答时,它不再小,而变成了账单的大部分。
一项于2026年9月20日发布的、预先注册的 Jev 独立评测,测量了这块地板,然后测试了填满一次调用时会发生什么。这些数字支持一种特定的系统形态,而那不是多数人最先构建的形态。Ciyo 不运行 Jev——它不生成图像,也不生成视频——所以这是一篇对公开测量的解读,而非产品说明。
测量了什么
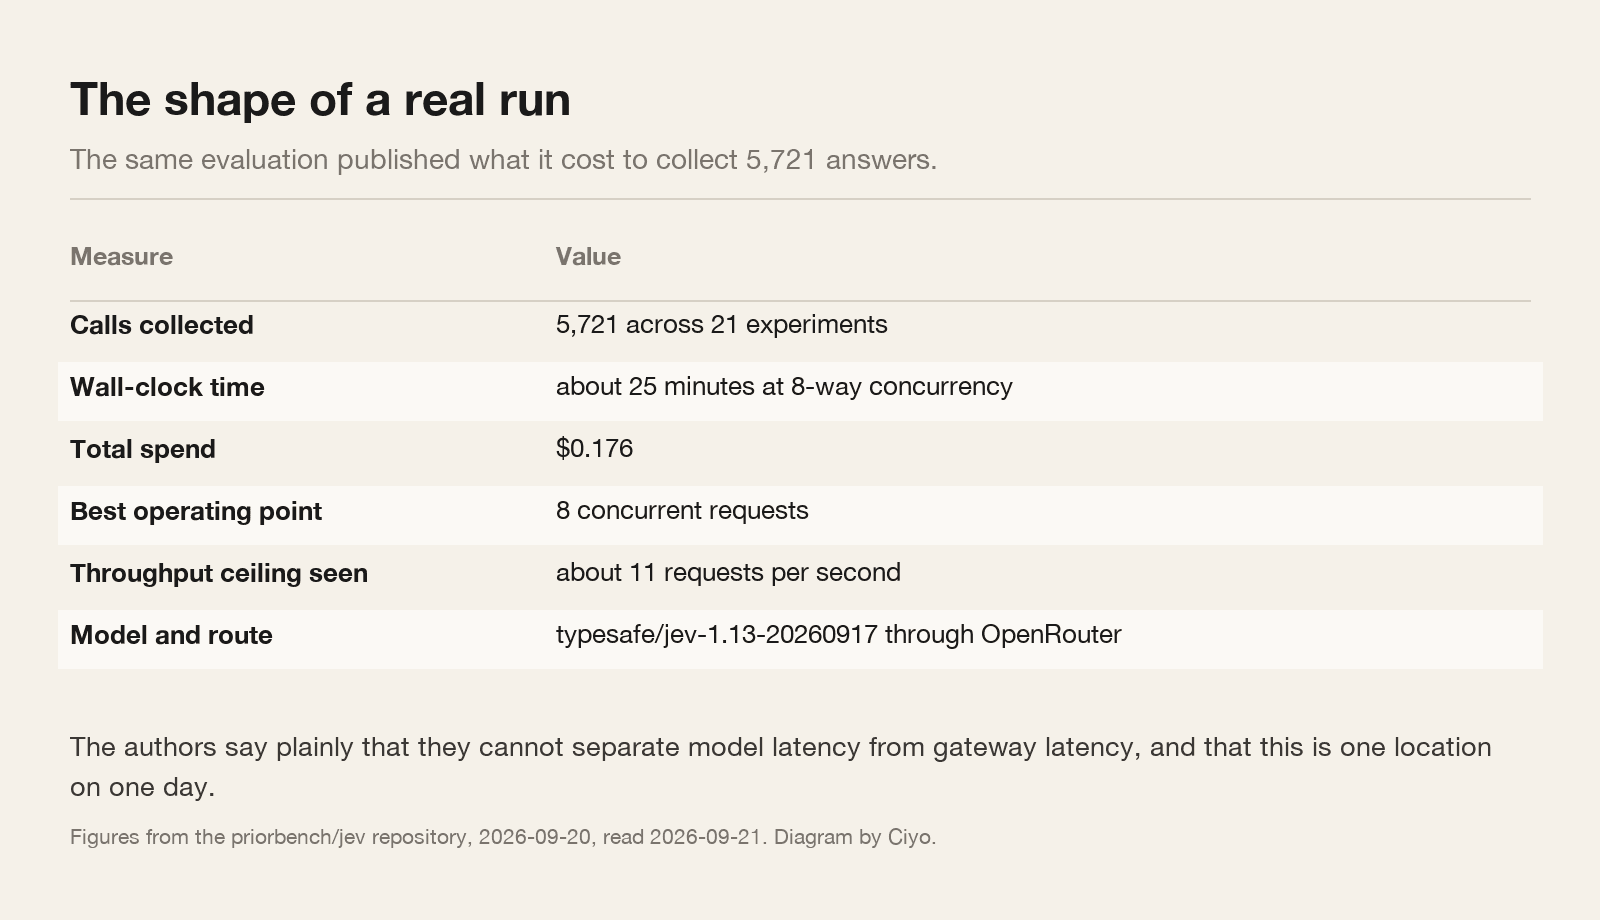
该评测在 21 项实验中收集了 5,721 次调用,并在数据收集开始前对 50 个预测打了时间戳。它通过 OpenRouter 从西欧运行了 `typesafe/jev-1.13-20260917`,并公开了原始数据。
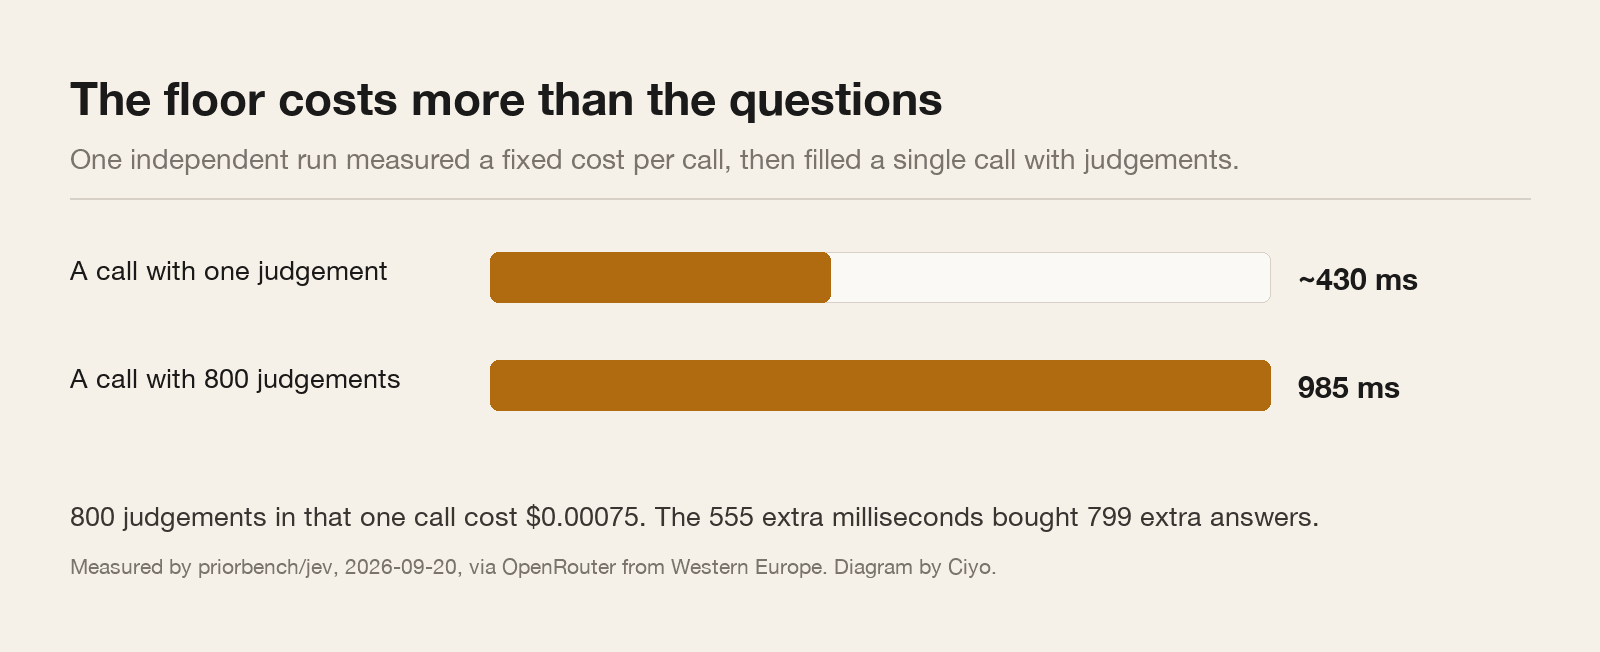
两个发现驱动了其余一切。每次调用有约 430 毫秒的固定成本。把 800 个类型化判定放进一次调用,在 985 毫秒内完成,成本为 0.00075 美元。
把这两点合起来,算术就很刺眼。第一个判定花费约 430 毫秒。其后 799 个合计花费约 555 毫秒,也就是每个约 0.7 毫秒。
作者自己的保留意见,而这很关键
他们明说,无法把模型延迟从网关延迟中分离出来。430 毫秒是测量值;而「它是模型的属性而非路由的属性」这一说法只是假设,他们也这么说。任何拥有原生 API 访问权限的人都能很快判定。
这个保留意见并不会削弱设计建议。无论地板由什么构成,你每次调用只付一次,所以填满调用在两种情况下都是那个杠杆。但它确实意味着,在拿别人的数字搭建延迟预算之前,你应该从自己的地域测量自己的地板。
它也只是一个地点、一天、针对一个模型版本。把它当作事物的形态,而非一份规格。
这支持什么
不要构建那种发送一个 state 和一个问题、等待、再发送下一个的循环。那种设计几乎把所有时间都花在反复支付地板上。
从同一测量中得出两种更好的形态。把问题摊开:把 state 发一次,带上你可能想要答案的每一个问题,包括你很可能会丢弃的那些,因为边际问题近乎免费。再把状态批处理:如果你是在分类积压工作而非响应实时事件,就把许多条目放进一次调用,而不是在一分钟内发起许多次调用。
第二种形态有一个与延迟无关的限度:一次携带 800 个判定的调用,携带的是 800 个判定份量的 state,而你必须能把每个答案归因回它的那一行。让你的问题标识有意义,让你的映射显式。
发布于 2026-09-21。一位正在做邮件分流设计的开发者指出,这些原语可以并行使用,带阈值的 Score 和 Choice 在同一任务上表现并不一致,而且文档化的模式倾向于在一次调用里问很多问题——甚至是猜测性的那些。最后这一点,正是本文从延迟数据得出的相同结论。
并发,以及它在何处不再有帮助
同一运行考察的是调用之间的并行,而非调用之内。它发现 8 个并发请求是最佳工作点,吞吐量在约 11 个请求每秒时饱和。
这是个很小的数字,在你设计扇出工作池之前值得知道。超过 8 个在途请求后,运行没有完成更多工作;只是有了更多排队的请求。那 5,721 次调用在该设置下花了约 25 分钟,总成本 0.176 美元。
如果你需要的不只是约 11 个请求每秒,这些数字给出的答案不是更多的工作线程,而是更少、更满的调用。
一份你真正能写下来的预算
取这些数字的形状,把它用到真实工作负载上,而不是用到基准测试上。假设你想评估每一次智能体运行的每一步,而你每天有 50,000 步,每步四个问题。
若每步一次调用,那就是 50,000 次调用,在测得的地板和并发下约 6 小时的挂钟时间,以及大量调度。若每批比如说 200 步一批地批量调用,则是 250 次调用。令牌成本两种方式相同,因为你发送的是同一个 state;崩塌掉的是支付地板所花的时间。
这就是整个设计教训。对这类模型,你该问的问题不是「一次调用有多快」,而是「我一次能塞进多少」。
| 设计 | 每天调用次数 | 每天支付的地板 |
|---|---|---|
| 每步一次调用 | 50,000 | 约 6 小时的固定成本 |
| 每次调用批量 200 步 | 250 | 低于 2 分钟的固定成本 |
| 两种方式令牌相同 | — | 你付钱买的是 state |
在承诺前该测量什么
你的地板,来自你的地域,走你的路由。它是一段脚本和 20 分钟,它是你预算所依赖的那个数字。
你每次调用的天花板。把判定数往上推,直到响应时间或错误率拐弯,然后待在它下面。
你的归因。批量调用只有在每个答案都能回到正确的那一行时才有用,而那是一类值得写测试、而不是靠碰运气的缺陷。
还有你自己的准确率,因为如果判定错了,速度就毫无意义。速度是用这类模型的原因;与你自己标签的一致,是留住它的原因。
吞吐量的问题
一次调用能塞进多少判定
文档没有公布每次请求的提问上限。一次独立运行把 800 个放进一次调用,在 985 毫秒内完成,花费 0.00075 美元。
430 毫秒的地板是模型还是网络
未知。作者们测量了地板,并明确说他们无法在自己的路由上把模型延迟与网关延迟分离开。
我一次能跑多少个请求
在那次运行中,8 个并发请求是最佳工作点,吞吐量在约 11 个每秒时饱和。在给工作池定规模前,先测你自己的。
批处理会改变令牌成本吗
不会。你为发送的 state 付费。批处理压扁的是每次调用的固定成本,不是令牌。
继续阅读
Ciyo 撰写关于创意与智能体工具背后的模型,并测试那些它能运行的模型。