Modelos de IA · Explicación
Modelos System One: qué hace Jev en realidad
TypeSafe AI lanzó Jev el 15 de septiembre de 2026 y lo presentó como el primero de una clase nueva: un modelo System One, “una nueva clase de modelos de frontera creados para tomar decisiones rápidas y estructuradas que el software puede usar directamente”.
La forma más fácil de malinterpretar esa frase es entender «modelo de lenguaje pequeño». Jev no es un modelo de lenguaje. No genera texto, no puede escribir tu pie de foto y nunca responderá a una pregunta abierta. Renuncia a generar cadenas de texto a propósito, y todo lo interesante que tiene viene de ese intercambio.
Una clase nueva, y aquello a lo que renuncia
Un modelo de lenguaje autorregresivo muestrea un token cada vez, cada uno condicionado por el anterior, y te entrega una cadena de texto. La estructura que tenga esa cadena es una convención que el modelo ha aprendido a imitar, y por eso todo sistema en producción que necesita un valor de un modelo acaba con un analizador sintáctico, un validador de esquema y un reintento.
Un modelo System One elimina esa capa invirtiendo el orden. Declaras primero las salidas posibles y después das al modelo un estado estructurado y una pregunta tipada. Lo que vuelve es un valor del tipo que declaraste, con las probabilidades de todas las respuestas posibles y una puntuación de confianza adjunta.
El precio es total: sin prosa, sin código, sin respuestas abiertas. TypeSafe lo plantea como una decisión de arquitectura deliberada más que como una limitación, y el nombre lo dice todo. System One es el juicio rápido y automático; System Two es la deliberación. Jev es solo el primero.
| Aspecto | Modelo de lenguaje autorregresivo | Modelo System One |
|---|---|---|
| Muestreo | Un token cada vez, cada uno condicionado por el anterior | Todas las salidas en una única consulta paralela |
| Salida | Una cadena de texto, con la estructura que haya aprendido a imitar | Un valor estructurado y tipado, declarado de antemano |
| Incertidumbre | Insinuada por la redacción, si acaso | Probabilidades de todas las respuestas, más una puntuación de confianza |
| Entrenamiento | RLHF, optimizado para una respuesta preferida | RLCD, descrito como optimizado para decisiones calibradas |
| Renuncia a | A nada, en principio | A generar texto por completo |
Dos maneras de responder a la misma pregunta
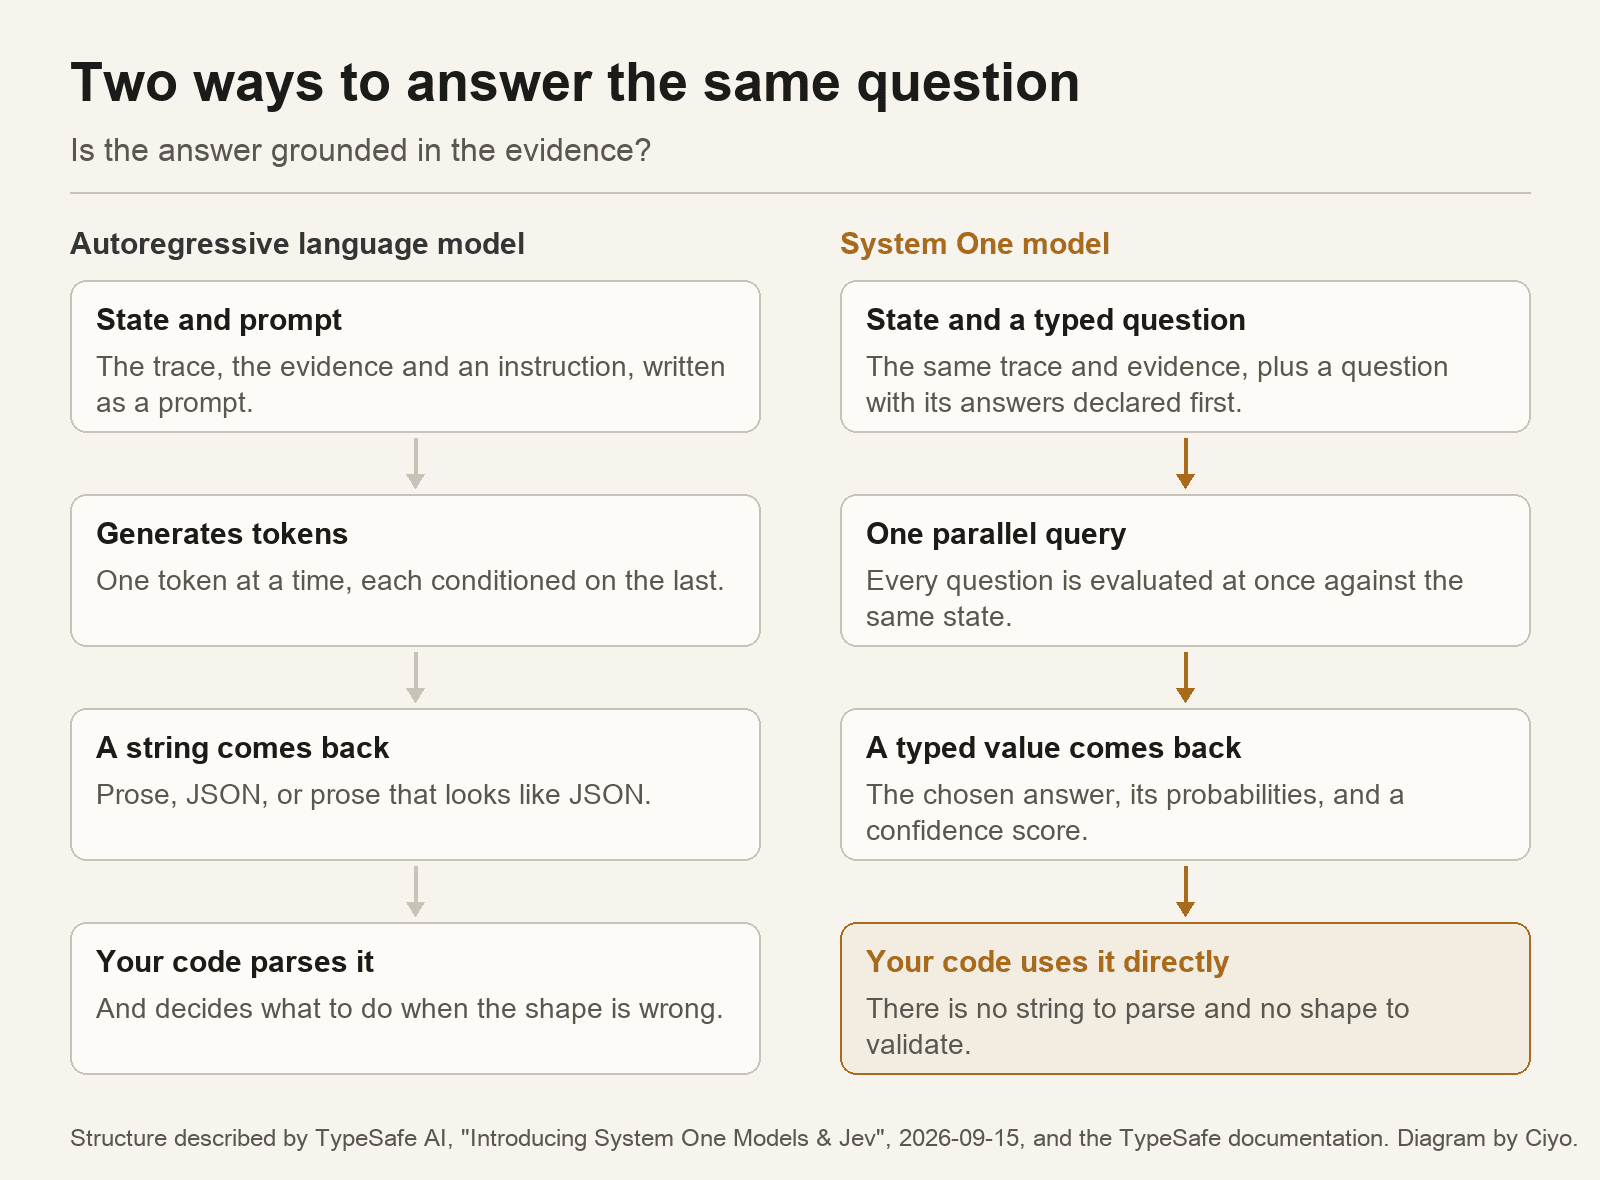
Toma una pregunta concreta que un agente se hace constantemente: ¿esta respuesta está fundamentada en las pruebas que ha recuperado? Los dos tipos de modelo pueden responderla. Llegan por caminos distintos, y el camino es toda la historia.
El camino de la izquierda resulta familiar. El de la derecha no produce ninguna cadena de texto, así que no hay nada que analizar, nada que validar y ninguna clase de fallo en la que el modelo escriba una frase perfectamente razonable en lugar del campo que esperaba tu código.
Preguntas atómicas, compuestas en código
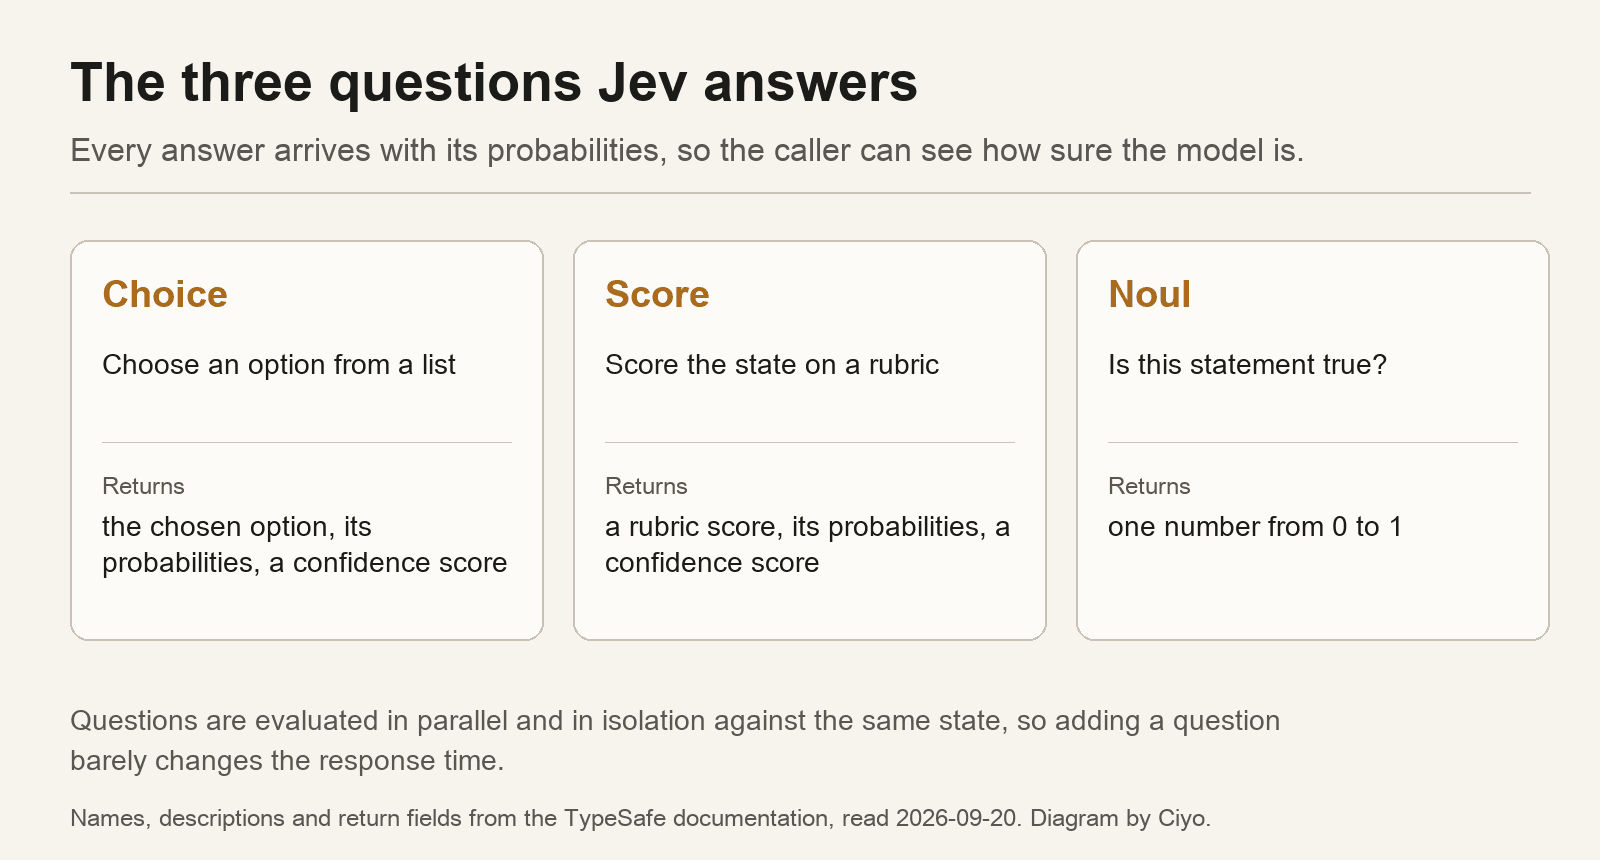
La documentación expone tres primitivas y nada más. Choice elige una opción de una lista y devuelve la opción elegida, las probabilidades de todas ellas y una puntuación de confianza. Score valora el estado frente a una rúbrica y devuelve esos mismos tres campos, con una puntuación en lugar de la elección. Noul responde si una afirmación es verdadera y devuelve un único número entre 0 y 1.
La regla de composición es la parte que el personal de ingeniería suele subestimar. Todas las preguntas se evalúan en paralelo y de forma aislada contra el mismo estado, de una sola vez, así que hacer doce preguntas sobre una misma traza no son doce viajes de ida y vuelta. La documentación lo dice sin rodeos: añadir preguntas apenas cambia el tiempo de respuesta.
Eso convierte la evaluación en algo que escribes en código normal. En lugar de un prompt largo que pide a un modelo que sopese varias cosas a la vez y responda en JSON, haces varias preguntas pequeñas con respuestas declaradas y combinas los resultados tú, donde puedes verlos.
Por qué la afirmación sobre las alucinaciones es más estrecha de lo que parece
TypeSafe dice que un modelo System One “no puede alucinar”. Léelo como una afirmación sobre tipos, no sobre la verdad. Como las salidas posibles y su estructura están definidas de antemano, el modelo no puede devolver una categoría que no declaraste, un objeto mal formado ni una frase segura sobre un documento que no existe. Esa clase de error desaparece por construcción.
Lo que queda es el error de toda la vida. Un Choice puede elegir la opción equivocada de tu lista. Un Score puede puntuar alto una respuesta mala. El modelo te dirá cuánta seguridad tiene, y TypeSafe describe esas probabilidades como calibradas y “epistémicamente honestas”, pero un 0.7 calibrado sigue estando mal tres de cada diez veces.
Por eso el valor de confianza forma parte de la interfaz y no es un adorno. Las personas desarrolladoras citadas en la cobertura de TechCrunch del 18 de septiembre describían justo ese cambio: el número es tuyo para interpretarlo, y decidir qué hacer con un 0.55 pasa a ser tu problema de diseño y no del modelo.
Cómo se entrenó, hasta donde se ha contado
TypeSafe llama a su método Reinforcement Learning for Calibrated Decisions, o RLCD, y lo sitúa frente al RLHF que dio forma a los modelos de chat. Mientras que RLHF optimiza para una respuesta que una persona prefiere, RLCD se describe como una optimización para que las probabilidades signifiquen lo que dicen.
Más allá del nombre y del contrato de salida, la arquitectura no es pública. TechCrunch señaló que su fundador fue parco al respecto, y el modelo no tiene pesos abiertos. Quien te explique cómo funciona Jev por dentro está razonando a partir de la forma de su API, no de un artículo científico.
Dónde se ejecuta hoy
El acceso es una lista de espera de acceso anticipado, con una consola y documentación en typesafe.ai. La página del proveedor TypeSafe en OpenRouter lista jev-latest y jev-1.13 con un contexto de 32,000 tokens, pero esas entradas no aparecen en la lista pública de modelos de OpenRouter, así que la vía está restringida más que abierta.
La noticia de distribución más reveladora es la de infraestructura. El 17 de septiembre de 2026, Cloudflare anunció que Jev estaba disponible en su AI Gateway, descrito exactamente con el vocabulario que usa el modelo: envía estado y preguntas tipadas y recibe respuestas estructuradas que tu código puede usar directamente. Así es como un modelo de este tipo llega a la mayoría de la gente: no como una aplicación, sino como una llamada dentro de algo que ya ejecutas.
Publicado el 2026-09-17. Un proveedor anunciando su propia integración: prueba de disponibilidad, no de rendimiento.
Preguntas sobre los modelos System One
¿Jev es un modelo de lenguaje pequeño?
No. No es autorregresivo y no genera texto. Evalúa una pregunta tipada contra un estado estructurado y devuelve un valor del tipo declarado con probabilidades y una puntuación de confianza.
¿Qué cubre en realidad «no puede alucinar»?
La forma de la salida. El modelo no puede devolver una categoría que no declaraste ni un objeto mal formado. Sí puede elegir la opción equivocada, y por eso el valor de confianza acompaña a cada respuesta.
¿Puedo probarlo hoy?
Solo a través de la lista de espera de acceso anticipado, la consola de TypeSafe o una integración como el AI Gateway de Cloudflare. No hay pesos abiertos, y la ficha de OpenRouter no está en su API pública de modelos.
Sigue leyendo
Ciyo escribe sobre los modelos que hay detrás de las herramientas creativas y de agentes, y prueba los que puede ejecutar.