Modelos · System One
¿Puedes enrutar según la puntuación de confianza de Jev?
Un modelo de decisión que devuelve una respuesta es útil. Un modelo de decisión que devuelve una respuesta más un número fiable que describe qué tan seguro está puede conectarse a un sistema que sabe cuándo parar y preguntar a una persona.
Esa es toda la promesa de un valor de confianza calibrado, y también es la afirmación que más vale comprobar, porque un número de confianza que no sigue la realidad es peor que no tener ningún número: le dice a tu código que continúe. Dos evaluaciones independientes publicaron sus datos en la semana del 17 de septiembre de 2026, y entre ambas responden la pregunta mejor de lo que podría ninguna página de proveedor. Ciyo no ejecuta Jev; esto es una lectura de evidencias publicadas.
La confianza no es la probabilidad
Una respuesta Choice vuelve con dos números distintos, y confundirlos es el primer error. Las probabilidades describen la distribución entre tus opciones declaradas: cómo se reparte la creencia del modelo. El valor de confianza es un escalar aparte que describe qué tan seguro está el modelo de la respuesta en absoluto.
La propia documentación de TypeSafe lo enmarca como un segundo eje: la respuesta te dice qué, y la confianza te dice si actuar. Ese enmarcado es la razón por la que vale un artículo entero. Puedes construir un sistema donde la respuesta elige la rama y la confianza elige si un humano la ve primero.
El patrón documentado liga el umbral al radio de impacto
TypeSafe publica un patrón de enrutamiento por confianza, y lo útil es que no da un solo número. Da una escalera ligada a qué tan malo es equivocarse.
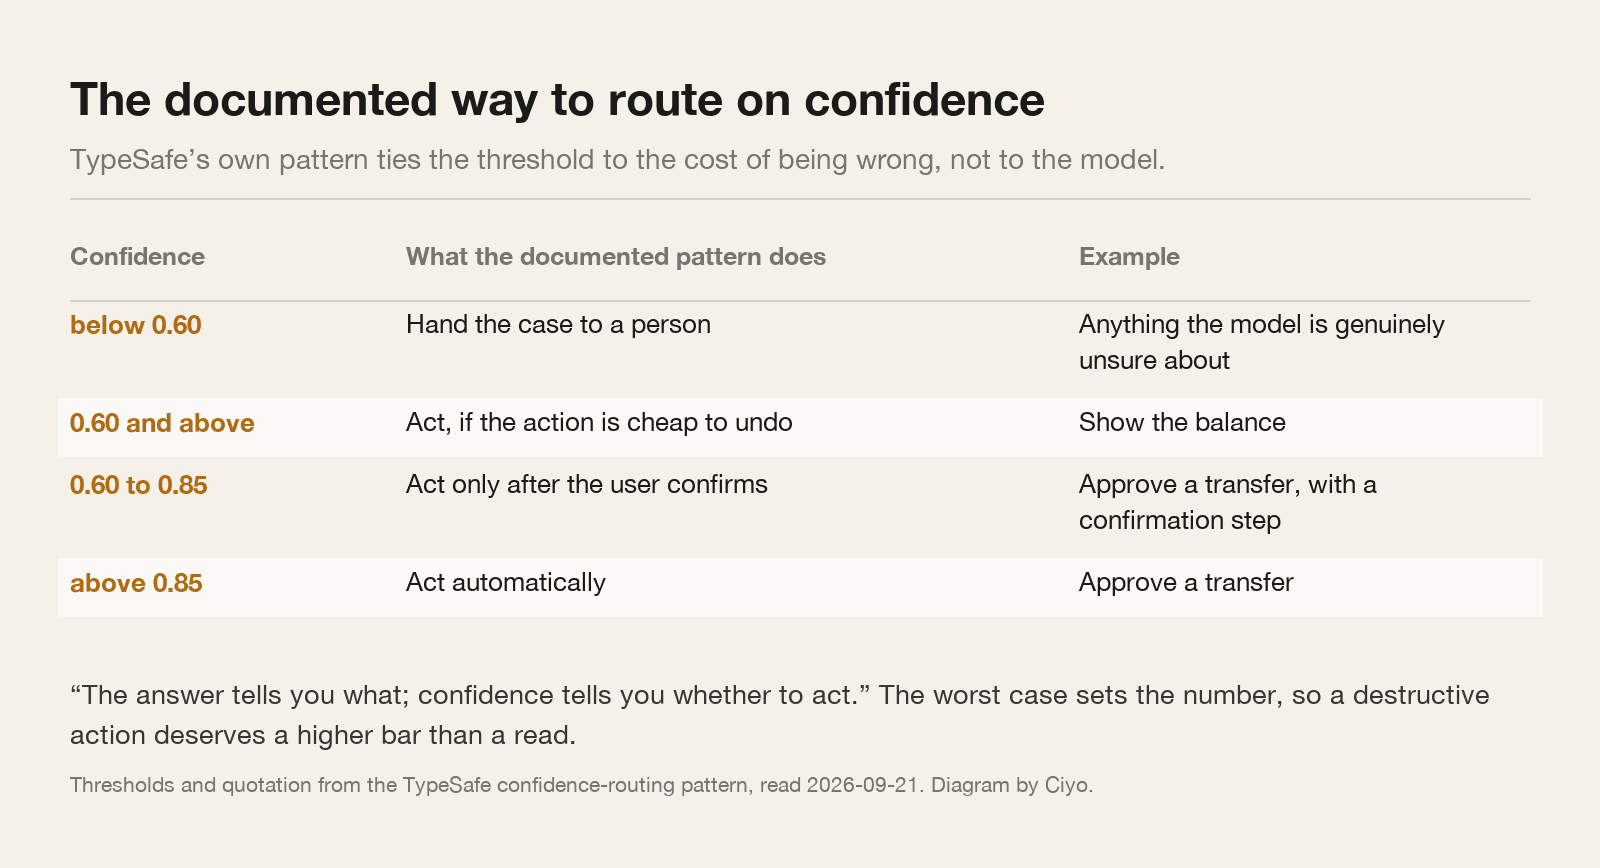
Por debajo de 0.6, pasa el caso a una persona. Por encima de 0.6, actúa — pero solo si la acción es barata. Para una acción costosa o irreversible, pide al usuario confirmar entre 0.6 y 0.85 y actúa automáticamente solo por encima de 0.85. En su ejemplo trabajado, mostrar un saldo de cuenta se aprueba a 0.6 mientras aprobar una transferencia no se aprueba hasta 0.85.
Este es un valor por defecto mejor que cualquier umbral global único, porque te hace anotar qué cuesta la acción. La mayoría de los equipos descubren, al hacerlo, que han estado ejecutando varias acciones muy distintas desde una sola rama.
Lo que midieron dos ejecuciones independientes
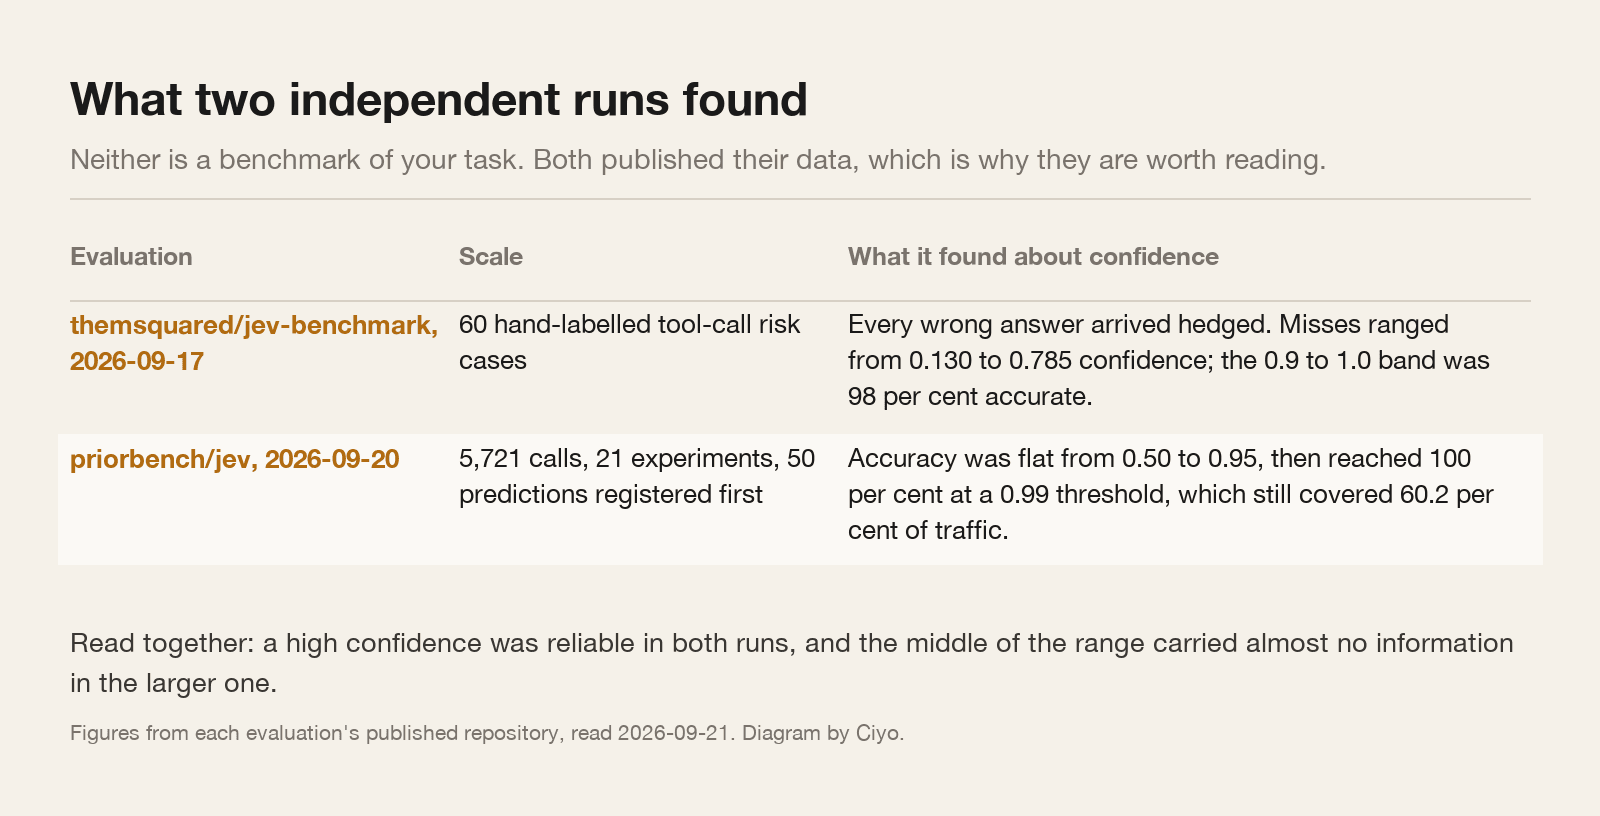
La primera es pequeña y concreta. El 17 de septiembre de 2026 un benchmark reproducible clasificó 60 llamadas de herramienta de agente etiquetadas a mano en cuatro categorías de riesgo, repartidas entre casos claros, ambiguos y adversariales. La precisión global fue 91.7 por ciento — 100 por ciento en los casos claros, 71.4 por ciento en los ambiguos. El hallazgo que importa aquí: cada respuesta incorrecta llegó matizada. Los fallos llevaron confianza entre 0.130 y 0.785, el modelo nunca devolvió confianza máxima estando equivocado, y la banda de 0.9-1.0 fue 98 por ciento precisa.
La segunda es mayor y preregistrada. El 20 de septiembre de 2026 una evaluación publicó 5,721 llamadas en 21 experimentos, con 50 predicciones con marca de tiempo antes de recoger ningún dato. De esas predicciones, 26 se confirmaron y 21 se falsificaron, 18 de ellas porque los autores esperaban un fallo donde no apareció ninguno. En calibración encontró la precisión esencialmente plana entre 0.50 y 0.95, alcanzando luego 100 por ciento en un umbral 0.99 que aún cubría 60.2 por ciento del tráfico.
Leídas juntas, dicen algo más preciso que «la confianza es buena». La confianza alta fue fiable en ambas. El centro del rango llevó muy poca información en la mayor.
Qué significa eso para tu umbral
Si la precisión es plana de 0.5 a 0.95, entonces un umbral de 0.7 y un umbral de 0.9 te compran más o menos lo mismo en esa tarea, y los rechazos extra a 0.9 son sobre todo tiempo humano desperdiciado.
La banda interesante es la superior. Una compuerta de 0.99 que aún maneja automáticamente 60 por ciento del tráfico con precisión completa es un punto de operación genuinamente útil: tres quintos del trabajo corren intactos y el resto llega a una persona. Ese es un diseño de sistema distinto de «enruta el 5 por ciento inferior a un humano».
Pero esta es una tarea en un día, y no es la tuya. El número en el que actuar es el que midas en tu propio conjunto etiquetado.
| Qué se encontró | Qué respalda | Qué no respalda |
|---|---|---|
| Toda respuesta incorrecta estaba matizada, n = 60 | Tratar una respuesta de confianza máxima como segura en esa tarea | Una garantía de que nunca falla con confianza en la tuya |
| Precisión plana de 0.50 a 0.95 | Sospechar que un umbral de rango medio compra poco | Una afirmación de que la confianza es inútil por debajo de 0.99 |
| 100 por ciento en 0.99, cubriendo 60.2 por ciento | Diseñar una política de escalado de compuerta alta y cobertura alta | La misma cobertura en una tarea o distribución distinta |
Medir tu propia curva, en una tarde
Necesitas un conjunto etiquetado, y si no lo tienes este es el momento en que descubres que lo necesitabas de todos modos. Doscientas filas que ya hayas juzgado bastan para ser interesante.
Envía cada fila, conserva la respuesta y la confianza, luego agrupa por confianza y calcula la precisión por grupo. Esa tabla es tu curva de calibración. Elige el umbral más bajo cuya precisión baste para el coste de esa acción, y enruta todo lo que esté por debajo a una persona.
Luego vuelve a ejecutarlo cuando cambies el redactado de la pregunta, porque has cambiado la tarea del modelo, y la curva que mediste pertenecía a la anterior.
Publicado 2026-09-21, citando un post de la compañía de sistemas de predicción Yarrow. La definición de calibración del autor — cuando un modelo dice 70 por ciento, el evento debe ocurrir 70 por ciento de las veces — es la estándar y es por lo que vale medir una curva de calibración. Nota el contexto comercial: la cuenta citada vende un producto de pronóstico y traza un paralelo con el suyo.
El fallo que este diseño invita
Un juez barato y repetible cambia el comportamiento. Cuando una decisión cuesta una fracción de centavo, los equipos dejan de muestrear y empiezan a evaluar todo, que es el punto de la cosa.
También significa que un juez equivocado en una dirección constante está ahora equivocado en todos lados, en silencio, a confianza máxima, en cada fila. La baja varianza empeora eso antes de mejorarlo, porque un error repetible se repite exactamente.
La mitigación no es glamorosa: mantén un conjunto oráculo etiquetado por humanos, re-mide la coincidencia cada vez que cambia una pregunta, y lee una muestra de lo que aprobó el juez en lugar de solo lo que rechazó.
Preguntas de confianza
¿La confianza es lo mismo que la probabilidad superior?
No. Las probabilidades describen el reparto entre tus opciones declaradas. La confianza es un valor aparte sobre qué tan seguro está el modelo en absoluto, y es el que usa el patrón de enrutamiento documentado.
¿Qué umbral debo usar?
El patrón publicado lo liga al coste de la acción: por debajo de 0.6 a una persona, 0.6 para acciones baratas, 0.6 a 0.85 con confirmación del usuario para las costosas, y por encima de 0.85 automáticamente. Luego mide tu propia curva.
¿Alguien lo encontró confiadamente equivocado?
No en el benchmark de 60 casos, donde cada fallo estaba matizado y el modelo nunca respondió mal con confianza máxima. Un profesional reportó probabilidades equivocadas con confianza en casos incognoscibles, sin publicar datos.
¿Ciyo usa enrutamiento por confianza?
No con Jev, que Ciyo no ejecuta. El patrón en sí — un juicio tipado más un umbral que decide si una persona mira — se aplica a cualquier evaluador, incluido un modelo de lenguaje actuando como revisor.
Sigue leyendo
Ciyo escribe sobre los modelos detrás de las herramientas creativas y de agentes, y prueba los que puede ejecutar.