Modelos · System One
Las opciones que declaras son todo el modelo
Con un modelo de lenguaje, una instrucción mala produce una frase mala y puedes verlo. Con un modelo de decisión tipado, una pregunta mala produce una respuesta perfectamente bien formada del tipo exactamente correcto, y no puedes ver nada malo en absoluto.
Esa es la trampa que vale la pena entender antes de conectar uno a nada. Dos piezas de evidencia de la semana del 17 de septiembre de 2026 — una una evaluación preregistrada, otra una ejecución de un practicante — apuntan a la misma conclusión desde direcciones distintas: la precisión que obtienes es en gran parte una propiedad de cómo escribiste las preguntas. Ciyo no ejecuta Jev; no produce imagen ni vídeo y no está en ninguno de nuestros registros de modelos.
Una pregunta, o cinco
La evidencia más directa publicada esta semana vino de un practicante ejecutando triaje de phishing. Formulada como una sola pregunta, la tarea obtuvo 62.6 por ciento. Dividida en cinco preguntas separadas, evaluada contra el mismo state y combinada en código, obtuvo 95 por ciento.
Esa es la ejecución de una persona sobre sus propias etiquetas sin un conjunto de datos publicado, así que es una razón para probar la división, no un número para citar. Pero coincide con lo que la propia documentación del proveedor recomienda — descomponer en preguntas atómicas de propósito único en lugar de pedir un juicio multifactor en una sola — y coincide con la forma de la API, donde cada pregunta en una llamada se evalúa en paralelo contra el mismo state.
La economía hace que la recomendación sea fácil de seguir. El costo que domina una llamada es enviar el state, no responder las preguntas. Preguntar cinco está casi gratis una vez que el state está en la línea.
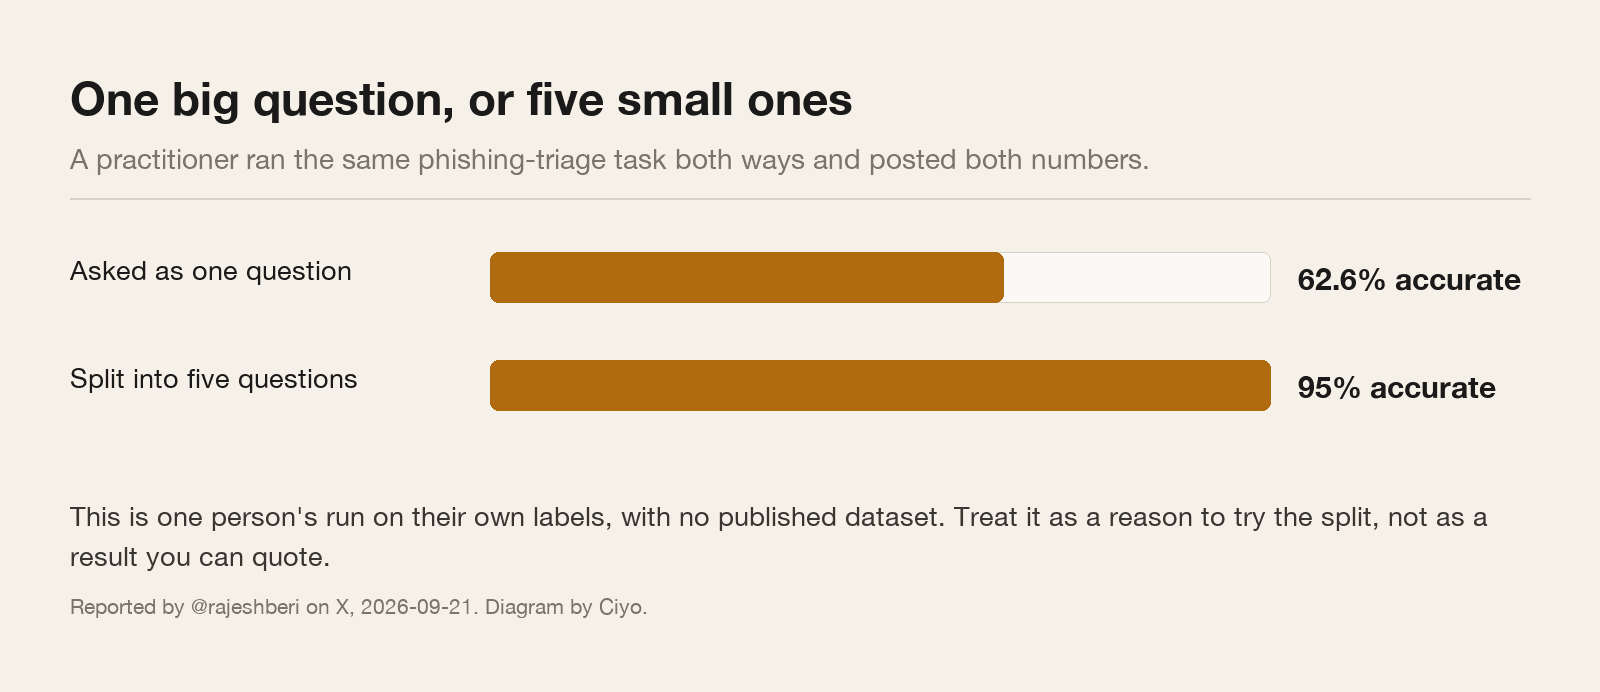
Publicado 2026-09-21. El autor reporta ambos números de su propia ejecución de triaje de phishing, añade que las probabilidades eran confiadamente equivocadas donde la respuesta era genuinamente incognoscible, y termina con el consejo correcto: pruébalo en sombra sobre tus propias etiquetas primero. No se publicó ningún conjunto de datos, así que las cifras son del propio autor.
Cómo dividir una pregunta que resiste la división
«¿Es este correo un intento de phishing» es una conclusión, no una pregunta. La división es preguntar por la evidencia que la haría verdadera, una pieza a la vez, y dejar que tu propio código haga la conclusión.
¿Coincide el dominio del remitente con la organización que dice ser? ¿Pide el mensaje una credencial o un pago? ¿Hay presión de tiempo en el redactado? ¿Coinciden los textos de enlaces visibles con sus destinos? ¿Es genérica la bienvenida donde este remitente normalmente usa un nombre?
Cinco preguntas estrechas, cinco respuestas con sus propios valores de confianza, y una regla en tu código que puedes leer, probar y cambiar sin tocar una instrucción. Esa última parte es el premio real: la lógica de combinación se vuelve software ordinario.
questions: {
  "sender_mismatch": { "type": "noul", "instructions": "El dominio del remitente no coincide con la organización de la que el mensaje afirma provenir." },
  "asks_for_secret": { "type": "noul", "instructions": "El mensaje pide al lector una contraseña, un código o un pago." },
  "time_pressure":   { "type": "noul", "instructions": "El mensaje presiona al lector a actuar rápidamente." },
  "link_mismatch":   { "type": "noul", "instructions": "Un texto de enlace visible difiere de adonde apunta realmente el enlace." },
  "risk":            { "type": "score", "instructions": "¿Qué tan arriesgado es entregar este mensaje a una bandeja de entrada?",
                        "criteria": ["inofensivo", "sospechoso", "probablemente phishing", "claramente malicioso"] }
}
Un nombre de opción es una etiqueta; los criterios son la definición
Un Choice toma un mapa `criteria` de nombres de opciones a descripciones, y un Score toma un arreglo ordenado de descripciones de niveles. Esas cadenas no son documentación para tus colegas. Son la única definición que tiene el modelo.
«facturación» le dice casi nada. «El remitente pregunta por una factura, un cargo que no reconoce, un reembolso o cambiar su método de pago» le dice qué buscar. La segunda versión es también la que puedes discutir con un colega antes de automatizar nada, que es el punto donde los desacuerdos son baratos.
Escribe los criterios como escribirías instrucciones para una persona nueva en su primer turno: qué pertenece aquí, qué se parece pero pertenece a otro lado, y qué hacer cuando no es ninguno.
La respuesta que no puede darte
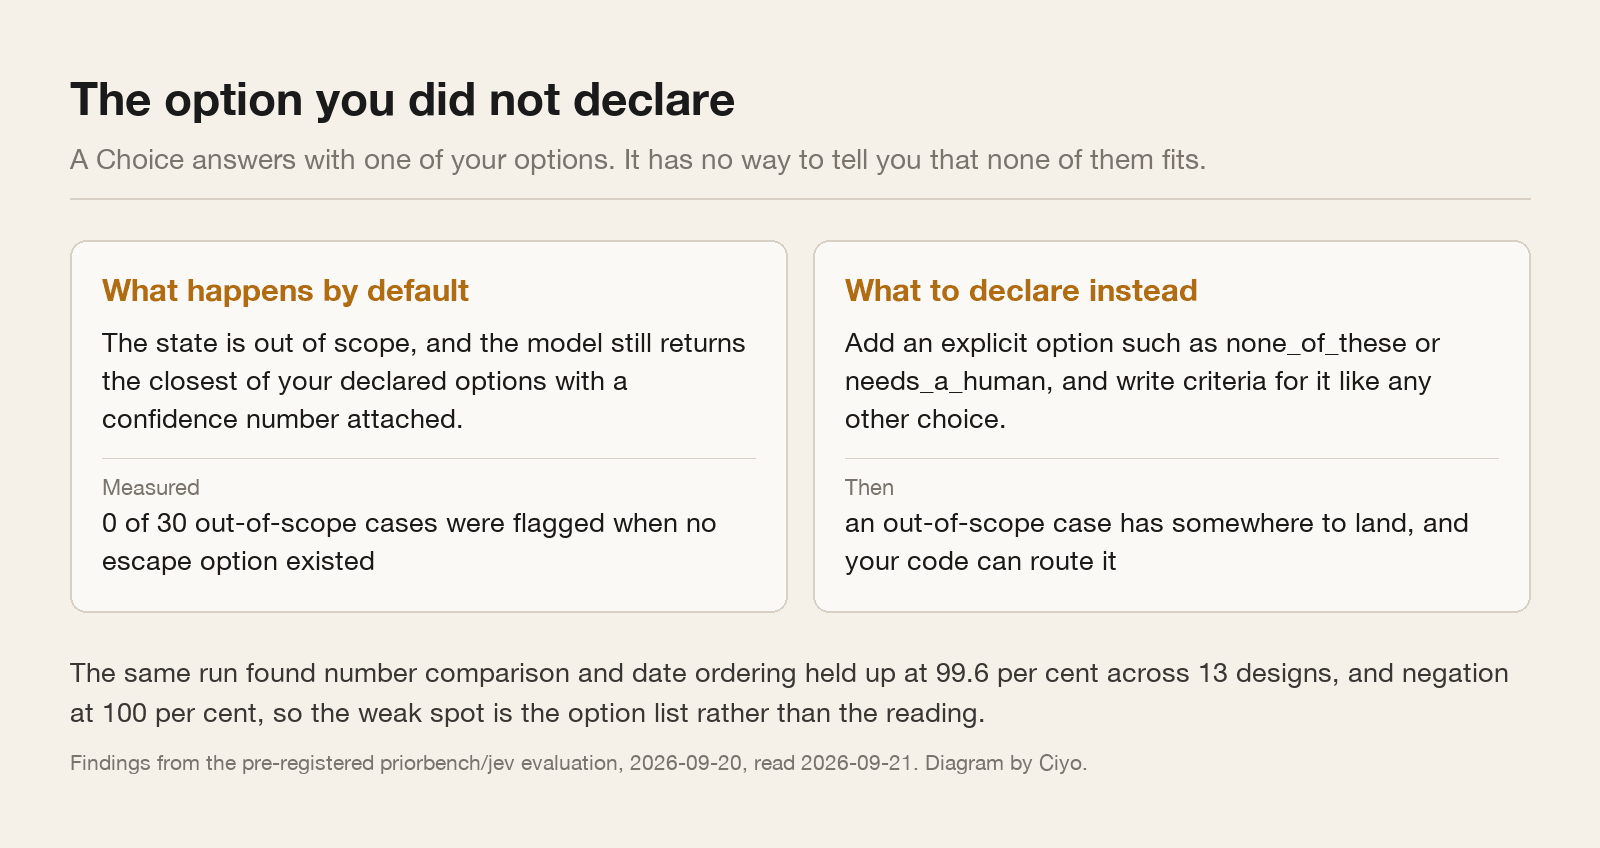
Ahora el hallazgo más agudo, y el que cambia un diseño. En la evaluación preregistrada publicada el 20 de septiembre de 2026, los autores probaron si el modelo señalaría que un state cayó fuera de las opciones declaradas. En 30 casos fuera de alcance donde no existía opción de escape, no señaló ninguno.
Eso no es un defecto. Es el sistema de tipos funcionando exactamente como se anuncia: declaraste las respuestas posibles, y volvió un valor del tipo declarado. Pero significa que una entrada fuera de alcance no falla ruidosamente. Tiene éxito en silencio, con la opción más cercana y un número de confianza adjunto.
La solución es una línea de diseño de preguntas. Declara tú mismo la opción de escape — `none_of_these`, `needs_a_human`, `not_applicable` — y escribe criterios para ella con tanto cuidado como para las opciones reales. Luego enrútala en código.
Lo que la misma evaluación encontró que hace bien
Vale la pena reportar la otra mitad, porque el folclore sobre estos modelos a menudo está equivocado en la dirección tranquilizadora y equivocado también en la dirección pesimista.
La misma ejecución encontró que la comparación de números y el orden de fechas se mantenían en 99.6 por ciento a través de 13 diseños distintos de preguntas, y la negación se manejó correctamente en 100 por ciento de los casos probados. Una guía de practicante publicada tres días antes había advertido que las negaciones pueden fallar y que el modelo es pobre en aritmética y fechas. La ejecución mayor, preregistrada, no reprodujo eso.
Lo cual es un recordatorio útil sobre todo este tema en septiembre de 2026: mucho consejo confiado circula sobre un modelo que ha sido público por menos de una semana. Prefiere la evidencia con un método y un repositorio adjuntos.
| Afirmación | Fuente | Lo que encontró la ejecución preregistrada |
|---|---|---|
| Pobre en cálculos aritméticos y de fechas | Una guía de practicante, 2026-09-17 | La comparación de números y el orden de fechas se mantuvieron en 99.6 por ciento a través de 13 diseños |
| Las negaciones pueden fallar | La misma guía | La negación se manejó correctamente en 100 por ciento de los casos probados |
| Putrefacción del contexto: la precisión cae con state irrelevante | La misma guía | No contradicho aquí; vale la pena probarlo en tu propio state |
| Lee las instrucciones literalmente | La misma guía | Consistente con el hallazgo fuera de alcance: responde la pregunta que escribiste |
Una lista de verificación antes de que una pregunta vaya a producción
¿Es atómica? Si la frase contiene «y» o «a menos que», probablemente son dos preguntas.
¿Son exhaustivas las opciones, incluyendo una de escape? Si una entrada plausible no tiene dónde aterrizar, aterrizará en un lugar equivocado.
¿Tiene criterios cada opción? Un nombre de opción es una etiqueta; los criterios son la definición, y el modelo solo tiene lo que escribiste.
¿Está ordenada la rúbrica? Un Score espera de dos a diez niveles que signifiquen algo en secuencia, y la puntuación devuelta puede caer entre ellos.
¿La has medido contra tus propias etiquetas? Cada número en este artículo vino de la tarea de otro.
Preguntas de diseño de preguntas
¿Por qué es mejor dividir una pregunta?
Cada pregunta se evalúa en aislamiento contra el mismo state, así que una pregunta estrecha es una tarea estrecha. La lógica de combinación vive entonces en tu código, donde es comprobable. Una ejecución de practicante pasó de 62.6 a 95 por ciento en sus propias etiquetas tras dividir.
¿Preguntar más cuesta más?
Muy poco. El costo dominante es el state que envías; las preguntas se evalúan en paralelo contra él.
¿Qué pasa con una entrada que no encaja en ninguna de mis opciones?
Obtiene la opción más cercana de todos modos. Una evaluación preregistrada encontró que 0 de 30 casos fuera de alcance señalados cuando no se declaró opción de escape. Declara una.
¿Es malo en fechas y negación?
Una guía de practicante lo dijo el 17 de septiembre de 2026. Una ejecución preregistrada mayor tres días después midió 99.6 por ciento en orden de números y fechas y 100 por ciento en negación. Pruébalo en tus propios datos en lugar de confiar en cualquiera.
Sigue leyendo
Ciyo escribe sobre los modelos detrás de las herramientas creativas y de agentes, y prueba los que puede ejecutar.